
Python argparse 怎样为命令行工具组织子命令
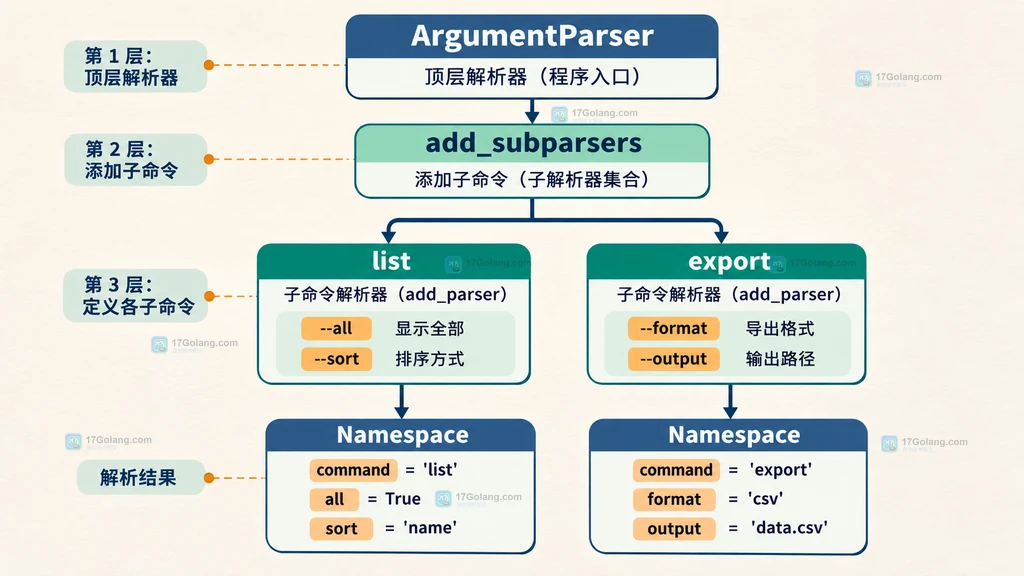
当命令行工具同时提供查询、导出、清理等操作时,把所有参数堆在一个 ArgumentParser 里很快会变得难以维护。更合适的做法是让顶层解析器只负责公共选项,再通过 add_subparsers() 注册多个子命令,每个子命令拥有自己的参数和处理函数。
本文围绕 list 与 export 两个命令展开,重点解决三个问题:子命令怎样定义、没有输入子命令时怎样给默认行为、-h 怎样同时提供总览和局部帮助。
官方文档:https://docs.python.org/3/library/argparse.html
先建立顶层解析器和子命令容器
add_subparsers() 返回一个子解析器集合,再通过它的 add_parser() 为每个命令创建独立解析器。公共参数应放在顶层,命令专属参数则放在对应的子解析器中。
import argparse

# 顶层解析器只描述工具本身和公共选项。
parser = argparse.ArgumentParser(
    prog="report",
    description="管理日报数据的命令行工具",
)
parser.add_argument("--verbose", action="store_true", help="显示更多运行信息")

# required=True 表示必须显式选择一个子命令。
subparsers = parser.add_subparsers(
    dest="command",
    title="子命令",
    description="选择要执行的操作",
    required=True,
)

# list 只接收自己的筛选参数。
list_parser = subparsers.add_parser("list", help="列出日报")
list_parser.add_argument("--date", help="按日期筛选,例如 2026-11-16")

# export 只接收自己的输出参数。
export_parser = subparsers.add_parser("export", help="导出日报")
export_parser.add_argument("output", help="导出文件路径")

args = parser.parse_args()
print(args.command, args)
这里的 dest="command" 会把被选中的命令名保存到 Namespace.command。如果不设置 dest,解析器仍然能根据子解析器处理参数,但结果对象里不会自动保留命令名。
用 set_defaults 把子命令绑定到处理函数
只解析出参数还不够,命令行工具还需要知道下一步调用哪段业务代码。推荐给每个子解析器设置一个 func 默认值,解析完成后统一调用它。这样可以避免在主函数里写一长串 if/elif。
def list_reports(args):
    # 没有日期时由业务层决定默认查询范围。
    scope = args.date or "最近一天"
    print(f"列出{scope}的日报")


def export_reports(args):
    # 输出路径来自 export 子命令的必填位置参数。
    print(f"导出日报到 {args.output}")


parser = argparse.ArgumentParser(prog="report")
subparsers = parser.add_subparsers(dest="command", required=True)

list_parser = subparsers.add_parser("list", help="列出日报")
list_parser.add_argument("--date", help="筛选日期")
# 选择 list 后,Namespace 会携带这个处理函数。
list_parser.set_defaults(func=list_reports)

export_parser = subparsers.add_parser("export", help="导出日报")
export_parser.add_argument("output", help="目标文件")
# 选择 export 后覆盖为另一个处理函数。
export_parser.set_defaults(func=export_reports)

args = parser.parse_args()
# 子解析器已经完成路由,主流程只需调用统一入口。
args.func(args)
set_defaults() 设置的是解析结果中的默认属性,不是把函数立即执行。parse_args() 返回后再调用 args.func(args),可以让参数解析和业务逻辑保持分离。
没有子命令时怎样设置默认命令
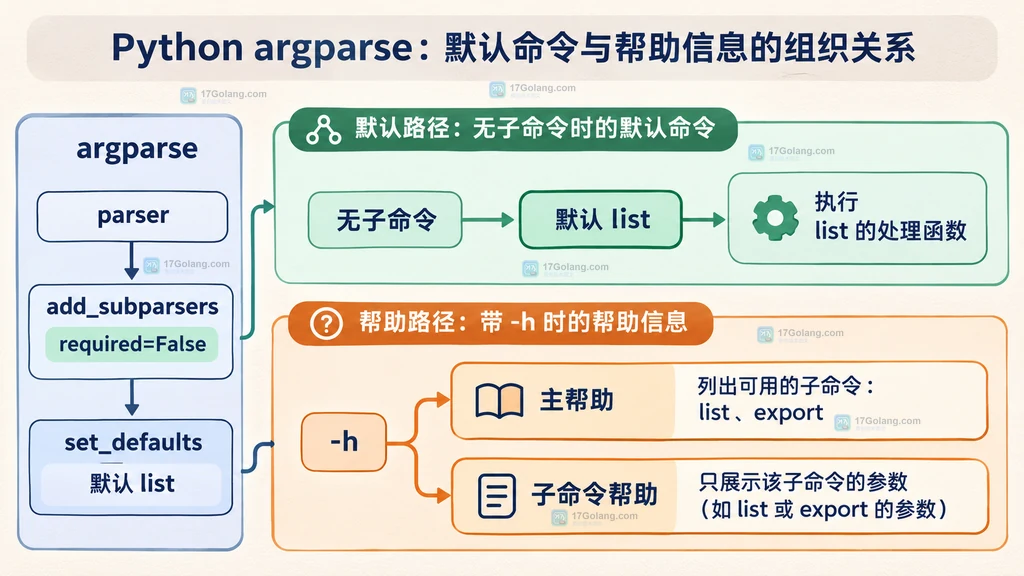
required=True 适合每次都必须明确操作的工具;如果希望直接运行工具时默认执行 list,就不要把子解析器设为必选。可以在顶层先放入默认的 command 和 func,选中具体子命令后,子解析器自己的默认值会覆盖它们。
def list_reports(args):
    # 默认命令也走同一个业务函数,避免出现两套逻辑。
    print(f"列出日报,日期={args.date or '最近一天'}")


def export_reports(args):
    # export 命令提供自己的输出路径。
    print(f"导出到 {args.output}")


parser = argparse.ArgumentParser(prog="report")
# 顶层默认值覆盖“没有输入子命令”的情况。
parser.set_defaults(command="list", func=list_reports, date=None)
subparsers = parser.add_subparsers(dest="command", required=False)

list_parser = subparsers.add_parser("list", help="列出日报")
list_parser.add_argument("--date", help="筛选日期")
list_parser.set_defaults(func=list_reports)

export_parser = subparsers.add_parser("export", help="导出日报")
export_parser.add_argument("output", help="目标文件")
export_parser.set_defaults(func=export_reports)

args = parser.parse_args()
# 无参数时使用顶层默认值,有子命令时使用子解析器覆盖的函数。
args.func(args)
这段设计的关键是 required=False。如果仍然使用 required=True,解析器会在业务函数运行前因为缺少子命令而退出。默认命令并不是 argparse 自动替你选择的功能,而是通过顶层默认值或预处理参数列表明确表达出来的策略。
让主帮助和子命令帮助各司其职
argparse 会根据解析器树自动生成帮助信息。运行 report -h 时,读者应先看到工具说明、公共参数和子命令目录;运行 report export -h 时,只需要看到 export 的位置参数和选项。
为子解析器传入 help,可以让它出现在主帮助的命令目录中;为 add_subparsers() 传入 title 和 description,可以让这一组命令在帮助中有独立标题。
parser = argparse.ArgumentParser(
    prog="report",
    description="读取和导出团队日报",
    epilog="示例:report list --date 2026-11-16",
)

# 标题和说明让命令目录在帮助中更容易被读者找到。
subparsers = parser.add_subparsers(
    dest="command",
    title="可用子命令",
    description="每次选择一个操作",
)

# help 是主帮助中的短说明,description 可以放在子命令自己的帮助里。
list_parser = subparsers.add_parser(
    "list",
    help="列出日报",
    description="按日期查看日报列表",
)
list_parser.add_argument("--date", help="筛选日期")

export_parser = subparsers.add_parser(
    "export",
    help="导出日报",
    description="把日报写入指定文件",
)
export_parser.add_argument("output", help="目标文件路径")
帮助文本里的 help 更像命令目录摘要,description 则适合解释进入该命令后的用途。两者都应该短而具体,避免把业务文档整段塞进命令行帮助。
几个容易混淆的参数边界
| 需求 | 适合的设置 | 结果 |
|---|---|---|
| 必须选择命令 | add_subparsers(required=True) | 缺少子命令时由 argparse 报错 |
| 允许直接运行 | required=False 加顶层默认值 | 无子命令时走预设处理函数 |
| 记录命令名 | dest="command" | 结果对象保存被选中的子命令 |
| 路由业务函数 | 子解析器 set_defaults(func=...) | 解析完成后统一调用 args.func(args) |
| 兼容旧命令名称 | add_parser(..., aliases=[...]) | 多个名称进入同一个子解析器 |
特别要注意参数归属:顶层选项通常写在子命令之前,子命令选项写在对应命令之后。不要为了“方便”把所有参数都放在顶层,否则每个命令的帮助会变长,参数冲突也更难定位。
总结
用 argparse 组织子命令可以记住一条主线:顶层 ArgumentParser 放公共配置,add_subparsers() 建立命令入口,add_parser() 隔离每个命令的参数,set_defaults() 负责把结果路由到函数。是否允许无子命令运行,则由 required 和顶层默认值共同决定。
常见问题
为什么设置了 dest 后还要给每个子解析器设置 func?
dest 只保存命令名称,不会自动找到业务函数。set_defaults(func=...) 才是把某个子命令和处理函数关联起来的明确方式。
默认命令能不能直接把 required 设置为 True?
不能同时依赖这两个设置实现“无输入时默认执行”。required=True 会先拒绝缺少子命令的输入;需要默认命令时,应允许缺省并设置顶层默认处理函数。
子命令帮助为什么看不到其他命令的参数?
这是正常行为。主解析器的 -h 展示命令目录,具体子命令的 -h 只展示当前解析器和它继承到的参数,避免帮助信息相互干扰。
 Python pathlib.relative_to 怎样避免无关路径抛错
- 上一篇
- Python pathlib.relative_to 怎样避免无关路径抛错
- 下一篇
- Python sqlite3.complete_statement 判断多语句输入完整性的处理方案
-
- 文章 · python教程 | 7分钟前 | Python SQLite sqlite3 getlimit Connection.setlimit
- Python sqlite3.Connection.setlimit 怎样限制单个连接的资源上限
- 247浏览 收藏
-
- 文章 · python教程 | 17分钟前 | SQLite · Python教程 · Python SQLite sqlite3 complete_statement 多语句脚本 CREATE TRIGGER
- Python sqlite3.complete_statement 判断多语句输入完整性的处理方案
- 140浏览 收藏
-
- 文章 · python教程 | 22分钟前 | python · pathlib · Python pathlib walk_up relative_to
- Python pathlib.relative_to 怎样避免无关路径抛错
- 256浏览 收藏
-
- 文章 · python教程 | 22分钟前 | python · Python Property 描述符 inspect.getattr_static 静态属性读取
- Python 怎样读取属性定义而不触发 property
- 299浏览 收藏
-
- 文章 · python教程 | 38分钟前 | 依赖管理 · 故障排查 · Python教程 · Python importlib.metadata packages_distributions 发行包 导入名
- Python 怎样根据导入名查询对应的发行包
- 138浏览 收藏
-
- 文章 · python教程 | 55分钟前 | 数据校验 · Python教程 · Python Pydantic JSON校验 model_validate_json strict mode
- Pydantic model_validate_json 怎样在严格模式下解析请求体
- 417浏览 收藏
-
- 文章 · python教程 | 59分钟前 |
- Python hmac.compare_digest 的类型约束与摘要校验边界
- 235浏览 收藏
-
- 文章 · python教程 | 1天前 |
- Python 3.14 pathlib.PurePath.full_match怎样匹配完整路径
- 443浏览 收藏
-
- 文章 · python教程 | 1天前 |
- Python os.reload_environ为什么读取不到外部环境变量
- 283浏览 收藏
-
- 文章 · python教程 | 1天前 |
- Python operator.is_none 怎样判断值是否为 None
- 229浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1057次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1057次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1221次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1163次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1005次使用
-
- Golang如何快速构建一个CLI小工具详解
- 2022-12-22 345浏览
-
- 玩转Go命令行工具Cobra
- 2022-12-31 364浏览
-
- Go语言中使用urfave/cli命令行框架
- 2022-12-31 386浏览
-
- 在 Golang 中使用 Cobra 创建 CLI 应用
- 2023-01-07 141浏览
-
- Golang中基础的命令行模块urfave/cli的用法说明
- 2023-01-07 179浏览


