
Java Files.lines 怎样遍历大文件并确保流关闭
遍历大文本文件时,Files.lines(path) 更适合“读一行、处理一行”的场景。它返回的是惰性 Stream,不会像 Files.readAllLines(path) 那样先把所有行装进 List。但这个 Stream 背后仍然持有打开的文件,所以必须把整个流放进 try-with-resources,不能只写一个看起来简洁的链式表达式。
官方文档:https://docs.oracle.com/en/java/javase/25/docs/api/java.base/java/nio/file/Files.html
本文只围绕四个边界展开:惰性消费、资源关闭、字符集和异常传播。掌握后,下面这种结构就是处理大文件的默认起点:
try (Streamlines = Files.lines(path, StandardCharsets.UTF_8)) { lines.forEach(this::handleLine); }
先分清 Files.lines 与 readAllLines
Files.lines 返回 Stream,只有发生终端操作时才会持续读取文件;Files.readAllLines 返回 List,需要先完成整次读取。前者适合边读边处理,后者适合文件很小、后续确实需要随机访问所有行的情况。
| 方法 | 返回值 | 读取方式 | 资源边界 |
|---|---|---|---|
Files.lines | Stream | 惰性消费 | 关闭 Stream 才关闭文件 |
Files.readAllLines | List | 一次读完 | 方法完成或失败时由 API 关闭 |
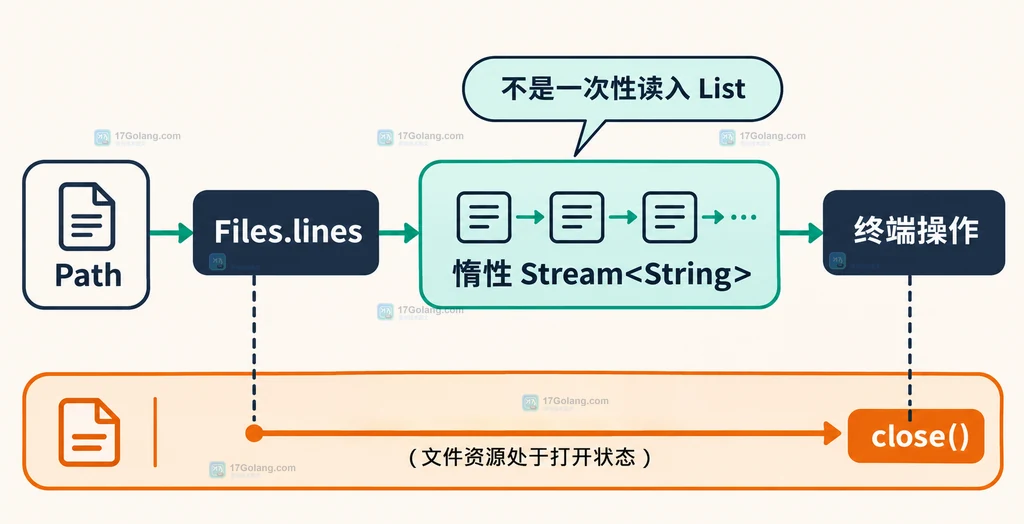
因此,“文件很大”并不等于必须把处理逻辑写成复杂的缓冲区循环。只要每一行的处理不把结果再次全部收集到内存,Stream 结构就能保持稳定的内存占用趋势。需要注意的是,lines.collect(toList()) 又会把结果收集回来,等于重新引入了内存压力。
用 try-with-resources 包住整个 Stream
文件在调用 Files.lines 时打开,返回的 Stream 保存着对打开文件的引用。官方 API 明确要求使用 try-with-resources 或类似控制结构,确保终端操作完成后及时关闭。
正确写法是让 Stream 成为资源变量,并把所有消费动作放到资源块里:
Path path = Path.of("access.log");

try (Stream lines = Files.lines(path, StandardCharsets.UTF_8)) {
    // 终端操作必须在资源块内,避免消费已关闭的文件
    lines.filter(line -> !line.isBlank())
         .forEach(line -> System.out.println(line));
} catch (IOException e) {
    // 打开文件或关闭资源失败时,交给调用方决定是否重试
    throw new UncheckedIOException("读取日志文件失败: " + path, e);
}
不要把 Stream 提前返回给外层,也不要在 try 块结束后再调用 count、forEach 或其他终端操作。那样会把“资源已经关闭”和“流还想继续读取”拆成两个生命周期,最终只能得到不可用的对象。
按文件编码选择重载方法
Files.lines(path) 按 UTF-8 解码;如果文件来自明确使用 GBK、ISO-8859-1 或其他编码的系统,应传入对应的 Charset。编码错误不是普通的业务过滤问题,应该在读取边界尽早暴露。
Charset charset = Charset.forName("GB18030");

try (Stream lines = Files.lines(path, charset)) {
    // 显式指定编码,避免依赖运行环境的默认设置
    lines.forEach(this::handleLine);
} catch (IOException e) {
    // 文件尚未正常打开或关闭失败时,保留原始异常作为 cause
    throw new UncheckedIOException("无法打开或关闭文件: " + path, e);
}
这里的重点不是把字符集写得越多越好,而是让文件生产方和读取方对编码达成约定。若只在本机测试中使用默认 UTF-8,换到另一套数据源后才发现中文乱码,定位成本会明显上升。
区分打开异常与读取异常
Files.lines 方法声明会抛出 IOException,它常见于打开文件阶段。但因为读取是惰性的,后续 I/O 异常或解码异常可能发生在 Stream 已经返回之后。Java API 会把这类异常包装成 UncheckedIOException,从触发读取的 Stream 操作中抛出。
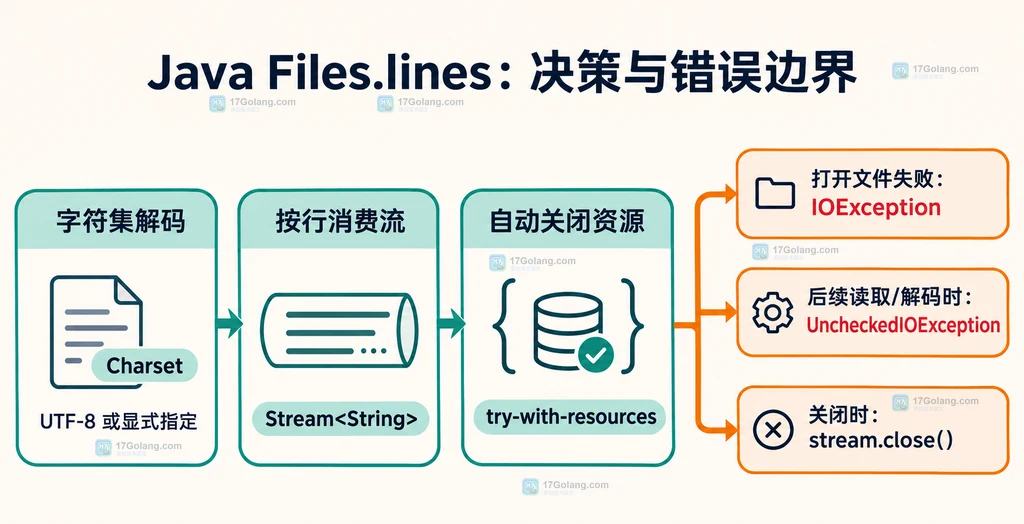
因此只捕获 IOException 并不能覆盖所有读取失败路径。若业务需要统一转换异常,可以同时处理两层:
try (Streamlines = Files.lines(path, StandardCharsets.UTF_8)) { // 消费阶段的解码或 I/O 问题可能以 UncheckedIOException 出现 lines.forEach(this::handleLine); } catch (UncheckedIOException e) { // 先保留 cause,便于上层记录真实的 I/O 原因 throw new IllegalStateException("读取过程中发生 I/O 异常: " + path, e.getCause()); } catch (IOException e) { // 处理打开文件或关闭文件阶段的受检异常 throw new IllegalStateException("文件资源不可用: " + path, e); }
不要把 UncheckedIOException 当成“代码一定写错了”。它是惰性读取把受检 I/O 异常带过 Stream API 的结果,关键是区分发生阶段并保留原始 cause。
用一个可落地的遍历模板收尾
下面的模板给每一行编号,只处理包含 ERROR 的非空行。它没有收集全部内容,也没有把 Stream 泄漏到方法外,适合作为批处理或日志扫描的最小骨架。
static void scan(Path path) {
    try (Stream lines = Files.lines(path, StandardCharsets.UTF_8)) {
        // 计数器只服务当前遍历,不把所有行复制到内存
        AtomicLong lineNumber = new AtomicLong(0);
        lines.map(line -> new LineRecord(lineNumber.incrementAndGet(), line))
             .filter(record -> !record.text().isBlank())
             .filter(record -> record.text().contains("ERROR"))
             .forEach(record -> handleError(record));
    } catch (UncheckedIOException e) {
        // 消费期间的 I/O 异常通过 cause 传递给上层
        throw new UncheckedIOException("扫描文件时读取失败: " + path, e.getCause());
    } catch (IOException e) {
        // 打开或关闭失败时,统一转换成调用方可识别的异常
        throw new UncheckedIOException("扫描文件资源失败: " + path, e);
    }
}

record LineRecord(long number, String text) {}

static void handleError(LineRecord record) {
    // 实际项目中可以写入队列或统计对象,避免在这里累积全部正文
    System.out.println(record.number() + ": " + record.text());
}
这段代码的边界很明确:Path 和字符集在入口确定,Stream 只在资源块中消费,异常在同一处转换。如果每行处理本身很重,可以把结果写入下游或批量提交,但不要为了“方便”把全部行收集成 List。
当你需要逐行读取且希望显式控制缓冲、读取器方法或更复杂的 checked exception 时,可以改用 Files.newBufferedReader;它同样要用 try-with-resources。Files.lines 的优势在于表达“惰性行流”,而不是替代所有文件读取 API。
常见问题
Files.lines 会一次性把大文件读入内存吗?
不会。它按 Stream 消费进度惰性读取;但如果后面调用 collect、toList 等收集操作,结果仍可能占用大量内存。
为什么 Files.lines 需要手动关闭?
因为返回的 Stream 持有打开的文件,关闭 Stream 才会关闭文件。最直接的方式是把它声明在 try-with-resources 中。
只捕获 IOException 够吗?
不一定。打开阶段是 IOException,惰性消费阶段的 I/O 或解码问题可能包装为 UncheckedIOException,应按业务边界同时处理。
 Java Optional.filter 按业务条件保留值的链式处理方案
- 上一篇
- Java Optional.filter 按业务条件保留值的链式处理方案
- 下一篇
- Java ReentrantLock.hasQueuedThreads 怎样判断是否有线程排队
-
- 文章 · java教程 | 19分钟前 |
- Java Formatter 怎样控制十六进制输出的宽度和补零
- 492浏览 收藏
-
- 文章 · java教程 | 23分钟前 | 并发编程 · Java教程 · java 锁竞争 reentrantlock hasQueuedThreads 并发监控
- Java ReentrantLock.hasQueuedThreads 怎样判断是否有线程排队
- 490浏览 收藏
-
- 文章 · java教程 | 32分钟前 | Java教程 · Optional · java map optional predicate orElseThrow Optional.filter
- Java Optional.filter 按业务条件保留值的链式处理方案
- 234浏览 收藏
-
- 文章 · java教程 | 35分钟前 | java Stream linkedhashmap Collectors groupingBy
- Java Stream 怎样按多个字段分组并保留顺序
- 360浏览 收藏
-
- 文章 · java教程 | 37分钟前 | 正则表达式 · Java教程 · java 正则表达式 pattern 命名捕获组 Matcher.group
- Java Pattern 命名捕获组怎样按名称读取匹配结果
- 128浏览 收藏
-
- 文章 · java教程 | 40分钟前 | unicode · java stringbuilder unicode reverse UTF-16 代理项
- Java StringBuilder.reverse 怎样避免 Unicode 代理项被拆开
- 331浏览 收藏
-
- 文章 · java教程 | 43分钟前 | java SequencedCollection reversed 正向遍历 反向视图
- Java SequencedCollection 怎样从同一个集合获取正向和反向视图
- 380浏览 收藏
-
- 文章 · java教程 | 47分钟前 |
- Java 模式匹配 switch 怎样处理 null 分支
- 487浏览 收藏
-
- 文章 · java教程 | 47分钟前 | java 变量作用域 instanceof 类型收窄 record pattern 模式变量
- Java record pattern 与 instanceof 的变量作用域和类型收窄方法
- 310浏览 收藏
-
- 文章 · java教程 | 48分钟前 | 虚拟线程 · java threadlocal 阻塞IO 虚拟线程 Virtual Thread
- Java 虚拟线程怎样判断阻塞调用是否适合迁移
- 133浏览 收藏
-
- 文章 · java教程 | 52分钟前 |
- Java Collections.checkedList 怎样让错误类型尽早暴露
- 439浏览 收藏
-
- 文章 · java教程 | 54分钟前 | 工程实践 · java 集合 Deque ArrayDeque removeFirstOccurrence
- Java ArrayDeque.removeFirstOccurrence 怎样删除首个匹配元素
- 380浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1056次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1056次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1220次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1162次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1005次使用
-
- Go微服务项目配置文件的定义和读取示例详解
- 2023-01-08 298浏览
-
- golang HTTP 服务器 处理 日志/Stream流的操作
- 2023-01-07 289浏览
-
- Go os.ReadFile 读取超大配置为何会放大内存:改用 Reader 的分块解析实践
- 2026-08-28 307浏览
-
- Go io.NewSectionReader 怎么读取文件切片:Offset、Seek 与越界返回
- 2026-08-28 439浏览
-
- Go archive/zip 怎么读取大文件而不一次载入内存
- 2026-09-08 385浏览


