
Transformers tokenizer 怎样让 padding 与 truncation 对齐批量输入
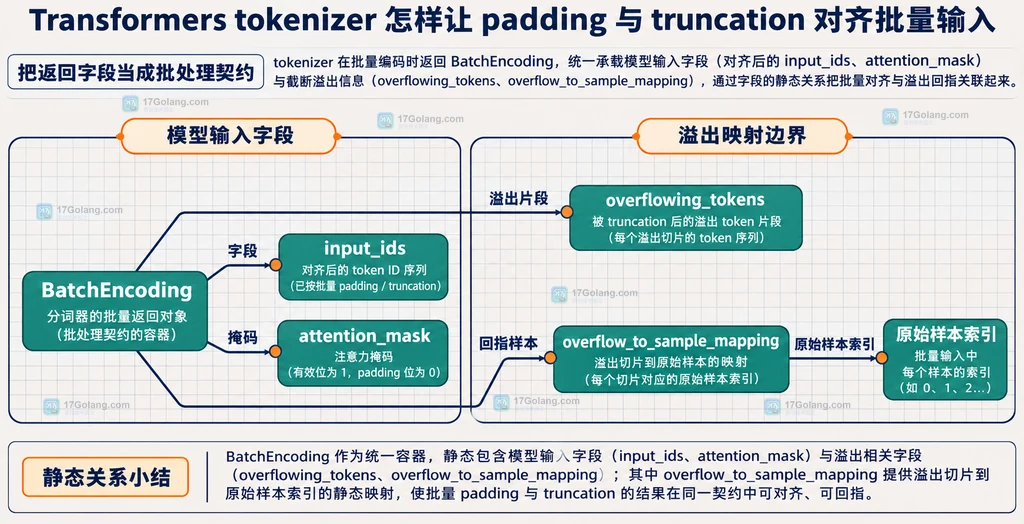
Transformers tokenizer 处理一批长短不一的文本时,关键不是把字符串列表直接传进去,而是先决定“每条样本最终要占多少 token”。通常的组合是:用 truncation 截掉超长部分,再用 padding 把短样本补到批次最长长度或指定的 max_length,这样 input_ids 和 attention_mask 才能组成形状一致的批量输入。
官方地址:https://huggingface.co/docs/transformers/main/en/pad_truncation
下面用一个不依赖具体模型名称的 Python 示例说明参数关系。代码是写法示意,不包含密钥,也不在本文中执行模型推理。
批量输入为什么必须先统一长度
单条文本可以保留自己的 token 长度,但一批文本要送进张量时,通常需要一个矩形结构。假设三条文本编码后分别有 5、8、12 个 token,直接拼成批量张量就会遇到长度不同的问题。
truncation=True:当样本超过上限时,从 token 序列中截去超出的部分。padding=True或padding='longest':补到当前批次最长样本的长度。padding='max_length':补到max_length指定的长度;若没有指定,则使用 tokenizer 或模型可接受的最大长度。
我处理批量输入时,会先把“截断上限”和“补齐目标”写清楚,再选择参数。只打开 padding 而不打开 truncation,长文本仍然可能超过模型可接受长度;只打开 truncation 而不打开 padding,批次内的序列仍可能长短不一。
先用最小参数让字段长度对齐
对大多数普通批量文本,下面这一组参数足够作为起点:padding=True、truncation=True,并把需要的最大长度显式写成 max_length。返回对象通常是 BatchEncoding,其中至少会有模型需要的 input_ids,并可能包含 attention_mask、token_type_ids 等字段。
from transformers import AutoTokenizer

# 使用项目实际采用的 tokenizer;模型名称只作为示例占位。
tokenizer = AutoTokenizer.from_pretrained("bert-base-chinese")

sentences = [
    "padding 负责把批次中的短序列补齐",
    "truncation 负责限制过长序列",
    "max_length 把长度上限写成明确的批处理契约",
]

batch = tokenizer(
    sentences,
    padding=True,          # 补到当前批次最长序列,适合动态批处理。
    truncation=True,       # 超过上限的序列要先截断,避免输入超过模型边界。
    max_length=32,         # 同时约束截断上限;具体值应按模型和任务决定。
    return_tensors="pt",  # 需要直接交给 PyTorch 时返回张量,否则可省略。
)

# 只检查形状,不把具体 token 数写死到业务逻辑里。
if batch["input_ids"].shape != batch["attention_mask"].shape:
    raise ValueError("input_ids 与 attention_mask 的形状没有对齐")
这里的重点不是 32 这个数字,而是同一批调用中让 tokenizer 同时处理截断和补齐。attention_mask 会标记哪些位置是有效 token,哪些位置是 padding;把它和 input_ids 分开保存或传参,容易造成字段错位。
padding 的三种选择怎么取舍
Transformers 文档把 padding 分成几种策略,实际项目可以按场景选择:
| 写法 | 长度目标 | 适合场景 |
|---|---|---|
padding=True | 当前批次最长序列 | 动态推理、长度差异较大的普通批次 |
padding='max_length' | max_length 或模型上限 | 需要固定输入形状的训练或导出流程 |
padding=False | 不补齐 | 只想查看单条编码,或由后续 collator 统一处理 |
动态 padding 往往减少无意义的 pad token,但每个批次的形状可能不同;固定 padding 更容易接入静态图或固定形状的下游组件,却可能增加计算量。不要把“更长的固定长度”误认为“更准确”,它只是改变了批次的形状和 padding 数量。
如果硬件或下游算子希望长度是某个倍数,可以在已开启 padding 的前提下增加 pad_to_multiple_of:
batch = tokenizer(
    sentences,
    padding=True,
    truncation=True,
    max_length=32,
    pad_to_multiple_of=8,  # 让最终长度向上补到 8 的倍数,前提是已开启 padding。
    return_tensors="pt",
)
truncation 与 max_length 要一起看
max_length 不是单独的“截断开关”,它需要和 truncation 或 padding='max_length' 组合起来才有明确作用。只写 max_length=128,并不等于所有输入都会自动截断或补到 128。
单序列任务通常使用 truncation=True。如果输入是句子对,才需要进一步考虑 only_first、only_second 或 longest_first:它们决定哪一侧承担截断责任。成对文本不要为了“看起来整齐”随意改成单序列策略,否则可能把问题描述或候选答案的一侧截得过多。
pairs = [
    ("用户问题:如何统一长度", "任务:说明 padding 与 truncation"),
    ("用户问题:如何检查字段", "任务:说明 attention_mask 的作用"),
]

pair_batch = tokenizer(
    pairs,
    padding="max_length",       # 成对输入也使用同一个固定补齐目标。
    truncation="only_second",   # 只让第二段承担截断,适用于第一段必须保留的任务。
    max_length=48,
    return_tensors="pt",
)

# 先确认批次维度,再把结果传给模型;错误要尽早暴露。
if pair_batch["input_ids"].ndim != 2:
    raise ValueError("批量 input_ids 应该是二维结构")
把返回字段当成批处理契约
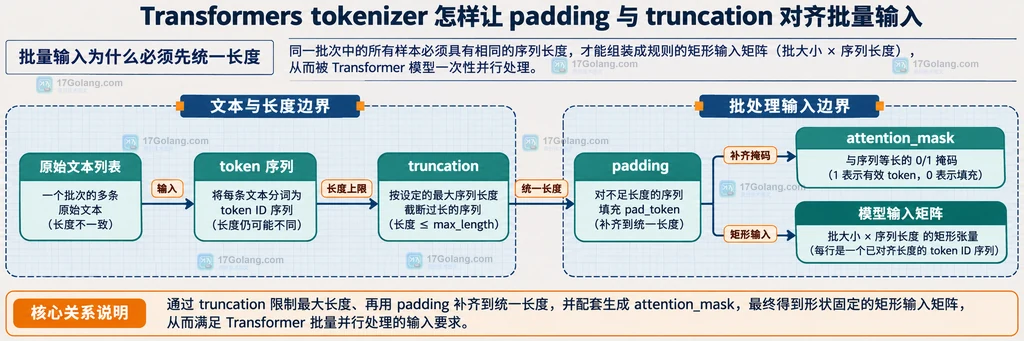
一个常见误区是只看 input_ids 是否存在。批量编码实际还要看 tokenizer 返回的其他字段是否与它同批、同长度。attention_mask 说明模型应该关注哪些 token;某些模型还会需要 token_type_ids。具体字段由 tokenizer 和模型的输入约定决定,不能把一个模型返回的字段列表硬套到另一个模型。
encoded = tokenizer(
    sentences,
    padding="max_length",
    truncation=True,
    max_length=16,
    return_attention_mask=True,       # 明确要求返回注意力掩码。
    return_length=True,               # 让每条编码带上长度信息,便于记录。
    return_overflowing_tokens=True,   # 超长样本切片时保留溢出关系。
)

input_rows = encoded["input_ids"]
mask_rows = encoded["attention_mask"]
lengths = encoded["length"]

# 每个输入行都要和对应的 mask、length 行数一致。
if not (len(input_rows) == len(mask_rows) == len(lengths)):
    raise ValueError("BatchEncoding 的字段行数不一致")

# 发生溢出切片时,用映射表找回原始样本,不能按当前行号猜测。
mapping = encoded.get("overflow_to_sample_mapping", [])
if mapping and any(index = len(sentences) for index in mapping):
    raise ValueError("overflow_to_sample_mapping 包含无效的原始样本索引")
开启溢出返回后,一条长文本可能对应多个编码行,所以不能再假设“编码行号就等于输入列表下标”。只要业务需要把分类结果、标签或原文片段写回,就应保留 overflow_to_sample_mapping 这类映射关系。
padding_side 和模型输入方向不要混为一谈
tokenizer 还存在 padding_side 和 truncation_side 这样的方向设置。它们影响补齐或截断发生在序列的左侧还是右侧。大多数编码任务可以使用 tokenizer 的默认值;只有当模型或生成任务明确要求左侧补齐、或者业务需要保留某一侧 token 时,才应在项目配置中显式记录。
一个稳妥的配置对象应该同时保存 tokenizer 名称、padding、truncation、max_length、方向设置和返回字段。这样离线预处理、在线推理和回归样本不会因为调用方各写一套默认值而产生不同形状。
批量 tokenizer 的落地清单
- 输入是否明确是单条字符串、字符串列表还是句子对?
- 是否同时决定了 padding 策略和 truncation 策略?
max_length是否对应当前 tokenizer 和模型的输入上限?input_ids、attention_mask和可选字段的行数、列数是否对齐?- 启用 overflow 后,是否使用原始样本映射而不是猜测行号?
- 训练、推理和导出流程是否共用同一份 tokenizer 参数配置?
真正可靠的批量输入,不是所有样本都被补成一个很大的长度,而是每个长度决定都有记录、每个返回字段都能对应回原始样本。先用 padding=True 与 truncation=True 建立基本契约,再按固定形状、句子对或溢出切片的需求逐项增加参数,通常比一次把所有选项都打开更容易排错。
相关问题
只设置 padding=True 为什么仍可能报长度错误?
因为它只负责把短序列补齐,不负责截断超过模型上限的长序列。需要同时设置 truncation=True,必要时再给出明确的 max_length。
padding=True 和 padding='max_length' 有什么区别?
前者通常补到当前批次最长样本,后者补到指定的 max_length 或模型上限。前者更节省无效计算,后者更适合固定形状的下游流程。
开启 overflow 后如何知道切片来自哪条原文?
使用 tokenizer 返回的 overflow_to_sample_mapping,它把每个编码行映射回原始输入样本。不要把编码行号直接当成原始列表下标。
 Hugging Face Datasets DatasetDict 跨 train 与 validation 的 map 处理方案
- 上一篇
- Hugging Face Datasets DatasetDict 跨 train 与 validation 的 map 处理方案
- 下一篇
- Gemini API 怎样把文件输入和文本提示放在同一请求
-
- 科技周边 · 人工智能 | 10分钟前 | 多模态输入 Gemini API Files API MIME 类型
- Gemini API 怎样把文件输入和文本提示放在同一请求
- 164浏览 收藏
-
- 科技周边 · 人工智能 | 11分钟前 |
- Hugging Face Datasets DatasetDict 跨 train 与 validation 的 map 处理方案
- 267浏览 收藏
-
- 科技周边 · 人工智能 | 16分钟前 | 人工智能 · 结构化输出 · JSON Schema Responses API Structured Outputs strict refusal
- 结构化输出怎样约束模型返回 JSON Schema
- 328浏览 收藏
-
- 科技周边 · 人工智能 | 21分钟前 | 人工智能 · openai · 工具调用 Responses API function_call_output call_id
- Responses API 怎样处理工具调用后的继续响应
- 156浏览 收藏
-
- 科技周边 · 人工智能 | 21分钟前 | 人工智能 · openai · 多轮对话 Responses API conversation state OpenAI API previous_response_id
- Responses API 怎样用上一轮响应继续多轮对话
- 121浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- GPT-Live双工语音会话接入后端
- 470浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | 人工智能 · 文本生成 Transformers 重复片段 no_repeat_ngram_size GenerationConfig
- Transformers 怎样用 no_repeat_ngram_size 减少重复片段
- 493浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | python · 人工智能 · OpenAI session Agents SDK SQLiteSession conversation_id
- OpenAI Agents API保存持久会话
- 414浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- Transformers在vLLM中部署生成模型
- 122浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- Transformers datasets流式读取训练数据
- 275浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1054次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1054次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1219次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1161次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1004次使用
-
- CodeGeeX for Jetbrains IDEs正式上线!
- 2023-01-17 284浏览
-
- 技术阿里云实现ocr批量图片和pdf文件表格图片转换excel文档/支持票据图片提取/普通图片文字提取处理
- 2023-01-18 387浏览
-
- 直播预告|FeatureStore Meetup V2
- 2023-01-10 328浏览
-
- 深入浅出特征工程 – 基于 OpenMLDB 的实践指南(上)
- 2023-02-25 426浏览
-
- 开源机器学习数据库OpenMLDB v0.4.0产品介绍
- 2023-01-10 147浏览


