
IndexedDB 游标方向怎样影响遍历顺序
我第一次把 IndexedDB 的列表做成“最新在前”时,真正让我停下来查文档的不是异步回调,而是 openCursor() 第二个参数。把 prev 换成 next,结果会反过来;把对象仓库换成索引,还会遇到重复键和 nextunique 的选择。
官方地址:https://developer.mozilla.org/en-US/docs/Web/API/IDBObjectStore/openCursor
记住三个位置就够了:openCursor(query, direction)的第一个参数限制“看哪些键”,第二个参数决定“从小到大还是从大到小”;只有索引可能出现重复索引键,才需要考虑nextunique或prevunique。
先分清游标从哪里取数据
IndexedDB 的游标不是给一张抽象表随便排序,而是从一个具体的数据源开始。对 IDBObjectStore 打开游标时,记录按主键排列;对 IDBIndex 打开游标时,记录按索引键排列。这个差别决定了你应该观察 cursor.key、cursor.primaryKey 还是 cursor.value。
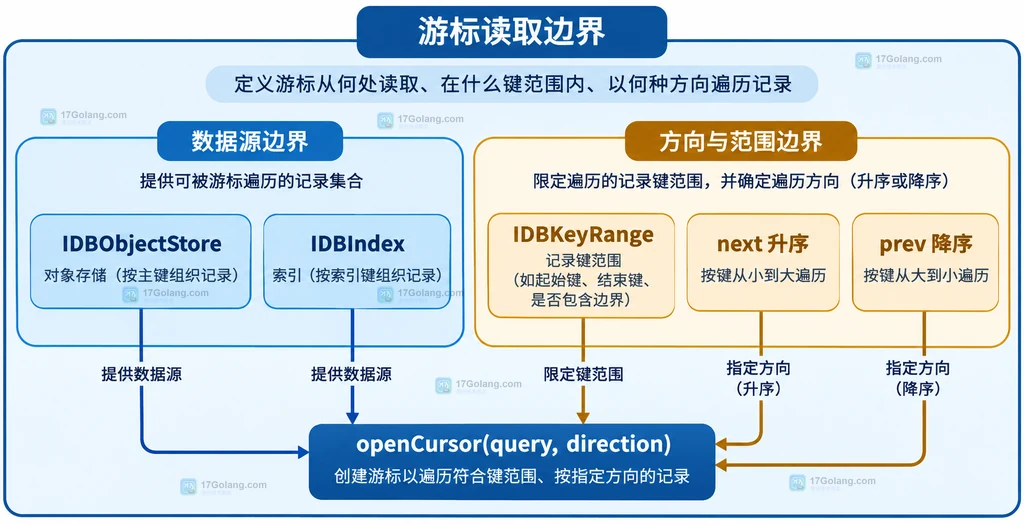
我在代码里通常先把这两个来源写成明确的变量名,避免后面误以为“索引键就是主键”:store.openCursor() 看的是主键顺序,store.index("userId").openCursor() 看的是 userId 索引顺序。
用 IDBKeyRange 限定“看哪些键”
query 是 openCursor() 的第一个参数。它可以是单个键,也可以是 IDBKeyRange。例如只读某个时间区间时,可以把起止键交给范围对象,而不是在回调里先取出全部记录再用 JavaScript 过滤。
const tx = db.transaction("posts", "readonly");
const store = tx.objectStore("posts");

// 只读取 createdAt 在起止时间内的记录,false 表示两端都包含。
const timeRange = IDBKeyRange.bound(startTime, endTime, false, false);

// null 表示不额外限制范围;第二个参数才是遍历方向。
const request = store.openCursor(timeRange, "prev");
request.onsuccess = (event) => {
  const cursor = event.target.result;
  if (!cursor) {
    // 没有下一条匹配记录,游标遍历结束。
    return;
  }

  renderPost(cursor.value);
  // 不传键时,沿着 prev 方向移动到下一条记录。
  cursor.continue();
};这里最容易写反的是参数顺序:openCursor(timeRange, "prev") 表示“在范围内按降序遍历”,不是“先降序再把范围当成方向”。如果只想改变方向而不过滤,可以明确传 null:store.openCursor(null, "prev")。
IDBKeyRange.lowerBound()、upperBound() 和 bound() 的开闭边界也会影响第一条和最后一条记录。范围正确但方向不对,通常表现为列表顺序反了;方向正确但范围边界写错,通常表现为首尾多一条或少一条。
next 和 prev 决定顺序,但不会自动去重
next 从键范围起点向更大的键移动,保留遇到的记录;prev 从范围终点向更小的键移动,也保留遇到的记录。对对象仓库来说,主键本来就必须唯一,因此通常只在索引上明显看到“同一个索引键对应多条记录”。
| 方向 | 排列方式 | 重复索引键 | 适合场景 |
|---|---|---|---|
next | 键升序 | 全部返回 | 从旧到新扫描、正向分页 |
prev | 键降序 | 全部返回 | 最新记录优先、反向分页 |
nextunique | 索引键升序 | 每个索引键保留一条 | 按索引键做去重读取 |
prevunique | 索引键降序 | 每个索引键保留一条 | 倒序按索引键取代表记录 |
所以“我用了 prev,为什么同一个用户还是出现多次?”的答案是:方向只改变游标移动方向,不承担去重职责。要不要去重,是另一层语义。
索引重复键时再考虑 nextunique 和 prevunique
假设 posts 有一个 userId 索引,同一个用户写入了多条文章。对这个索引调用 next,会看到同一个 userId 的多条记录;调用 nextunique,每个索引键只保留在该方向上最先遇到的记录。prevunique 同理,只是索引键从大到小遍历。
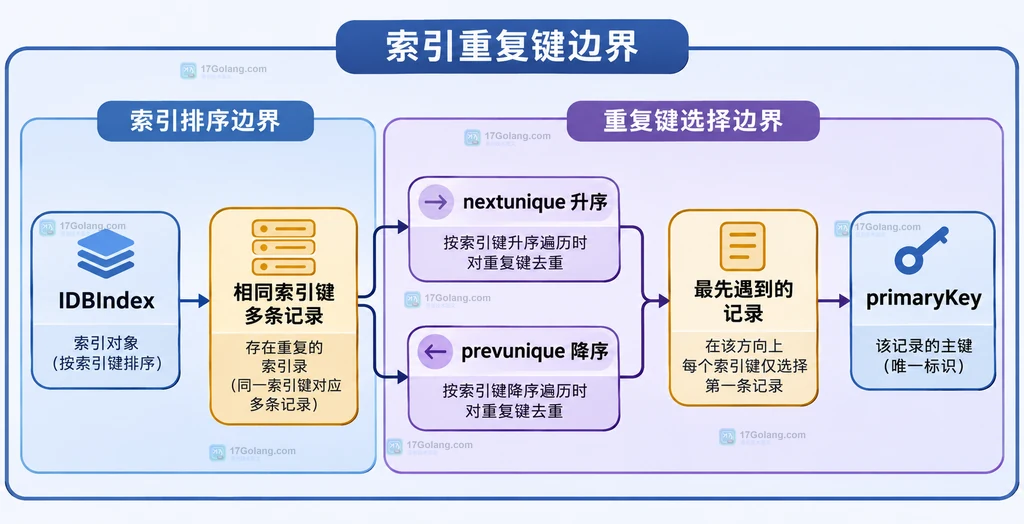
这里有一个很重要的边界:unique 不是“每次返回最新的一条”或“自动按时间字段去重”。它只围绕索引键去重,哪条记录被保留取决于索引游标的排序规则和方向。若业务想取“每个用户最新文章”,更稳妥的做法是建立能表达业务排序的索引,或在读取后明确比较时间字段,不要把 prevunique 当成“按时间取最新”的快捷方式。
const tx = db.transaction("posts", "readonly");
const store = tx.objectStore("posts");
const userIndex = store.index("userId");

// 只在索引重复键场景使用 unique 方向;它按 userId 去重。
const request = userIndex.openCursor(null, "nextunique");
request.onsuccess = (event) => {
  const cursor = event.target.result;
  if (!cursor) {
    // 每个索引键的代表记录都处理完了。
    return;
  }

  // key 是索引键,primaryKey 是对象仓库主键,value 是完整对象。
  showUserPost(cursor.key, cursor.primaryKey, cursor.value);
  cursor.continue();
};
如果你需要同一索引键下的全部记录,就应使用 next 或 prev,再自行决定如何合并;如果只需要每个索引键一个代表项,才考虑 unique 方向。另一个实用判断是:nextunique 和 prevunique 只能用于索引语义,不能拿来替代对象仓库的主键遍历。
把方向、范围和去重做成显式参数
我最后会把读取函数写成显式参数,调用点直接表达意图。这样以后从“全部记录倒序”改成“范围内正序”时,只改参数,不需要重写回调。
function scanIndex(index, range, direction, onRecord) {
  return new Promise((resolve, reject) => {
    // range 控制键范围,direction 控制顺序;两者不要混用。
    const request = index.openCursor(range ?? null, direction);

    request.onerror = () => reject(request.error);
    request.onsuccess = (event) => {
      const cursor = event.target.result;
      if (!cursor) {
        // 结果为 null 表示当前事务中的游标已经遍历完毕。
        resolve();
        return;
      }

      try {
        onRecord(cursor);
        // 回调只处理当前记录,移动仍由游标负责。
        cursor.continue();
      } catch (error) {
        // 把业务回调异常转成 Promise 拒绝,避免静默中断。
        reject(error);
      }
    };
  });
}

// 例:按索引键降序读取一个范围,并保留重复索引键。
scanIndex(userIndex, IDBKeyRange.bound("a", "m"), "prev", (cursor) => {
  renderPost(cursor.value);
});
这段封装的重点不是 Promise,而是把三个决定拆开:数据源由传入的 index 决定,范围由 range 决定,顺序和是否去重由 direction 决定。若传入 nextunique,调用方还应该在函数名或注释中明确“按索引键去重”,避免读代码的人误以为是普通升序。
我会用这张速查表做选择
- 想看全部记录且从小到大:
next。 - 想看全部记录且从大到小:
prev。 - 想限制首尾键:把
IDBKeyRange放在第一个参数。 - 想让索引键只出现一次:在索引上使用
nextunique或prevunique。 - 想要“每个用户最新一条”:先确认索引排序能表达“最新”,不要只凭
prevunique猜结果。
常见追问
把 direction 改成 prev 会改变数据库里的记录吗?
不会。direction 只决定当前游标怎样遍历,读取顺序改变,不会改写 object store、index 或记录主键。
nextunique 会按 value 去重吗?
不会。它针对索引键去重;对象内容相同但索引键不同,仍可能分别出现。需要按业务字段去重时,应显式设计索引或在应用层处理。
为什么范围正确,结果却还是有重复记录?
范围只负责限制键区间,不负责去重。若游标来自索引并且要合并同一索引键的多条记录,使用 next/prev 是预期行为;需要代表记录时再切换到对应的 unique 方向。
把 query 看成“范围”,把 direction 看成“顺序”,把 unique 看成“索引键是否只保留一个入口”,IndexedDB 游标的行为就不容易混在一起了。
 Fetch keepalive 请求有什么大小和生命周期边界
- 上一篇
- Fetch keepalive 请求有什么大小和生命周期边界
- 下一篇
- RTCDataChannel bufferedAmount 怎样控制发送背压
-
- 文章 · 前端 | 20分钟前 | key 前端路由 Navigation API currentEntry NavigationHistoryEntry currententrychange
- Navigation API currentEntry 怎样读取当前导航状态
- 348浏览 收藏
-
- 文章 · 前端 | 29分钟前 | 数据库迁移 IndexedDB 对象仓库 versionchange onupgradeneeded
- IndexedDB onupgradeneeded 怎样迁移对象仓库
- 321浏览 收藏
-
- 文章 · 前端 | 31分钟前 | javascript · 前端开发 · 浏览器API · localStorage sessionStorage storage事件 Web Storage 同源文档
- Web storage 事件为什么只通知其他文档
- 200浏览 收藏
-
- 文章 · 前端 | 34分钟前 |
- Web TransformStream 怎样体现背压
- 424浏览 收藏
-
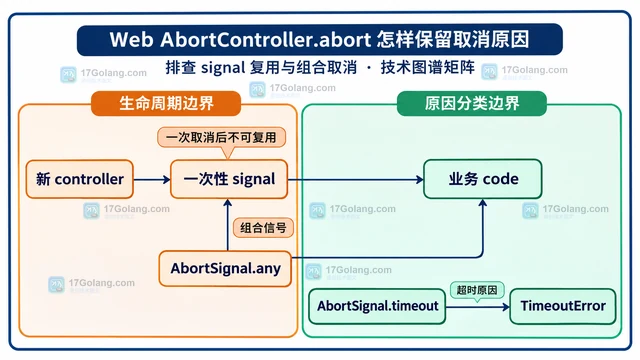
- 文章 · 前端 | 37分钟前 | 前端 · javascript · Web API Fetch AbortController AbortSignal abort(reason) signal.reason
- Web AbortController.abort 怎样保留取消原因
- 318浏览 收藏
-
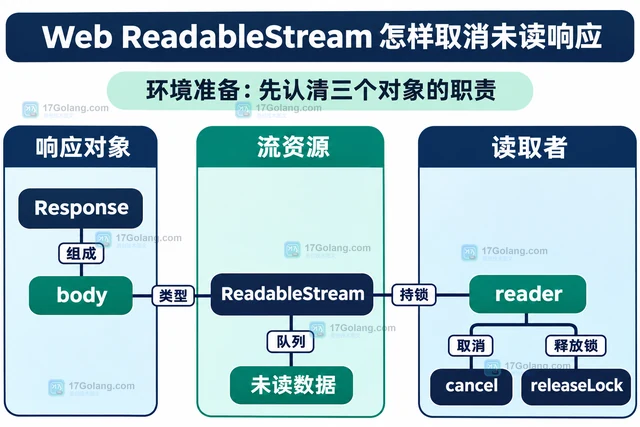
- 文章 · 前端 | 38分钟前 | Fetch AbortController ReadableStream cancel releaseLock
- Web ReadableStream 怎样取消未读响应
- 491浏览 收藏
-
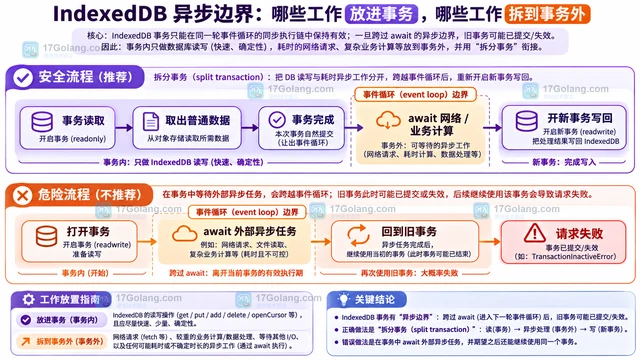
- 文章 · 前端 | 18小时前 |
- IndexedDB 事务自动提交前怎样完成异步读取
- 208浏览 收藏
-
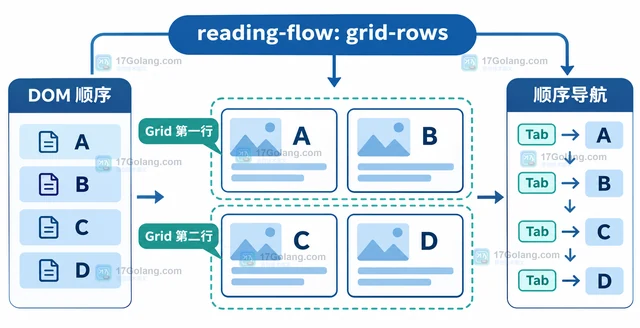
- 文章 · 前端 | 18小时前 | CSS flex Grid 可访问性 键盘导航 reading-order reading-flow
- CSS reading-flow 怎样让卡片的键盘顺序跟随视觉布局
- 308浏览 收藏
-
- 文章 · 前端 | 18小时前 | CSS textarea min-height field-sizing
- CSS field-sizing content 与 min-height 怎么配合
- 282浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1029次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1030次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1173次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1134次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 976次使用
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览


