
Transformers save_pretrained 怎样保存可迁移模型
要让 Transformers 模型可以迁移到另一台机器,核心不是只复制一个权重文件,而是把模型对象和 tokenizer 对象保存到同一个目录,再在新环境中分别恢复。模型侧负责权重与 config.json,tokenizer 侧负责词表、特殊 token 和分词配置。
官方地址:https://huggingface.co/docs/transformers/
model.save_pretrained()保存模型权重和配置。tokenizer.save_pretrained()保存完整 tokenizer 状态,不能省略。- 恢复时把同一个目录传给
AutoModel与AutoTokenizer,并检查词表是否仍与模型输入嵌入匹配。
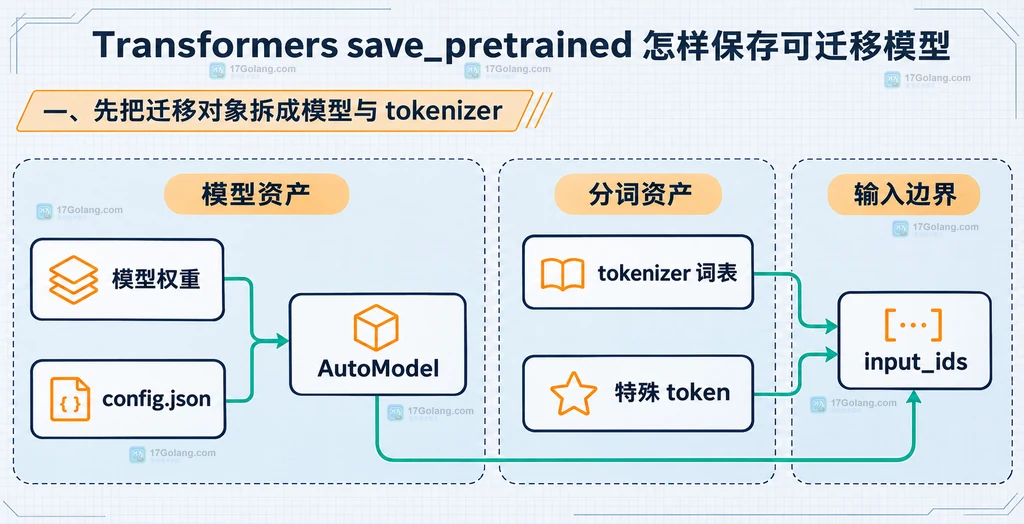
一、先把迁移对象拆成模型与 tokenizer
模型和 tokenizer 是两个有边界的对象。模型需要知道网络结构、隐藏层配置和权重文件;tokenizer 则决定文本怎样变成 input_ids,还包含特殊 token、词表及其映射。只保存模型可能得到一个能加载的网络,却无法保证新环境生成相同的输入。
二、用同一个输出目录保存完整组合
推荐把训练完成的模型和实际参与训练的 tokenizer 指向同一个输出目录。下面的代码展示保存关系;注释只标出关键职责,不代表已经在本机执行。
from pathlib import Path
from transformers import AutoModelForSequenceClassification, AutoTokenizer

model_id = "distilbert/distilbert-base-uncased"
output_dir = Path("artifacts/sentiment-model")

# 模型与 tokenizer 必须来自同一套输入约定
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForSequenceClassification.from_pretrained(model_id, num_labels=2)

# 目录不存在时由 Transformers 创建;模型侧写权重和配置
model.save_pretrained(output_dir)
# tokenizer 侧写词表、特殊 token 与分词器配置
tokenizer.save_pretrained(output_dir)
保存后目录可能包含 config.json、model.safetensors(或分片文件)以及 tokenizer 的 JSON、词表和映射文件。具体文件名由模型架构、Transformers 版本和 tokenizer 类型决定,所以迁移时应整体复制目录,不要只挑一个看起来最大的文件。
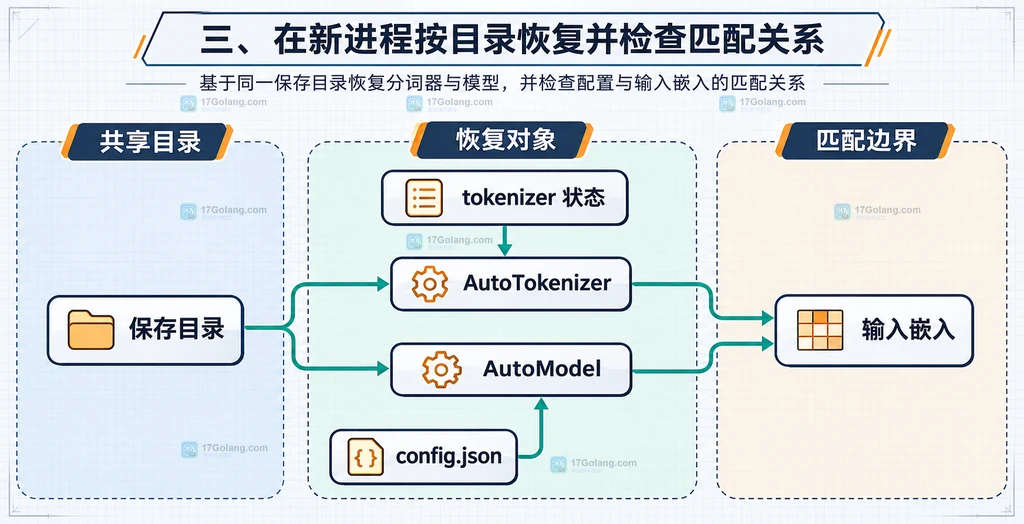
三、在新进程按目录恢复并检查匹配关系
恢复时先加载 tokenizer,再加载模型,调用方就能沿用训练时的编码方式。from_pretrained 接受保存目录,并会读取其中的配置;它不是要求你重新拼装模型结构。
from transformers import AutoModelForSequenceClassification, AutoTokenizer

model_dir = "artifacts/sentiment-model"

# 两个对象都从同一目录恢复,避免词表与权重来自不同版本
tokenizer = AutoTokenizer.from_pretrained(model_dir, local_files_only=True)
model = AutoModelForSequenceClassification.from_pretrained(model_dir, local_files_only=True)

# 迁移前可用这个边界做快速人工核对
if len(tokenizer) != model.get_input_embeddings().num_embeddings:
    raise ValueError("tokenizer 词表大小与模型输入嵌入不匹配")
如果训练期间调用过 tokenizer.add_tokens(),还需要在保存前确认模型的输入嵌入已经通过对应方式扩展,否则 tokenizer 文件虽然更新,模型仍可能无法承接新增 token。这个检查比比较文件大小更有意义。
四、处理分片、覆盖与不该混放的文件
大模型保存时可以用 max_shard_size 控制单个权重分片的上限,例如 model.save_pretrained(output_dir, max_shard_size="2GB")。分片不是多个独立模型,必须和生成的索引文件一起迁移。
重复保存到同一目录前,先确认目录用途。最稳妥的做法是为每次训练使用独立目录,保存完成后再把说明文件、评估结果或推理脚本放在旁边;不要把临时缓存、另一模型的 tokenizer 或未经记录的手工词表混入模型目录。若改过 tokenizer 或分类头,最好在目录外记录基座模型、标签映射和 Transformers 版本,便于回滚和复现。
相关问题
只保存 model.state_dict() 可以迁移吗?
可以作为底层权重备份,但它不包含完整的 Transformers 配置和 tokenizer 状态。面向可复用目录时,优先使用 save_pretrained 组合。
tokenizer 一定要和模型放在同一个目录吗?
不一定,但同目录最容易保证版本对应。若分开保存,必须把两者的来源、版本和词表变更记录清楚,恢复时显式传入正确路径。
 Evaluate 怎样加载指标并处理批量预测
- 上一篇
- Evaluate 怎样加载指标并处理批量预测
- 下一篇
- Transformers 怎样用 repetition_penalty 缓解重复输出
-
- 科技周边 · 人工智能 | 27分钟前 |
- Transformers 怎样用 repetition_penalty 缓解重复输出
- 124浏览 收藏
-
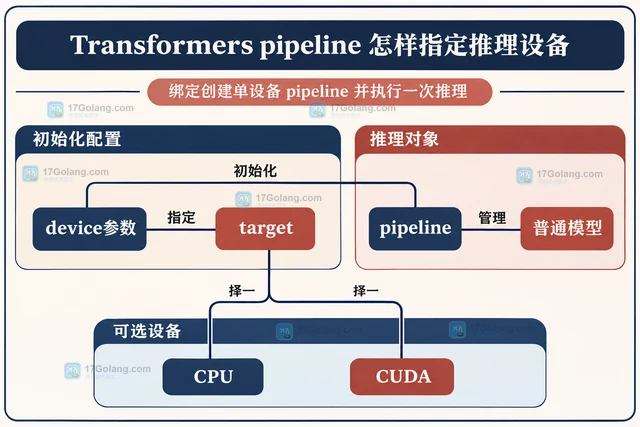
- 科技周边 · 人工智能 | 32分钟前 | pipeline device Transformers device_map 推理设备
- Transformers pipeline 怎样指定推理设备
- 212浏览 收藏
-
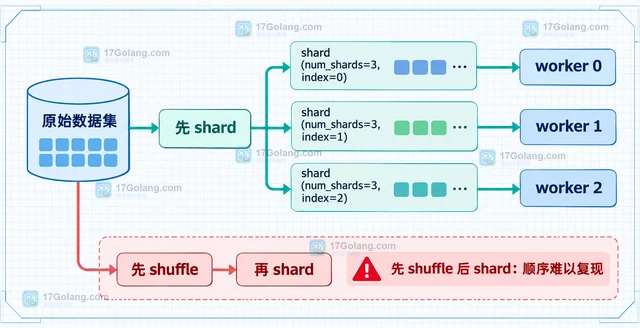
- 科技周边 · 人工智能 | 36分钟前 | python · 人工智能 · 并行处理 index Hugging Face Datasets Datasets shard num_shards contiguous
- Datasets shard 怎样切分数据集做并行处理
- 417浏览 收藏
-
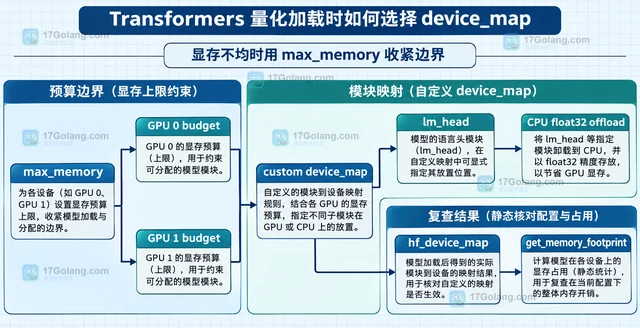
- 科技周边 · 人工智能 | 38分钟前 | 人工智能 · 显存 Transformers 量化模型 bitsandbytes device_map
- Transformers 量化加载时如何选择 device_map
- 280浏览 收藏
-
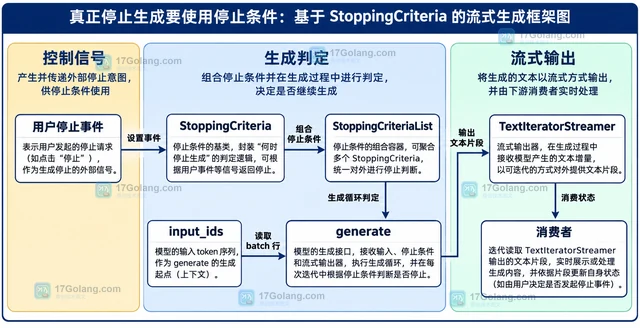
- 科技周边 · 人工智能 | 38分钟前 | python · Transformers TextIteratorStreamer 流式生成 AsyncTextIteratorStreamer StoppingCriteria
- Transformers streamer 怎样处理生成停止信号
- 198浏览 收藏
-
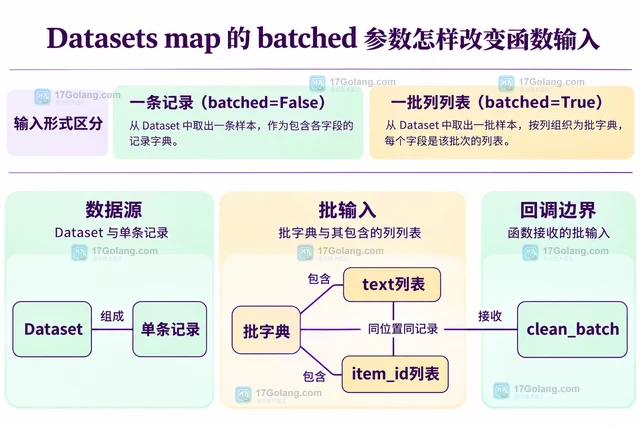
- 科技周边 · 人工智能 | 40分钟前 | map Datasets batch_size batched 批量映射
- Datasets map 的 batched 参数怎样改变函数输入
- 279浏览 收藏
-
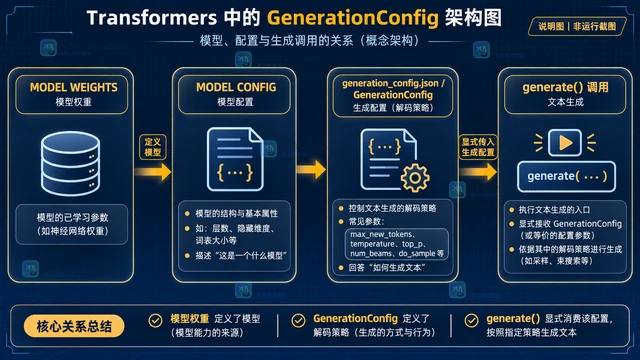
- 科技周边 · 人工智能 | 43分钟前 |
- Transformers GenerationConfig 保存生成参数与复用配置的方法
- 161浏览 收藏
-
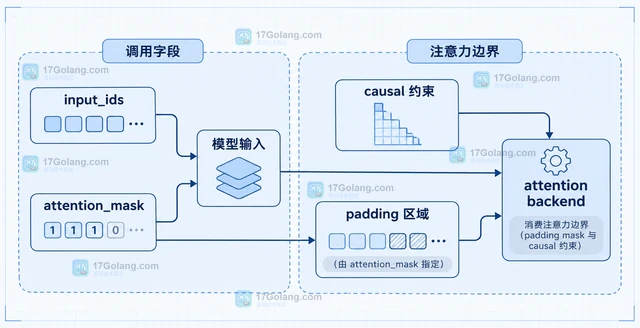
- 科技周边 · 人工智能 | 44分钟前 | python · 人工智能 · Hugging Face padding Transformers attention_mask 注意力掩码
- Transformers attention_mask 缺失会有什么影响
- 453浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1029次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1030次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1173次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1133次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 973次使用
-
- Transformers 文本超过最大长度怎么分段处理
- 2026-09-05 286浏览
-
- Transformers 怎么把生成结果逐段返回给网页
- 2026-09-06 472浏览
-
- Hugging Face Transformers 怎么用动态 padding 减少推理浪费
- 2026-09-07 297浏览
-
- LoRA 微调数据集里为什么要保留一致的对话格式
- 2026-09-09 426浏览


