Go reflect.Value.Kind 怎样判断反射值的基础类别
我在做一个“根据动态输入选择字段处理器”的小工具时,最先遇到的不是字段赋值,而是一个更基础的问题:手里的 reflect.Value 到底代表布尔值、整数、结构体,还是一个无效值?这时我会把 reflect.Value.Kind() 当成分类入口,而不是把它当成完整的类型信息。
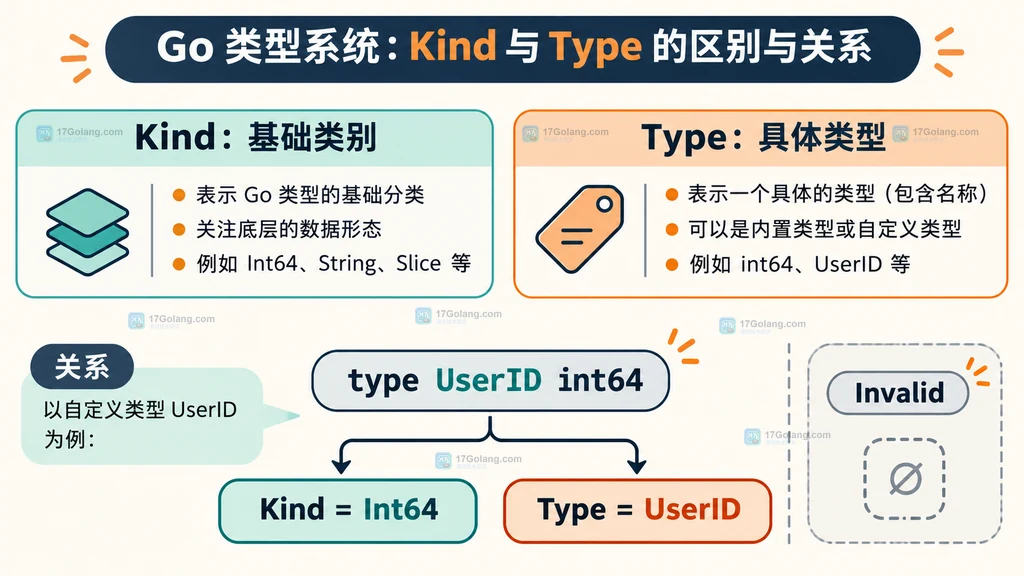
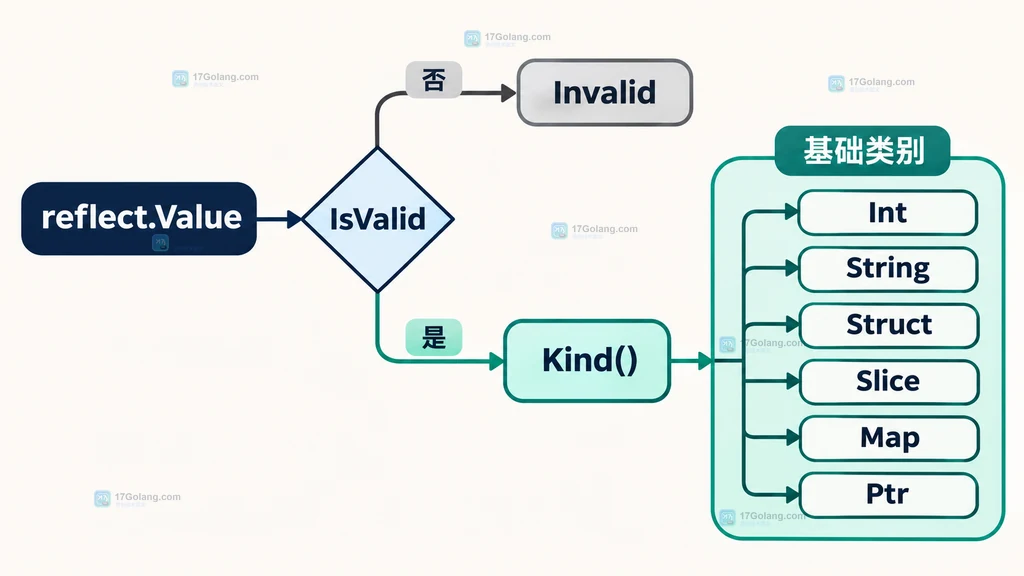
先记住一句话:Kind 返回的是反射值的基础类别,结果是 reflect.Kind 枚举;它适合做分支。要知道具体的命名类型、包路径或完整类型,仍然要看 Type()。在读取 Kind 前,还应该先处理 IsValid(),这样无效值不会悄悄混入后面的逻辑。
我先把判断入口固定下来
reflect.ValueOf 把普通值包装成反射值,Kind 再把它映射到基础类别。这里最容易漏掉的是:向 ValueOf 传入一个 nil 接口时,得到的不是“类型为 nil 的 Value”,而是一个无效的 Value。无效值的 Kind 是 reflect.Invalid,所以分类函数应当把它作为第一条分支。
package main

import (
	"fmt"
	"reflect"
)

func categoryOf(input any) string {
	v := reflect.ValueOf(input)

	// 先拦截 nil 接口产生的无效 Value。
	if !v.IsValid() {
		return "invalid"
	}

	// Kind 返回基础类别,适合做有限的分类分支。
	switch v.Kind() {
	case reflect.Bool:
		return "bool"
	case reflect.Int, reflect.Int8, reflect.Int16, reflect.Int32, reflect.Int64:
		return "signed-integer"
	case reflect.Uint, reflect.Uint8, reflect.Uint16, reflect.Uint32, reflect.Uint64, reflect.Uintptr:
		return "unsigned-integer"
	case reflect.Float32, reflect.Float64:
		return "float"
	case reflect.String:
		return "string"
	case reflect.Struct:
		return "struct"
	case reflect.Slice, reflect.Array:
		return "sequence"
	case reflect.Map:
		return "map"
	default:
		return fmt.Sprintf("other:%s", v.Kind())
	}
}
这个入口的价值在于把“值是否存在”和“值属于哪一类”分开。只有拿到有效值后,才进入 Kind 分支;后续如果需要调用 Elem、IsNil 或某个具体的 Int 方法,也能先根据类别收窄范围。
Kind 与 Type 名称不是一回事
我第一次把这段逻辑接到命名类型上时,曾经用 Kind 去判断“是不是业务上的 UserID”。这会得到错误的结论,因为命名类型的基础类别仍然可能只是 Int64。Kind 解决的是“它大致属于哪一类”,Type 才能继续回答“它的完整类型是什么”。
type UserID int64

func inspectUserID() {
	v := reflect.ValueOf(UserID(42))

	// 命名类型的 Kind 仍然是底层的 Int64 类别。
	fmt.Println(v.Kind() == reflect.Int64) // true
	// Type 保留了命名类型的具体信息。
	fmt.Println(v.Type().Name()) // UserID
}
因此,分类器可以用 Kind 选择整数处理器;只有当业务规则必须区分 UserID、OrderID 这类命名类型时,再用 Type 做第二层判断。把两种信息混成一个条件,通常会让反射分支变得既不准确又难维护。
按基础类别分支时,先列清楚要处理的范围
reflect.Kind 的枚举不少,但业务代码不一定要一次覆盖全部。我的做法是先按处理器真正支持的类别列白名单,再把剩余类别放进明确的兜底分支。这样比把每个枚举都写成一条同样的路径更容易看出边界。
func handlerName(v reflect.Value) string {
	// 调用 Kind 前先确认 Value 有效。
	if !v.IsValid() {
		return "invalid"
	}

	// 只把当前适配器真正支持的类别映射到处理器。
	switch v.Kind() {
	case reflect.Ptr, reflect.Interface:
		return "indirection"
	case reflect.Func:
		return "callable"
	case reflect.Chan:
		return "channel"
	case reflect.Struct:
		return "record"
	case reflect.Map:
		return "key-value"
	case reflect.Slice, reflect.Array:
		return "sequence"
	default:
		return "scalar-or-unsupported"
	}
}
这里没有把 Ptr 和它指向的值直接当成同一类。指针的 Kind 是 Ptr,要继续看被指向的值,应该在确认非 nil 后再调用 Elem,并重新读取得到的 Value 的 Kind。接口也类似:接口的“外壳”和里面的动态值是两个判断层次。
用基线、假设和测量方法看待这次改动
在这个反射分派场景里,我的基线是:每个处理器都先尝试 Interface(),再做多次类型断言;问题是分支顺序会影响可读性,而且遇到无效值或未覆盖类型时,错误位置不够集中。改动假设是:先用一次 IsValid 加一次 Kind 把输入归类,再把具体类型检查留给确实需要的分支。
这不是“Kind 一定更快”的结论。它主要减少了重复的判断入口,并让边界更早暴露。若性能确实是问题,应该用项目里的真实输入做基准,而不是凭感觉写一个结果。下面这个基准骨架可以比较两种分类函数的分配和耗时;运行后再根据自己的 Go 版本、输入分布和处理器实现解读结果。
func BenchmarkCategoryOf(b *testing.B) {
	input := reflect.ValueOf(UserID(42))
	b.ReportAllocs()
	b.ResetTimer()

	for i := 0; i < b.N; i++ {
		// 只测分类入口,避免把业务处理时间混进来。
		_ = input.Kind()
	}
}
我会记录三项结果:每次操作耗时、每次操作分配次数,以及不同类别输入是否走到预期分支。这个测量框架比直接宣称某个固定百分比更可靠,因为反射值是否来自指针、接口或命名类型,都会改变实际路径。
几个边界别混用
Invalid 不等于“值为零”
Invalid 表示这个 Value 没有有效的反射对象,常见来源是 nil 接口或查找失败。它不是整数 0、空字符串,也不是一个可以继续调用任意方法的占位值。分类入口要先返回或转成明确错误。
有效的 nil 指针仍然有 Kind
如果输入是一个类型明确但值为 nil 的指针,Value 本身仍然有效,Kind 会返回 Ptr。这时判断指针是否为 nil,应在指针或接口类别分支里调用 IsNil;不能把它和 !IsValid() 合并处理。
Kind 不能替代 IsZero
Kind 只说明类别,不说明值是否是该类别的零值。要判断一个有效值是否为零,应使用与当前 Go 版本匹配的零值判断方式,并先确认值的有效性。类别判断、nil 判断和零值判断最好保持三段清晰的逻辑。
最后怎么选
如果你要回答的是“这个反射值属于哪种基础类别”,用 Kind;如果要回答的是“它是不是某个命名类型”,把 Type 接在后面;如果要回答的是“它是否为空或为零”,分别处理 IsNil、有效性和零值语义。最稳妥的顺序通常是:先 IsValid,再 Kind,最后按分支需要读取 Type、IsNil 或元素。
这套写法适合反射适配器、配置解码、通用序列化和动态字段分派。它不替代静态类型,也不应该为了“看起来通用”而把所有业务规则都塞进一个巨大的 switch。先固定分类入口,再让每个类别拥有清楚的边界,维护成本通常比继续堆类型断言更可控。
常见问题
reflect.Value.Kind 返回的是什么?
它返回一个 reflect.Kind 枚举,描述反射值的基础类别,例如 Struct、Slice、Map 或 Int64。它不是具体命名类型的名称。
为什么调用 Kind 前要先 IsValid?
因为无效 Value 代表没有可用的反射对象,常见于 nil 接口或失败的查找结果。把它先分出来,可以避免后续把“没有值”误当成某个业务类别。
Kind 和 Type 应该怎么配合?
先用 Kind 做大类分支,再在少数需要精确识别的路径使用 Type。例如所有整数都走整数处理器,但只有 Type().Name() 匹配业务命名类型时才走特殊规则。
nil 指针的 Kind 是什么?
只要反射值本身有效,nil 指针的 Kind 仍是 Ptr。它是否为 nil 是另一个问题,应在允许 nil 的类别分支中单独判断。
 Go io.MultiWriter 写入失败后的短写处理与目标顺序设计