
GitHub CLI 怎样用 JSON 输出批量筛选 issue
GitHub CLI 可以通过 gh issue list --json 字段列表 输出结构化数据,再用内置 --jq 筛选。先用仓库、状态和标签缩小查询范围,再从返回的数组里选记录,最后决定给脚本传 JSON 数组还是逐行编号,比拆终端表格更稳定。
官方地址:https://cli.github.com/
下面以“从指定仓库查询开放的 bug,再挑出尚未分配人员的条目”为例。命令中的 OWNER/REPO 必须替换为有访问权限的仓库;示例使用 Bash 类 shell 的引号和续行写法。本文提供操作方法与预期结构,不声称已查询某个真实仓库。
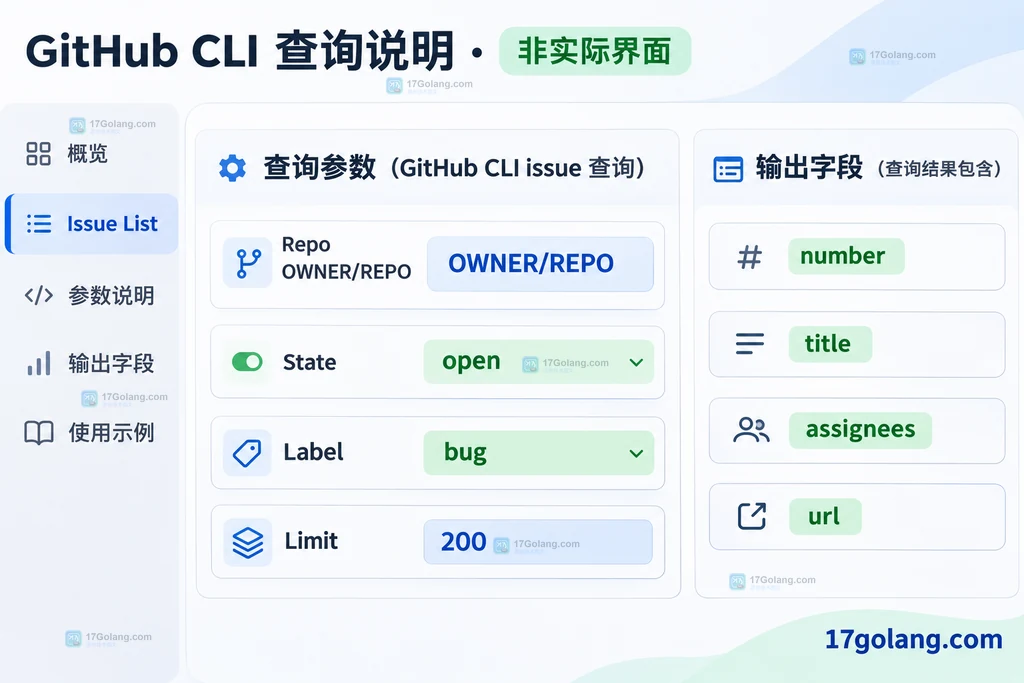
1. 先确定仓库、状态与返回字段
安装 GitHub CLI 并完成授权后,在命令行入口使用 gh issue list。CLI 没有可点击的 JSON 筛选菜单,实际入口就是参数。显式写 --repo,可以避免从当前 Git 目录误推断仓库。
# 获取指定仓库中最多200条开放的bug,字段按后续筛选需要选择
gh issue list --repo OWNER/REPO \
  --state open --label bug --limit 200 \
  --json number,title,assignees,url
返回内容应是一个 JSON 数组;每项含编号、标题、分配人员数组和地址。没有符合条件的记录时,数组可为空。不同仓库的标签名称并不统一,先确认确实有 bug 标签,不能把空结果直接解释为没有任何待办。
默认最多取三十条,因此需要明确 --limit。这里的二百只是本次上限,不代表完整导出全仓库。后面的 jq 仅处理已经取回的数据,如果相关条目没有进入这批结果,调整 jq 表达式也找不到它。
2. 在内置 jq 中筛选,并保留数组形状
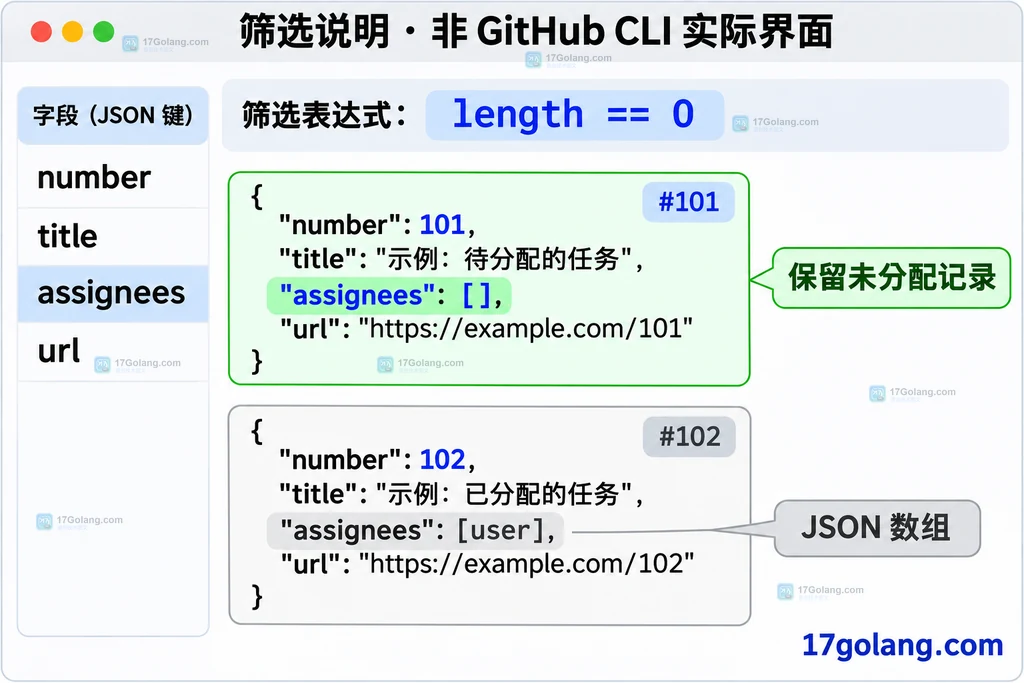
在同一命令上追加 --jq。未分配人员对应 assignees 数组长度为零;外层方括号把筛选后的对象收集成一个新数组。
# 在已获取的issue中筛选未分配记录,并保留稳定的JSON数组输出
gh issue list --repo OWNER/REPO \
  --state open --label bug --limit 200 \
  --json number,title,assignees,url \
  --jq '[.[] | select((.assignees | length) == 0) | {number, title, url}]'
表达式里的 .[] 逐项访问数组,select 决定保留哪些对象,最后只留下交付脚本需要的字段。输出里不再有 assignees,不影响筛选,因为该字段已经在 --json 中请求并用于条件判断。
内置 --jq 不要求另装 jq 程序,但它必须配合 --json 和所需字段使用。字段名称与普通表格列标题不是一回事,应以 gh issue list --help 及官方 JSON Fields 为准。拼错字段或未请求嵌套字段,应该修正字段列表,而不是用文本搜索去补救。
3. 将结果保存为脚本约定的输入
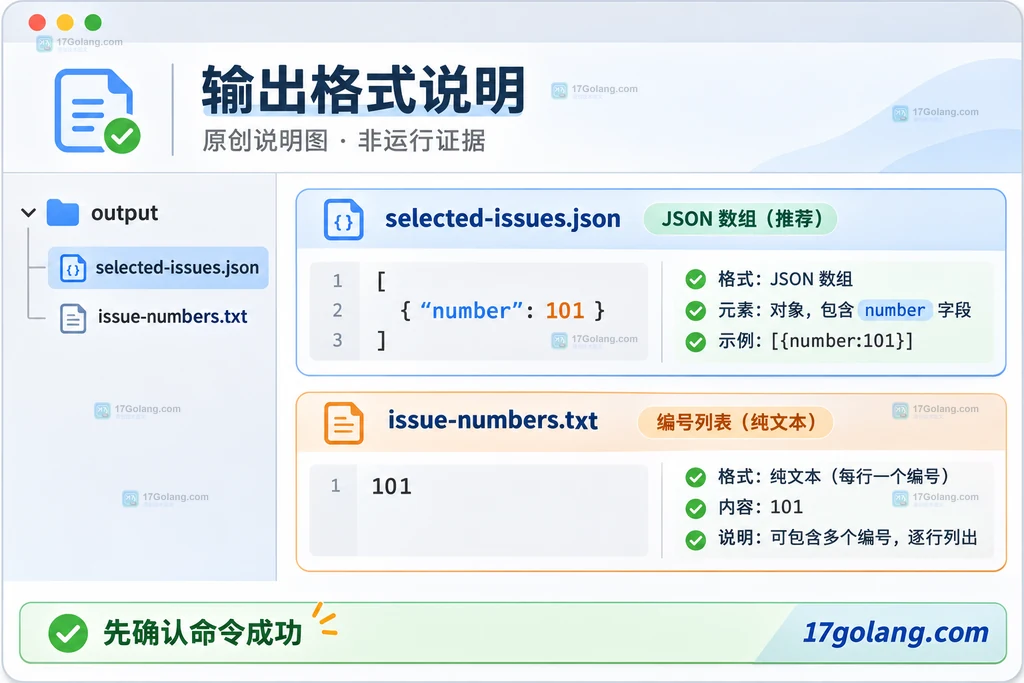
如果下游程序读取 JSON,保留数组最容易处理。下面把查询结果先放进临时文件,命令成功后才替换最终文件,避免失败的请求覆盖上一份有效结果。
# Bash示例:失败时保留旧文件,不把请求失败当成空结果
task_output=$(mktemp) || exit 1
if gh issue list --repo OWNER/REPO \
  --state open --label bug --limit 200 \
  --json number,title,assignees,url \
  --jq '[.[] | select((.assignees | length) == 0) | {number, title, url}]' \
  > "$task_output"; then
  mv "$task_output" selected-issues.json
else
  rm -f "$task_output"
  printf '%s\n' 'issue查询失败,保留原结果文件' >&2
  exit 1
fi
若下游只接受一行一个编号,可以让表达式输出 number。以下命令会覆盖同名文本文件,适合独立输出;需要保留上一份结果时,可套用前面的临时文件方式。
# 只输出整数编号,不让标题中的空格或换行影响后续读取
gh issue list --repo OWNER/REPO \
  --state open --label bug --limit 200 \
  --json number,assignees \
  --jq '.[] | select((.assignees | length) == 0) | .number' \
  > issue-numbers.txt
JSON 数组空结果是 [];逐行编号在没有匹配记录时可能是空文件。两者都必须建立在命令成功的前提下。读取编号时,不要将 issue 标题拼接成可执行命令;如果以后扩展为关闭、打标签或修改 issue 的批量操作,应另行确认操作范围,这篇只导出数据。
结果太少、字段为空时怎么判断
| 现象 | 判断方向 |
|---|---|
| 只取到少量记录 | 检查 limit、state、label 与仓库范围 |
| 筛选后没有结果 | 区分远端已无匹配记录和当前返回批次中无匹配记录 |
| 提示字段不支持 | 核对本机帮助中的可用 JSON 字段 |
| 私有仓库无法读取 | 检查当前登录账号、主机与仓库读取权限 |
如果目标条件本身支持远端搜索,例如未分配人员,应优先用 --search 'no:assignee' 缩小获取范围,再用 JSON 做投影与后处理;这样能减少先取有限条数再过滤所造成的遗漏。即便如此,显式上限仍然存在,不能把一次有限查询称为完整仓库清单。
批量筛选的关键是确定数据契约:仓库和状态决定候选范围,字段列表决定哪些数据可用,jq 决定保留记录与输出形状。把这三层分开保存,脚本后续需要增加字段或改变条件时,就不必重新依赖终端表格的视觉布局。
 Postman pre-request script 怎样把响应值写入环境
- 上一篇
- Postman pre-request script 怎样把响应值写入环境
- 下一篇
- DBeaver 数据编辑器提交前怎样查看待执行变更
-
- 文章 · 软件教程 | 21分钟前 |
- DBeaver 数据编辑器提交前怎样查看待执行变更
- 295浏览 收藏
-
- 文章 · 软件教程 | 24分钟前 |
- Postman pre-request script 怎样把响应值写入环境
- 162浏览 收藏
-
- 文章 · 软件教程 | 27分钟前 | JetBrains Find Usages Structural Search Structural Replace
- JetBrains Find Usages 与 Structural Search 适用范围
- 161浏览 收藏
-
- 文章 · 软件教程 | 27分钟前 |
- GitHub Actions concurrency group 使用表达式时怎样避免误取消
- 279浏览 收藏
-
- 文章 · 软件教程 | 30分钟前 | GitHub Actions Artifacts retention-days
- GitHub Actions artifacts 怎样只保留指定天数的构建产物
- 368浏览 收藏
-
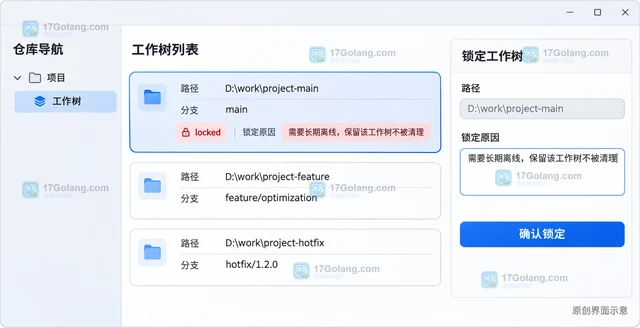
- 文章 · 软件教程 | 31分钟前 | 开发工具 · Git Git worktree worktree lock linked worktree Git 工作树 prune repair
- Git worktree lock 何时用于保护长期工作树
- 448浏览 收藏
-
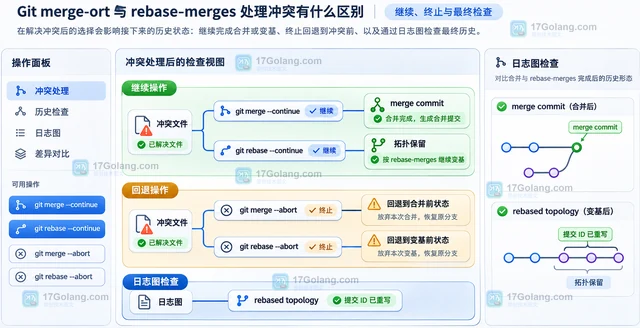
- 文章 · 软件教程 | 34分钟前 |
- Git merge-ort 与 rebase-merges 处理冲突有什么区别
- 357浏览 收藏
-
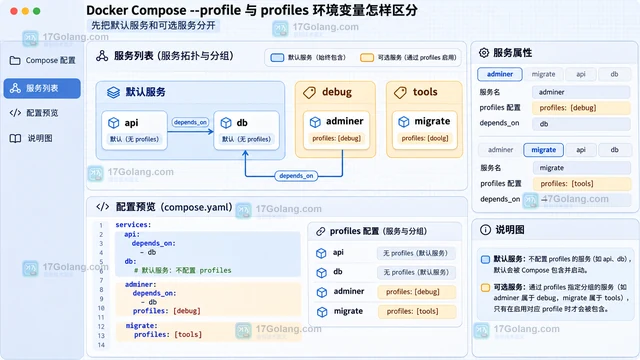
- 文章 · 软件教程 | 38分钟前 | 开发环境 · 配置管理 · 软件教程 · 环境变量 容器编排 Docker Compose Profiles COMPOSE_PROFILES --profile
- Docker Compose --profile 与 profiles 环境变量怎样区分
- 192浏览 收藏
-
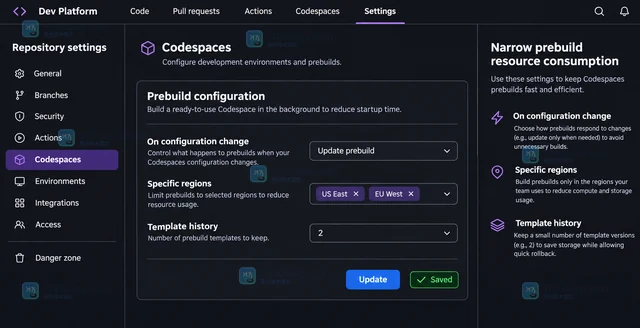
- 文章 · 软件教程 | 40分钟前 | 软件教程 · devcontainer.json GitHub Codespaces Codespaces预构建 hostRequirements 机器规格
- GitHub Codespaces 怎样限制预构建环境的资源使用
- 289浏览 收藏
-
- 文章 · 软件教程 | 41分钟前 |
- VS Code Dev Containers 怎样让项目依赖在容器内一致
- 267浏览 收藏
-
- 文章 · 软件教程 | 46分钟前 | 浏览器 firefox 复制链接 Copy Clean Link 跟踪参数
- Firefox 怎么复制去除跟踪参数的链接
- 436浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1018次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1020次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1155次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1121次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 962次使用
-
- VS Code Markdown 预览怎样同步定位当前标题
- 2026-11-04 501浏览
-
- VS Code 怎么给 Go 项目配置测试任务:tasks.json 运行与结果验收
- 2026-07-09 501浏览
-
- Windows 11 如何开启 HEIF 图片支持
- 2026-05-31 501浏览
-
- TikTok用户画像与付费订阅变现方法
- 2026-05-27 501浏览
-
- 学信网学历翻译件申请方法
- 2026-05-27 501浏览


