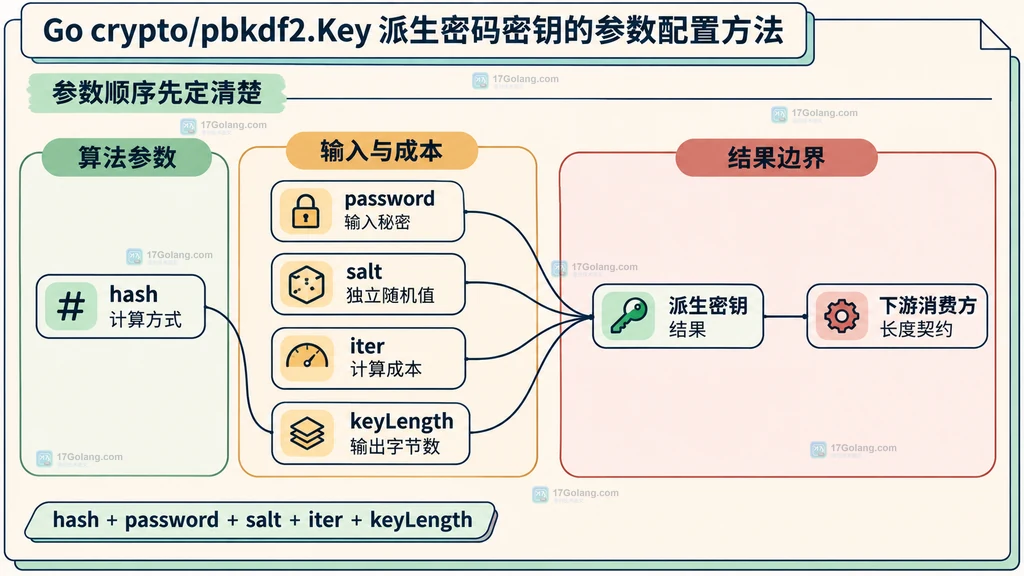
Go 1.24 把 PBKDF2 放进了标准库,调用 crypto/pbkdf2.Key 时先记住这一组顺序:hash、password、salt、iter、keyLength。哈希决定每轮计算方式,salt 用来区分每条记录,iter 控制计算成本,keyLength 必须和下游密钥接口的长度一致。官方 API 说明见 https://pkg.go.dev/crypto/pbkdf2。
salt 每次独立随机生成且可以随记录保存;iter 不要照抄一个“安全数字”,应在目标机器上实测;keyLength 先看 AES、HMAC 等消费方的要求;迁移旧版 golang.org/x/crypto/pbkdf2 时尤其要检查参数顺序和旧记录的算法元数据。
参数顺序先定清楚
标准库签名是 Key(h func() hash.Hash, password, salt []byte, iter, keyLength int) ([]byte, error)。旧版扩展包常见的形式把密码和 salt 放在前面、把哈希构造器放到末尾,两者不能只靠编辑器自动补全来判断。更稳妥的做法是把调用点旁边的用途写清楚:密码是输入秘密,salt 是公开随机值,iter 是成本参数,keyLength 是最终输出字节数。
四个参数的配置方法
| 参数 | 配置要点 | 常见边界 |
|---|---|---|
h | 选择稳定的哈希构造器,并与既有记录的算法标识一起保存。 | 不能把不同 hash 的结果当作同一种密钥。 |
password | 按约定编码成字节;不要在函数内部偷偷截断或重复哈希。 | 编码变化会让同一可见密码产生不同结果。 |
salt | 每条记录独立生成,salt 不需要保密,但要和参数元数据一起保存。 | 不要用固定常量或用户标识代替随机 salt。 |
iter | 在部署机器上测量,按可接受延迟选择,并为后续升级保留版本字段。 | 过低削弱成本,过高会拖慢正常业务。 |
keyLength | 让输出长度直接匹配消费方,例如 32 字节密钥。 | 必须为正,并受实现允许的最大值约束。 |
salt 的“公开”不等于可以复用。它的作用是让相同密码在不同记录上得到不同派生结果;真正需要保护的是密码和派生密钥。若系统还要保存算法、hash 名称、iter 和 keyLength,应把这些字段作为记录的一部分,而不是依赖代码里的当前默认值。
一段可落地的派生代码
下面示例把 salt 的生成、参数选择和错误传播放在同一个边界内。100000 只是演示起点,不代表所有机器和业务都适合;上线前要用目标环境的实测耗时调整。
package main

import (
    "crypto/pbkdf2"
    "crypto/rand"
    "crypto/sha256"
    "fmt"
)

func deriveKey(password string) ([]byte, []byte, error) {
    salt := make([]byte, 16)
    // salt 不需要保密,但每条记录都应独立随机生成并随元数据保存。
    if _, err := rand.Read(salt); err != nil {
        return nil, nil, fmt.Errorf("生成 salt: %w", err)
    }

    // 100000 只是校准起点;生产值应由目标机器的可接受耗时决定。
    key, err := pbkdf2.Key(sha256.New, []byte(password), salt, 100_000, 32)
    if err != nil {
        return nil, nil, fmt.Errorf("派生密钥: %w", err)
    }
    return key, salt, nil
}
这里选择 SHA-256 和 32 字节,是因为示例假定下游需要固定长度的密钥;如果消费方要求其他长度,应先改接口契约再改 keyLength。不要把 PBKDF2 的输出直接当成“万能密码存储方案”,本篇只解决 API 参数配置;密码存储协议、登录策略和密钥轮换属于另外的设计边界。
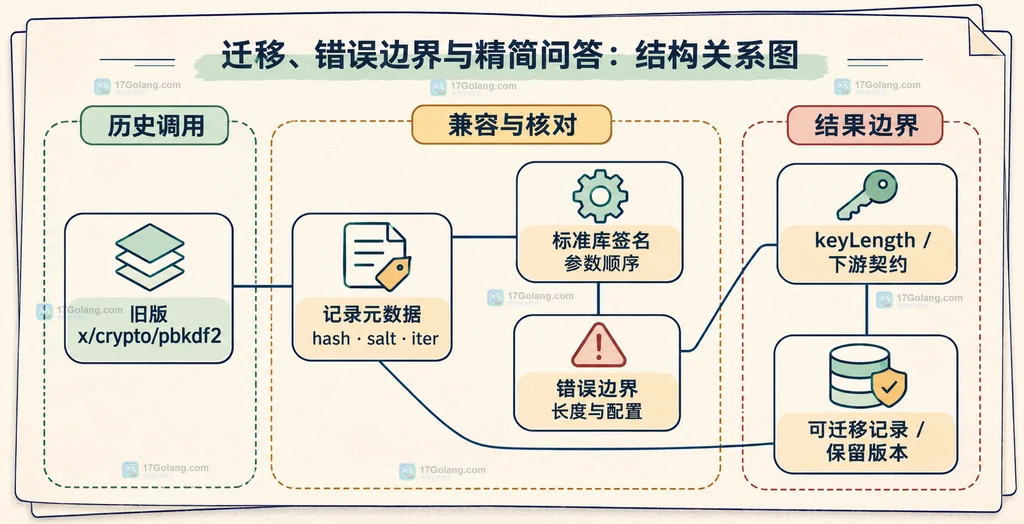
迁移、错误边界与精简问答
从 golang.org/x/crypto/pbkdf2 迁移时,先在数据结构中确认旧记录使用的 hash、salt、iter 与 keyLength,再替换调用。标准库函数可能返回错误,调用方不能只接收一个字节切片就忽略失败。特别是非正的 keyLength、超过实现边界的长度,或不符合约定的迭代参数,都应在业务边界转换成可观测的配置错误;不要用静默默认值掩盖。
iter 越大就一定越安全吗?
不是。它提高每次派生的计算成本,同时也提高正常请求的延迟。应按目标机器和业务吞吐做基准测试,并在记录中保存参数版本,让后续升级可以逐步迁移。
salt 需要加密保存吗?
通常不需要保密。salt 的关键要求是随机、独立、随记录保存;真正不能泄露的是密码和派生密钥。把 salt 当成普通元数据保存即可,但不要把它改成固定常量。
keyLength 能随便填一个大数吗?
不能。它必须是正数,并且要符合函数实现的上限;更重要的是要匹配下游接口。为了 AES-256 选择 32 字节只是一个具体契约示例,不代表所有加密或校验场景都应使用同一长度。
 Go net/http ServeMux 怎样为同一路径区分方法匹配