在域名验证、服务发现或配置读取里,Go 的 net.Resolver.LookupTXT 经常会返回多个字符串。真正容易出错的地方不是调用 API,而是误解了这个 []string:切片元素代表多条 DNS TXT 记录,而一条记录内部如果由多个字符串片段组成,Go 已经把这些片段拼成了一个元素。
所以,标题里的“怎么拼接”不能直接回答成 strings.Join(records, "")。正确做法是先保留记录边界,再根据业务协议决定是否拼接。本文用一个小型 TXT 读取工具把这件事讲清楚。
官方文档:https://pkg.go.dev/net#Resolver.LookupTXT
先分清 LookupTXT 返回值的两层结构
LookupTXT 的签名是 func (r *Resolver) LookupTXT(ctx context.Context, name string) ([]string, error)。返回的切片有两个重要边界:
- 切片的一个元素对应一条 DNS TXT 记录。
- 同一条 TXT 记录内部的多个字符串片段,已经被 Go 连接成一个字符串。
可以把它想成下面的关系:记录 A 内部有两个片段,记录 B 是另一条独立记录。返回结果应当类似 []string{"片段1片段2", "另一条记录"},而不是把所有内容自动变成一个长字符串。
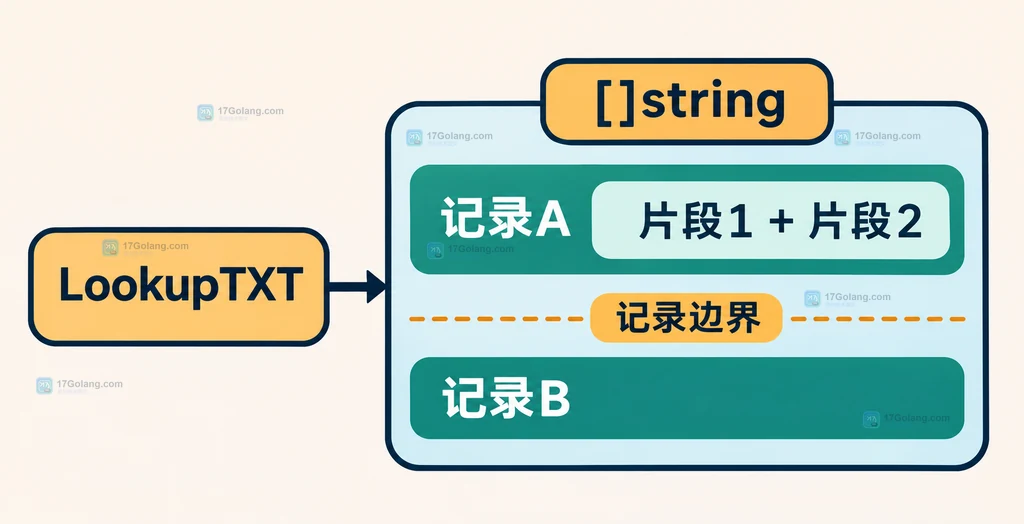
这一区别直接影响域名验证。验证值通常要逐条匹配前缀或完整内容;配置发现则可能需要保留多条候选。无论哪一种,都不应该在刚拿到返回值时丢掉原始边界。
先做一个带超时的 TXT 读取小工具
项目目标很小:接收域名,读取 TXT 记录,逐条打印,并提供一个可选分隔符。这里使用 Resolver.LookupTXT 而不是包级函数,是为了把超时传入 DNS 查询。包级 net.LookupTXT 会使用后台上下文,不适合把查询时间纳入命令或服务的整体超时。
package main

import (
	"context"
	"flag"
	"fmt"
	"net"
	"strings"
	"time"
)

func main() {
	name := flag.String("name", "", "要查询的域名")
	sep := flag.String("sep", "", "可选的业务层拼接分隔符")
	timeout := flag.Duration("timeout", 3*time.Second, "DNS 查询超时时间")
	flag.Parse()

	// 域名为空时立即返回,避免把输入错误伪装成 DNS 故障。
	if strings.TrimSpace(*name) == "" {
		fmt.Println("请使用 -name 指定域名")
		return
	}

	// 用调用方控制的上下文限制 DNS 查询时间,避免命令长期等待。
	ctx, cancel := context.WithTimeout(context.Background(), *timeout)
	defer cancel()

	// Resolver.LookupTXT 返回每条 TXT 记录一个字符串元素。
	resolver := &net.Resolver{}
	records, err := resolver.LookupTXT(ctx, *name)
	if err != nil {
		// 保留原始错误,便于区分超时、无记录和解析器故障。
		fmt.Printf("查询 %s 失败: %v\n", *name, err)
		return
	}
	if len(records) == 0 {
		fmt.Printf("%s 没有可用的 TXT 记录\n", *name)
		return
	}

	// 先逐条输出,确认记录边界没有被业务逻辑提前抹掉。
	fmt.Printf("记录数: %d\n", len(records))
	for i, record := range records {
		fmt.Printf("记录[%d] = %q\n", i, record)
	}

	// 只有显式传入分隔符时才拼接,默认不合并独立记录。
	if *sep != "" {
		fmt.Printf("拼接结果 = %q\n", strings.Join(records, *sep))
	}
这个工具有意把“读取”和“拼接”分成两步。先打印每一条记录,可以快速发现把多条 TXT 当成一条配置的错误;只有调用方明确传入分隔符时,才执行业务层的 Join。
为什么不能默认使用 strings.Join(records, "")
strings.Join(records, "") 只保证把切片元素首尾相连,不知道这些元素在 DNS 语义上是不是同一个业务值。假设返回了:
records := []string{
	"google-site-verification=alpha", // 第一条独立验证记录
	"v=spf1 include:mail.example -all", // 第二条独立策略记录
}
无分隔符拼接后会变成一个没有边界的字符串,既不再是一个有效的验证值,也不再是清晰的 SPF 值。更稳妥的方式是逐条查找符合协议的记录。
func findVerificationValue(records []string, prefix string) (string, bool) {
	for _, record := range records {
		// 只在完整记录上匹配前缀,避免把两条记录拼成假值。
		if strings.HasPrefix(record, prefix) {
			return record, true
		}
	}
	return "", false
}
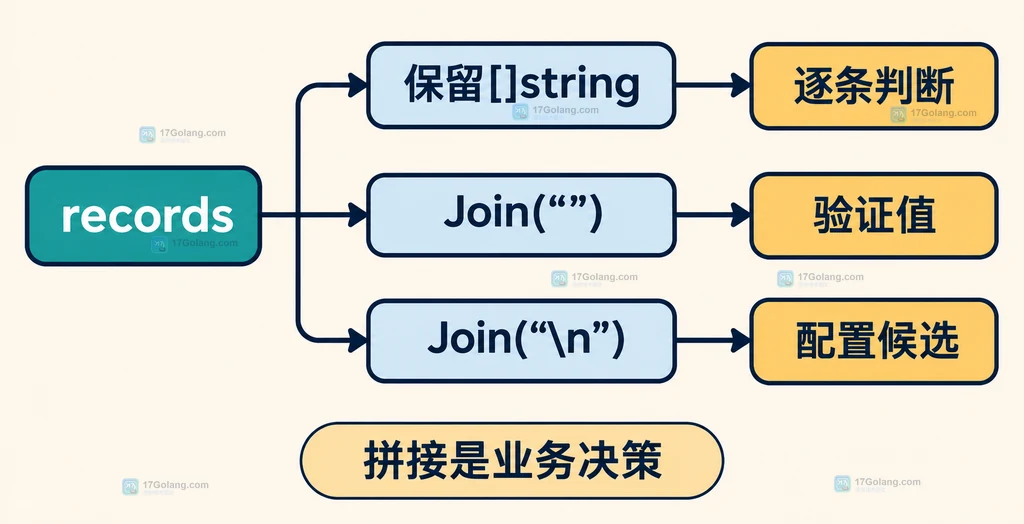
如果协议明确规定“多个返回元素组成一个文本配置”,再选择分隔符。例如配置格式规定每个元素是一行,就使用 strings.Join(records, "\n");如果规定元素之间没有分隔符,才使用空字符串。分隔符来自协议,不来自 API 的返回类型。
把空结果、超时和多条记录处理完整
空切片不等于空字符串
查询没有可用 TXT 记录时,应把 len(records) == 0 当作一种明确状态。不要直接取 records[0],也不要把空切片转换成一个“验证失败”的模糊字符串。上面的工具在空结果时直接结束,就是为了让调用方决定是跳过、重试还是报告配置缺失。
超时错误要保留上下文
DNS 查询经过本地解析器或网络链路,可能遇到超时、服务器失败或名称不存在。查询函数返回错误时保留 err,日志中同时带上域名;不要把所有错误都改写成“没有 TXT”。对于域名验证服务,可以把超时和“没有匹配记录”分成不同的业务状态。
多条记录要先建立选择规则
常见规则有三种:
- 域名验证:逐条匹配固定前缀或完整值,匹配成功即结束。
- 配置发现:保留
[]string,逐条解析为候选项,不提前拼接。 - 多行文本:只有配置协议把每条 TXT 定义为一行时,才用换行符连接。
什么时候该保留切片,什么时候才 Join
| 场景 | 推荐结果 | 原因 |
|---|---|---|
| 寻找一条域名验证值 | 保留切片并逐条匹配 | 不同记录可能属于不同服务或不同验证任务 |
| 读取多个配置候选 | 保留 []string | 切片边界就是候选边界,便于逐项解析 |
| 协议定义为多行文本 | Join(records, "\n") | 换行符是协议的一部分 |
| 协议定义为单一连续值 | 使用规定的分隔符 Join | 连接规则由业务协议保证,而不是由 LookupTXT 猜测 |
最后再强调一次:一条 TXT 记录内部的多个字符串片段,已经由 Go 作为一个切片元素返回;strings.Join 面对的是多条记录。前者是 DNS 记录内部的表示细节,后者是应用是否合并多个记录的选择。
常见追问
LookupTXT 返回多个元素,是不是说明一条 TXT 被截断了?
不一定。多个元素通常表示查询结果中有多条 TXT 记录;同一条记录内部的多个字符串片段,Go 文档已经说明会连接成一个字符串。是否需要继续合并,要看域名发布方和你的业务协议。
能不能只使用 net.LookupTXT?
可以做简单查询,但它使用后台上下文,调用方不能直接传入超时。命令行工具、HTTP 请求或定时任务更适合使用 Resolver.LookupTXT 并传入自己的 context.Context。
为什么要保留原始 records?
因为验证、配置发现和多行文本对边界的要求不同。保留切片能让业务层选择逐条匹配、解析候选或按协议拼接,也方便记录问题时看到每条原始值。
小结:LookupTXT 的正确使用顺序是“读取 → 保留记录边界 → 按协议消费”。不要把返回的多个字符串自动当成一条 TXT,也不要用同义词替代明确的拼接规则。
 Go net.Resolver.LookupNetIP 怎样只取 IPv4 或 IPv6 结果