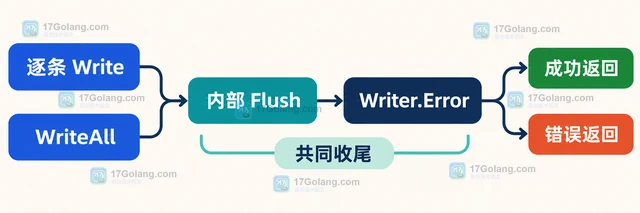
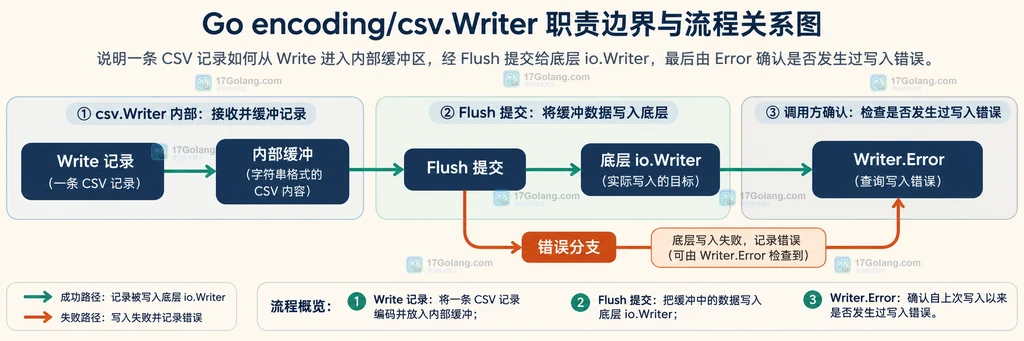
我在排查 CSV 导出时遇到过一个很容易误判的现象:循环里的 Writer.Write 次次返回 nil,任务也正常结束,但最终文件并没有完整写到目标流。原因通常不是 CSV 格式,而是把“写入内部缓冲”误当成了“已经提交给底层 Writer”。
稳妥结论很简单:逐条调用 Write 后,先调用 Flush,再调用 Error。只有这三个阶段都没有错误,才能说这次导出在 csv.Writer 这一层完成。官方文档入口:https://pkg.go.dev/encoding/csv。
Write 返回成功,为什么还不能宣布导出完成
encoding/csv 的 Writer 默认会把单条记录写入自己的缓冲区。Write 返回 nil,主要说明当前记录已经通过 CSV 编码并交给了这层缓冲逻辑;它不等价于底层文件、网络连接或自定义 io.Writer 已经接收全部字节。
Flush 没有返回值,它负责把缓冲内容推给底层 Writer。刷新阶段产生的错误要通过 Writer.Error 读取。这个 API 设计正是许多“前面都成功,最后文件却截断”问题的根源。
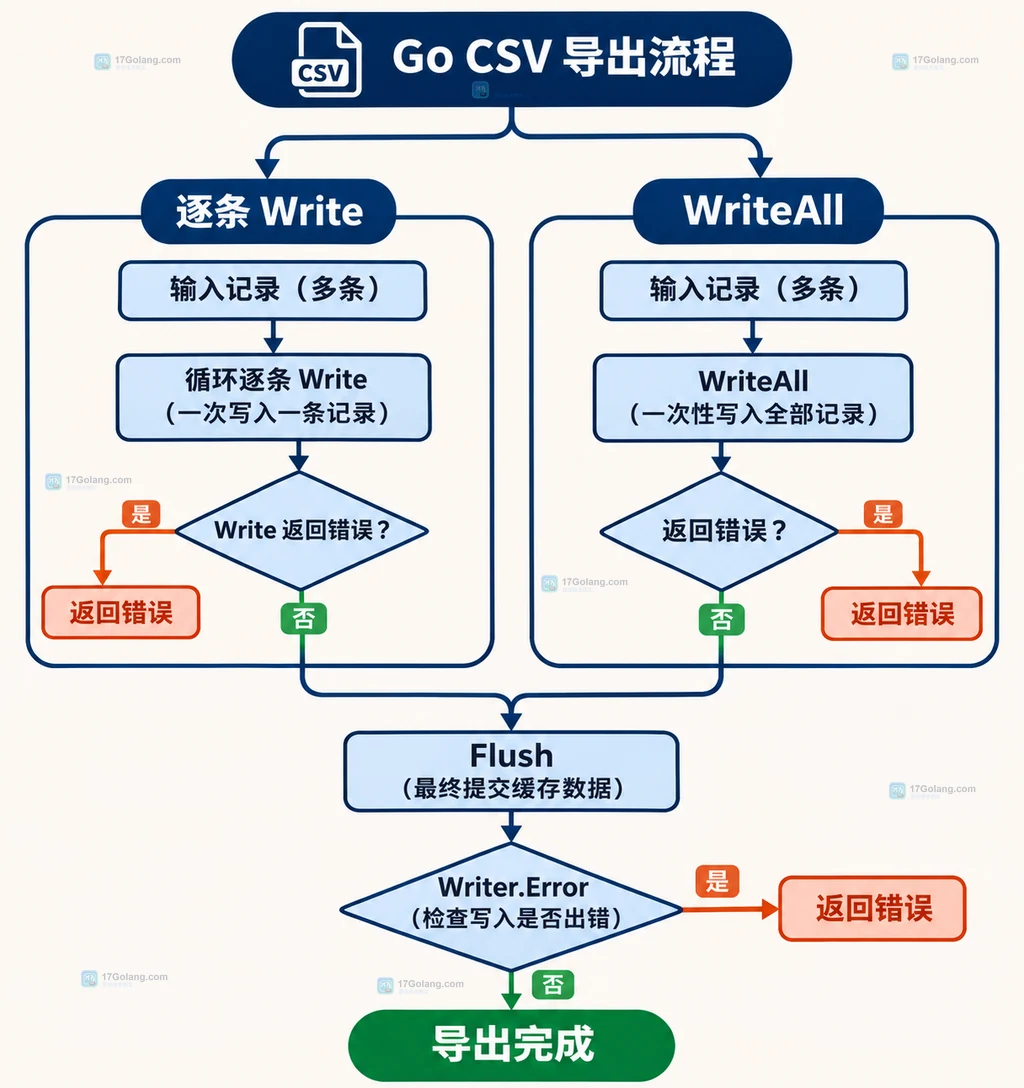
逐条导出时,Write、Flush、Error 应该按什么顺序
把错误检查分成两个位置:每条记录检查一次 Write,所有记录完成后统一检查 Flush 产生的状态。下面的函数只关注 CSV Writer 这一层,调用方可以把它接到文件、HTTP 响应或其他实现了 io.Writer 的目标上。
package csvexport

import (
    "encoding/csv"
    "fmt"
    "io"
)

func writeRows(dst io.Writer, rows [][]string) error {
    writer := csv.NewWriter(dst)

    for index, row := range rows {
        // Write 可能在编码或写入内部缓冲时就发现错误,因此逐条保留上下文。
        if err := writer.Write(row); err != nil {
            return fmt.Errorf("写入第 %d 条 CSV 记录失败: %w", index+1, err)
        }
    }

    // Flush 没有返回值;它把 csv.Writer 的缓冲数据提交给底层 Writer。
    writer.Flush()

    // Error 会报告此前 Write 或 Flush 阶段记录下来的错误。
    if err := writer.Error(); err != nil {
        return fmt.Errorf("刷新 CSV 导出失败: %w", err)
    }
    return nil
}
这里的顺序不要改成“循环结束后只看最后一次 Write”。如果最后一条记录只进入了缓冲区,最后一次 Write 仍可能是成功的;真正失败的时刻发生在后续 Flush 尝试调用底层 Writer 时。
用一个会失败的底层 Writer 看清延迟错误
为了理解检查点,可以构造一个只允许写入固定字节数的底层 Writer。它不是生产环境组件,只用于说明:缓冲区尚未满时,Write 可以先成功;当 Flush 真正向底层 Writer 推送数据时,错误才被记录下来。
type failAfterWriter struct {
    limit int
    used  int
}

func (w *failAfterWriter) Write(p []byte) (int, error) {
    // 模拟磁盘空间不足或网络写入中断,只接受 limit 以内的字节。
    remain := w.limit - w.used
    if remain <= 0 {
        return 0, io.ErrShortWrite
    }
    if len(p) > remain {
        w.used += remain
        return remain, io.ErrShortWrite
    }
    w.used += len(p)
    return len(p), nil
}

func exportWithFailure(rows [][]string) error {
    // limit 较小,用来让错误在最终 Flush 阶段暴露。
    dst := &failAfterWriter{limit: 8}
    writer := csv.NewWriter(dst)

    for _, row := range rows {
        // 每次只检查当前记录的编码和缓冲过程。
        if err := writer.Write(row); err != nil {
            return fmt.Errorf("Write 阶段失败: %w", err)
        }
    }
    // 真正把数据交给 dst,底层限制会在这里生效。
    writer.Flush()
    if err := writer.Error(); err != nil {
        return fmt.Errorf("Flush 阶段失败: %w", err)
    }
    return nil
}
这个例子里,成功的判定不是“循环跑完了”,而是 writer.Error() == nil。如果底层 Writer 返回短写或其他错误,Error 会把它带回调用方。实际项目中应保留原始错误,便于判断是空间、连接还是自定义 Writer 的实现问题。
Flush 后的 Error 到底检查了什么
从标准库实现看,Flush 调用内部 bufio.Writer.Flush,而 Error 通过一次空写读取缓冲 Writer 记录的错误。它报告的是此前 Writer.Write 或 Writer.Flush 发生过的错误,不会替调用方验证业务数据是否符合预期。
因此要区分两个概念:
| 检查结果 | 能说明什么 | 不能说明什么 |
|---|---|---|
Write 返回错误 | 当前记录没有可靠地完成交给 Writer | 不能继续把本次导出当成完整结果 |
Flush 后 Error 非空 | 最终提交到下层时出现了错误 | 不能只重试最后一条记录来修复整个文件 |
Flush 后 Error 为 nil | csv.Writer 这一层没有记录写入或刷新错误 | 不替代业务行数、字段内容和外层资源关闭检查 |
也就是说,“导出是否完整”在本文范围内是一个分层结论:CSV 编码器确认没有错误,不等于业务校验和、文件命名或上传流程都完成了。把边界说清楚,排障时才不会把不同层的问题混在一起。
使用 WriteAll 时,还要不要手动调用 Error
WriteAll 是另一种更短的写法。标准库会逐条调用 Write,最后执行刷新,并把刷新阶段的错误作为返回值交给调用方。因此只使用 WriteAll 时,优先检查它的返回值:
func writeAllRows(dst io.Writer, rows [][]string) error {
    writer := csv.NewWriter(dst)

    // WriteAll 内部负责逐条 Write,并在末尾完成 Flush。
    if err := writer.WriteAll(rows); err != nil {
        return fmt.Errorf("CSV 批量导出失败: %w", err)
    }
    return nil
}
这里不必为了形式再补一次 writer.Error。但如果代码在同一个 Writer 上混用了手动 Write、显式 Flush 和其他操作,就回到前面的显式收尾模板;不要只凭某一次调用的返回值推断整个导出状态。
我现在会用这份清单判断导出结果
- 逐条写入时,每一次
Write都检查返回值,并把记录序号加入错误上下文。 - 循环正常结束后调用一次
Flush,不要把它省略掉。 - 因为
Flush没有返回值,所以紧接着调用Error。 Error非空时,整次导出按失败处理,不把已经生成的部分文件当作完整结果。- 使用
WriteAll时直接检查它的返回值;混合调用时仍按显式收尾规则处理。
最后记住一句话:Write 负责把记录交给 CSV Writer,Flush 负责把缓冲交给底层,Error 负责确认这两个阶段有没有留下错误。逐条导出只检查第一步,永远少看了最后一个关键检查点。
常见追问
为什么 Flush 不直接返回 error?
这是 csv.Writer 的接口设计,刷新后的错误通过 Error 读取。调用方应把 Flush 与 Error 视为一个连续的收尾动作。
Write 返回错误后还能继续写吗?
不建议把当前 Writer 当成可恢复的正常输出继续使用。保留原始错误并终止本次导出,更容易避免把部分结果误报为完整结果。
检查 Error 能保证文件已经落盘吗?
不能无限扩大这个结论。它确认的是 csv.Writer 到底层 io.Writer 的写入与刷新状态;文件关闭、同步和后续传输仍属于外层流程。
 Go bufio.Reader.UnreadRune 失败时怎样避免读取位置错乱