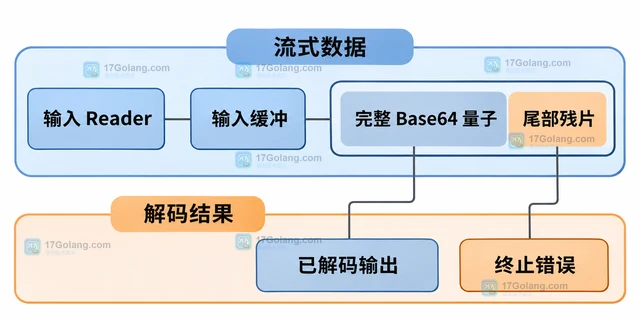
Go 的 base64.NewDecoder 不是“读到一小段就立刻解码一小段”的简单包装。它会先缓存不足一个完整 Base64 量子的字符,只有底层输入结束,才知道这些字符是正常的无填充尾部、缺失填充的标准编码,还是被截断的数据。
官方地址:https://pkg.go.dev/encoding/base64#NewDecoder
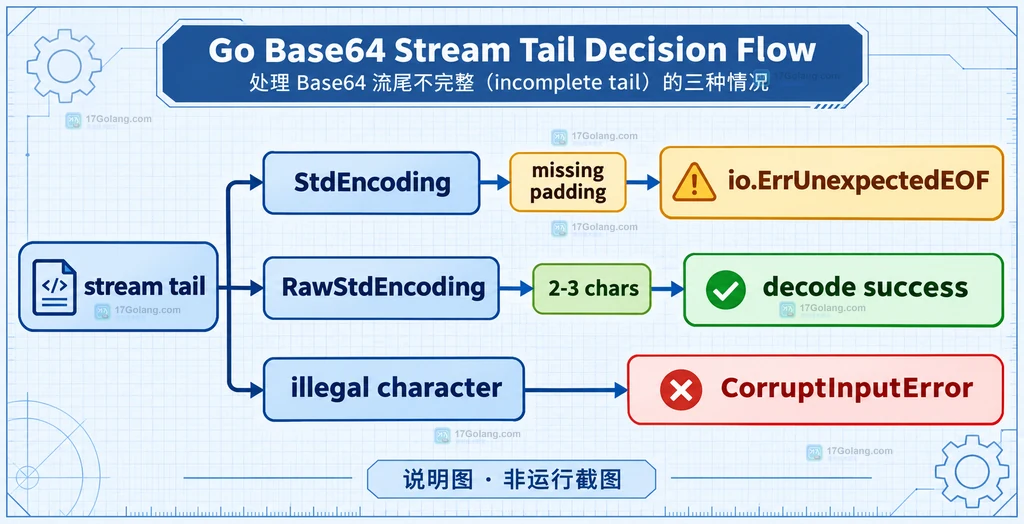
处理结果可以先记成三句话:使用 StdEncoding 时,流末尾剩下 1~3 个字符通常会在 EOF 后得到 io.ErrUnexpectedEOF;使用 RawStdEncoding 时,合法的 2 或 3 个字符尾部可以解出最后的 1~2 个字节;遇到非法字符或错误填充,则应按 base64.CorruptInputError 排查,而不是把它当成网络暂时没读完。
NewDecoder 为什么要等到 EOF 才判断尾部
NewDecoder 返回一个新的 Base64 流读取器。Base64 的标准编码按 4 个字符组成一个量子,解码后通常对应 3 个字节。底层 io.Reader 一次返回 1 个字符、半个量子或恰好 4 个字符,都不代表输入已经损坏;流式读取器需要把这些分块重新拼起来。
Go 的实现会过滤输入中的回车和换行,并在内部保存尚未组成完整量子的字符。完整的 4 字符块可以继续产生输出;如果底层已经返回 EOF,但缓冲区还剩字符,读取器才进入尾部判断。
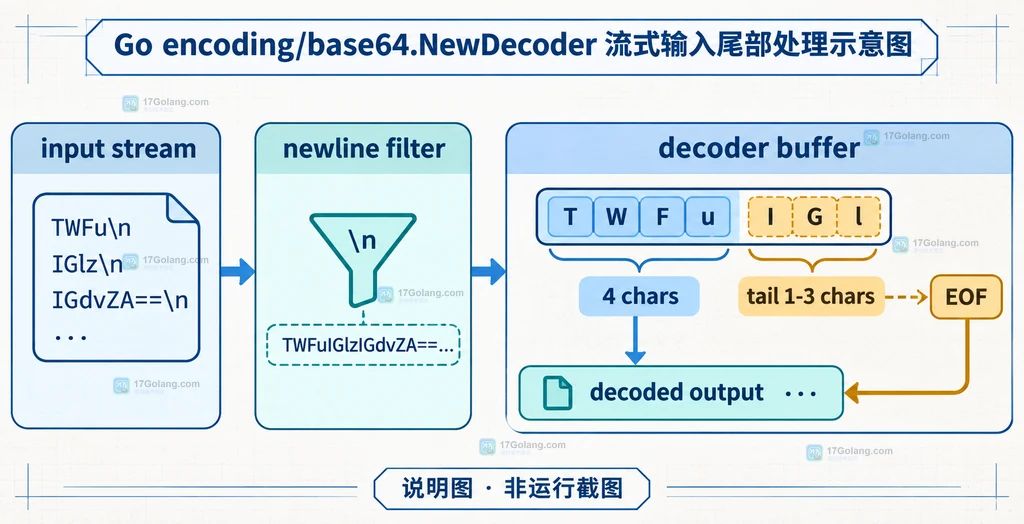
因此,不能因为某一次底层 Read 只拿到 2 个字符,就立即返回“数据不完整”。真正需要区分的是:后面还会不会有数据,以及当前使用的编码是否允许无填充尾部。
StdEncoding 缺少尾部字符时会返回什么
base64.StdEncoding 使用 = 作为填充字符。比如字符串 SGVsbG8= 才是完整的“Hello”标准 Base64;如果传输在最后一个字符前结束,输入会变成 SGVsbG8。对 NewDecoder 来说,底层 EOF 到达时仍有未完成的量子,于是下一次读取会得到 io.ErrUnexpectedEOF。
package main

import (
    "bytes"
    "encoding/base64"
    "errors"
    "fmt"
    "io"
)

func main() {
    // 标准填充编码故意去掉最后的 '=',模拟传输在尾部被截断。
    source := bytes.NewBufferString("SGVsbG8")
    decoder := base64.NewDecoder(base64.StdEncoding, source)

    decoded, err := io.ReadAll(decoder)
    fmt.Printf("decoded=%q err=%v\n", decoded, err)
    // 没有完整的四字符量子时,EOF 会被转换成 UnexpectedEOF。
    fmt.Println("truncated:", errors.Is(err, io.ErrUnexpectedEOF))
}
这里要注意两个细节。第一,io.ReadAll 可能已经拿到前面完整量子对应的部分输出,但仍然返回错误,调用方不能因为 decoded 非空就把整条消息当成成功。第二,io.ErrUnexpectedEOF 表示“输入在结构上提前结束”,它和某个字符不在 Base64 字母表中的 CorruptInputError 不是一回事。
StdEncoding 和 RawStdEncoding 的尾部结果不同
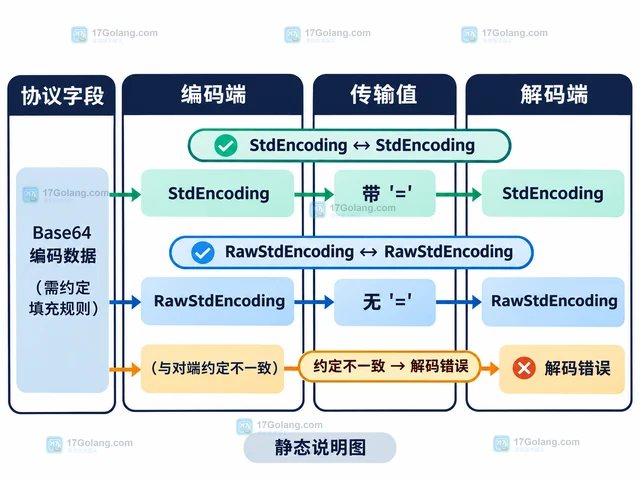
如果协议明确规定不使用填充,应改用 base64.RawStdEncoding。它允许最后保留 2 或 3 个 Base64 字符,分别对应 1 或 2 个解码字节;只有 1 个字符无法组成有效的无填充尾部。不要为了“让读取成功”而盲目把任意标准编码切换成 Raw 编码,编码规则必须由协议约定。
package main

import (
    "bytes"
    "encoding/base64"
    "fmt"
    "io"
)

func readRawTail(input string) ([]byte, error) {
    // RawStdEncoding 的协议前提是:发送端同样省略 '=' 填充。
    decoder := base64.NewDecoder(base64.RawStdEncoding, bytes.NewBufferString(input))
    // ReadAll 会把流式解码器产生的所有完整输出收集起来。
    data, err := io.ReadAll(decoder)
    return data, err
}

func main() {
    data, err := readRawTail("SGVsbG8")
    fmt.Printf("data=%q err=%v\n", data, err)
}
在这个例子里,RawStdEncoding 可以把没有 = 的尾部解释为合法的 2~3 字符片段。相反,如果输入包含 @ 这类不属于当前字母表的字符,错误应归类为 base64.CorruptInputError;如果标准编码只缺少必要填充,则优先按不完整输入处理。
读取循环必须先处理 n,再处理 err
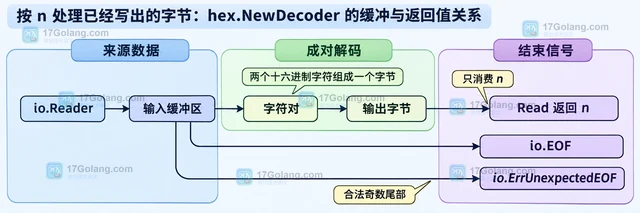
自定义读取循环时,不能写成“只要 err != nil 就丢弃本次数据”。Go 的 io.Reader 允许一次返回已经读到的字节,同时返回一个错误;调用方应先消费 n > 0 的数据,再判断错误是否结束了本次会话。
func decodeStream(decoder io.Reader) ([]byte, error) {
    var result []byte
    buf := make([]byte, 256)

    for {
        n, err := decoder.Read(buf)
        // 先追加本次已经成功解码的字节,避免丢掉最后一小段输出。
        if n > 0 {
            result = append(result, buf[:n]...)
        }
        if err == nil {
            continue
        }
        if errors.Is(err, io.EOF) {
            // 正常结束:完整输入已经读完。
            return result, nil
        }
        // UnexpectedEOF、CorruptInputError 或上游网络错误都要交给上层分类。
        return result, err
    }
}
上面代码需要引入 errors 包。对于 NewDecoder,标准填充编码的截断尾部通常会在没有新的输出后返回 io.ErrUnexpectedEOF;这时应保留前面已经追加的结果,但把整条消息标记为失败,除非业务协议明确允许恢复。
如何区分暂时没读完和已经截断
判断关键不在“当前缓冲区有几个字符”,而在底层读取器是否已经给出结束信号。
- 还没有 EOF:只拿到半个量子是正常的,继续等待后续数据,不要手动追加
=。 - 收到 EOF 且使用 StdEncoding:尾部仍不足完整量子时,按
io.ErrUnexpectedEOF处理。若协议支持重试,可以重新获取原始数据,而不是猜测缺失字符。 - 收到 EOF 且使用 RawStdEncoding:2 或 3 个合法字符可以作为无填充尾部;1 个字符仍然无法形成有效结果。
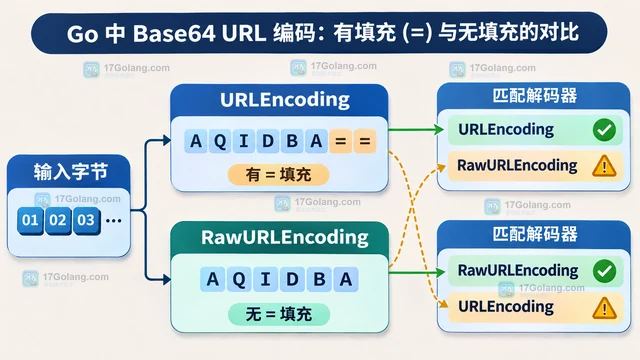
- 出现 CorruptInputError:检查字母表、URL 版与标准版的选择、填充位置以及中间是否混入了未过滤的字符。
- 上游返回其他错误:保留已解码数据用于诊断,但不要把它改写成 Base64 格式错误;网络超时、校验失败和输入截断的恢复策略不同。
如果数据来自 HTTP、消息队列或分片文件,最好在 Base64 字符串之外保存原始长度、分片序号或消息结束标记。这样消费端能把“还在等待下一片”和“最后一片已经损坏”区分开。
不要用字符串补齐掩盖传输问题
标准 Base64 缺少填充时,有人会根据长度直接补 =。这种做法只有在协议明确规定“填充在传输层被删除”,并且输入已经确认完整时才合理。对一个可能被截断的网络流,自动补齐会把丢失数据伪装成合法消息,甚至让后续 JSON、签名或压缩数据在更晚的位置才失败。
func decodeCompleteMessage(encoded []byte) ([]byte, error) {
    // 只有业务层已经确认消息完整,才允许按协议补充标准填充。
    if len(encoded)%4 != 0 {
        return nil, fmt.Errorf("Base64 消息长度不完整: %d", len(encoded))
    }
    data, err := base64.StdEncoding.DecodeString(string(encoded))
    if err != nil {
        return nil, fmt.Errorf("Base64 内容无效: %w", err)
    }
    return data, nil
}
如果协议本来就是无填充 Base64,应在入口处固定使用 RawStdEncoding 或对应的 URL 版本;如果协议是标准填充 Base64,就应让发送端正确输出填充,并在接收端把 UnexpectedEOF 当作可观测的输入质量问题。
小结
| 输入情况 | 编码 | 典型结果 | 处理建议 |
|---|---|---|---|
| 完整四字符量子 | Std/Raw | 继续产生解码输出 | 正常读取 |
| EOF 时剩 1~3 个字符 | StdEncoding | io.ErrUnexpectedEOF | 按截断或协议错误处理 |
| EOF 时剩 2~3 个合法字符 | RawStdEncoding | 可解码尾部 | 确认协议允许无填充 |
| 非法字符或错误填充 | 任一 | base64.CorruptInputError | 检查字母表与输入清洗 |
最实用的判断顺序是:先确认编码规则,再区分底层是否 EOF,最后按具体错误类型决定重试、等待还是拒绝。NewDecoder 已经替你处理了跨分块缓存,调用方真正要做的是保留部分输出,并把“不完整”和“非法”分开。
相关问题
- 为什么底层只返回半个 Base64 量子时没有立刻报错?因为流式解码器需要等待后续分块,当前分块边界不等于消息边界。
io.ErrUnexpectedEOF和CorruptInputError有什么区别?前者表示输入提前结束,后者表示字符或填充不符合编码规则。- 标准 Base64 能否直接改用
RawStdEncoding?只有上下游协议都约定省略填充时才能这样做。 - 已经解码出的部分数据要不要保留?可以用于诊断或重试定位,但只要尾部错误未被协议允许,就不应把整条消息视为成功。
 Go Base64 流式编码后为什么少了尾部字符