
Go问答:strconv.ParseInt进制参数怎样决定有效输入为什么转换结果不符合预期
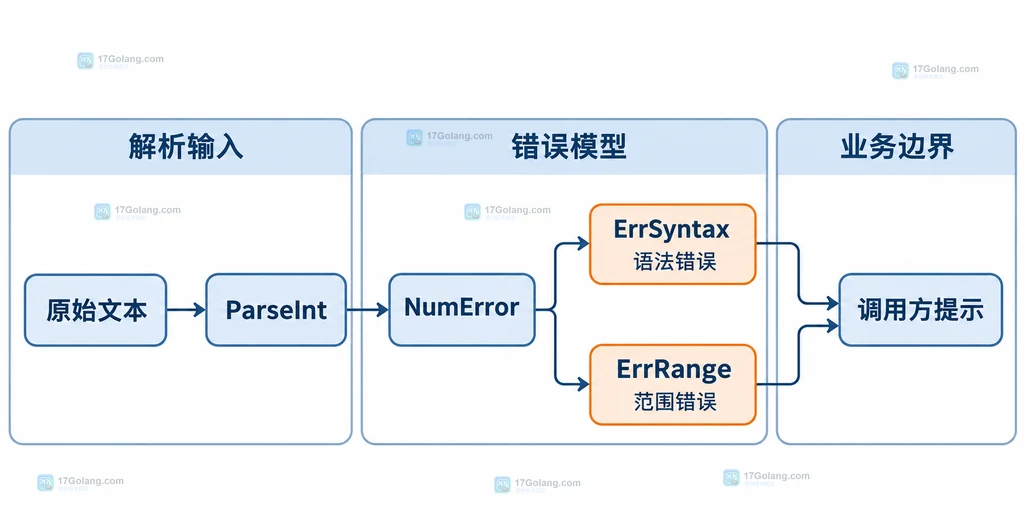
如果你发现同一段字符串交给 strconv.ParseInt 后,有时能解析、有时却返回语法错误,先看第三个参数:base 不是“输出格式”,而是输入数字的进制契约。base=0 会根据 0b、0o、0x 等前缀推断进制;传入具体进制时,则按固定进制解释字符,不应再把自动前缀识别当成默认行为。
另外,bitSize 决定结果必须放得下哪一种有符号整数,错误值需要通过 *strconv.NumError 区分是输入语法不对,还是数值超出了目标范围。官方文档地址:https://pkg.go.dev/strconv#ParseInt
先把 base 当成输入协议
ParseInt(s, base, bitSize) 的 base 可以是 0,也可以是 2 到 36。零值模式适合输入本身带有 Go 整数字面量风格前缀的场景:
0b或0B表示二进制;0o或传统的前导0表示八进制;0x或0X表示十六进制;- 没有这些前缀时按十进制处理;只有
base=0时,下划线才按 Go 整数字面量规则参与识别。
固定进制适合协议已经明确约定格式的字段。例如字段写在数据库或配置文档里就是十进制,就直接传 10;如果用户可以选择二进制、八进制或十六进制,才考虑把前缀识别交给 base=0。不要因为字符串看起来像十六进制,就在固定 base=16 时继续期待 0x 会替你完成自动切换。
为什么看似正确的输入仍然会失败
最常见的误判有三类。第一,输入带空格,而 ParseInt 不会替你清理空白;是否允许空格应该由调用方明确决定。第二,调用方选择了固定进制,却把带前缀的文本直接交给它。第三,调用方使用 base=0,但输入中的字符或下划线位置不符合整数字面量规则。
可以先用一组输入契约把差异写清楚,再决定解析策略:
package main

import (
    "fmt"
    "strconv"
)

func main() {
    samples := []struct {
        text string
        base int
    }{
        {text: "0x2a", base: 0},  // 让前缀参与进制推断。
        {text: "101010", base: 2}, // 明确约定输入只写二进制数字。
        {text: "42", base: 10},    // 配置字段按十进制读取。
    }

    for _, sample := range samples {
        // bitSize=64 表示结果必须落在 int64 的范围内。
        value, err := strconv.ParseInt(sample.text, sample.base, 64)
        if err != nil {
            // 生产代码应把原始输入和业务字段一起记录,便于定位协议不一致。
            fmt.Printf("parse %q failed: %v\n", sample.text, err)
            continue
        }
        fmt.Printf("%q -> %d\n", sample.text, value)
    }
}
这段示例的重点不是把所有情况塞进一个函数,而是让输入格式与 base 成对出现。若协议要求十进制,就不要为了“更灵活”而偷偷改成 base=0,否则带前缀的输入可能被当成合法值,业务层反而失去约束。
让 bitSize 与目标类型保持一致
bitSize 的取值为 0、8、16、32 或 64。其中 0 按 int 的语义处理,其他值对应 int8、int16、int32 和 int64 的范围。返回值的静态类型仍是 int64,但解析时会先按照指定宽度判断是否越界。
因此,如果最终字段是 int32,解析时就传 32,不要先用 64 接收,再把结果强转成 int32。后者可能把“输入超出业务字段范围”的错误推迟到更远的位置,定位起来更困难。
| 场景 | base | bitSize | 策略 |
|---|---|---|---|
| 明确十进制配置 | 10 | 按目标类型 | 拒绝意外前缀,协议更严格 |
| 允许 Go 风格整数字面量 | 0 | 按目标类型 | 让前缀决定进制,并接受规则内下划线 |
| 固定二进制字段 | 2 | 按目标类型 | 只接受二进制数字字符 |
用 NumError 区分语法错误和范围错误
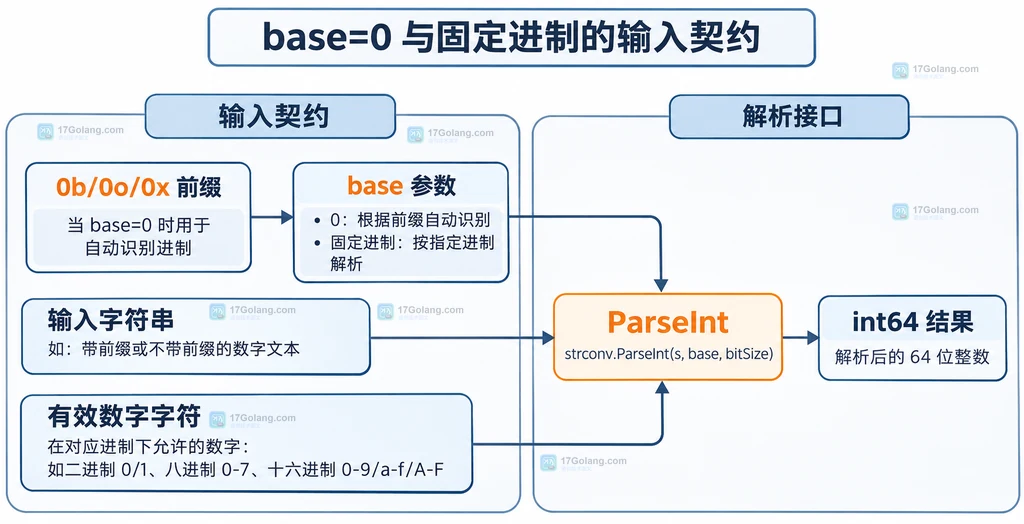
只判断 err != nil 当然能阻止错误值继续流转,但无法告诉用户是“格式写错”还是“数字太大”。ParseInt 返回的错误带有 *strconv.NumError,其中 ErrSyntax 表示空字符串或包含不允许的数字字符,ErrRange 表示数值无法放进指定的有符号位宽。
处理时可以先用 errors.As 取出 NumError,再用 errors.Is 判断其内部原因:
package parser

import (
    "errors"
    "fmt"
    "strconv"
    "strings"
)

func parseCount(raw string) (int32, error) {
    // 是否允许首尾空白是业务规则;这里选择在解析前统一清理。
    text := strings.TrimSpace(raw)
    value, err := strconv.ParseInt(text, 10, 32)
    if err == nil {
        // 显式转换前已经用 bitSize=32 限定了可接受范围。
        return int32(value), nil
    }

    var numErr *strconv.NumError
    if errors.As(err, &numErr) {
        // 用底层错误分类给调用方返回稳定、可读的提示。
        switch {
        case errors.Is(numErr.Err, strconv.ErrSyntax):
            return 0, fmt.Errorf("count must be a decimal integer: %q", text)
        case errors.Is(numErr.Err, strconv.ErrRange):
            return 0, fmt.Errorf("count is outside int32 range: %q", text)
        }
    }
    return 0, fmt.Errorf("parse count: %w", err)
}
这里故意选择 base=10,因为 count 是业务字段而不是 Go 源码字面量。若字段约定允许 0x 或 0b,再把协议改成 base=0,并在文档中明确这一点。
把选择规则收进一个小函数
实际项目里最容易出错的不是函数调用本身,而是不同入口对同一个字段采用了不同的 base。可以先给每个字段定义输入协议,再把解析入口固定下来:
type IntegerPolicy struct {
    Base     int
    BitSize  int
    TrimSpace bool
}

func parseByPolicy(raw string, policy IntegerPolicy) (int64, error) {
    text := raw
    if policy.TrimSpace {
        // 只有策略允许时才去除空白,避免悄悄改变原始协议。
        text = strings.TrimSpace(text)
    }
    if policy.Base != 0 && (policy.Base  36) {
        // 在调用 strconv 前拒绝明显无效的进制配置。
        return 0, fmt.Errorf("unsupported base: %d", policy.Base)
    }
    if policy.BitSize != 0 && policy.BitSize != 8 && policy.BitSize != 16 && policy.BitSize != 32 && policy.BitSize != 64 {
        // bitSize 只接受 strconv 文档规定的位宽。
        return 0, fmt.Errorf("unsupported bit size: %d", policy.BitSize)
    }
    return strconv.ParseInt(text, policy.Base, policy.BitSize)
}
这个封装把“是否清理空白、是否允许自动进制、结果宽度”放到一个可读的策略对象里。配置加载、命令行解析和 HTTP 参数读取都可以复用它,但不要把所有输入都强行设为同一策略:字段协议不同,base 和 bitSize 也应不同。
最后用四个问题快速定位
- 输入是否允许
0b、0o、0x?允许时才使用base=0。 - 输入是否可能带首尾空白?若允许,先明确调用方是否
TrimSpace。 - 结果最终要放进
int8、int32还是int64?按目标类型选择bitSize。 - 错误是
ErrSyntax还是ErrRange?前者修输入格式,后者调整值或字段范围。
一句话总结:base 决定哪些字符组合属于合法输入,bitSize 决定合法数字能否放进目标范围,NumError 则把两类失败原因交给调用方分别处理。把这三件事写进字段协议,ParseInt 的“为什么结果不符合预期”通常就能在入口处解决。
相关问题
- ParseInt 为什么不自动去掉空格? 因为空白是否允许属于字段协议,调用方应显式决定是否清理。
- 固定 base 时能不能继续写 0x 前缀? 如果依赖前缀自动识别,应使用
base=0;固定进制要按该进制的数字字符约定输入。 - ParseInt 返回 0 就是解析失败吗? 不是,合法输入
0也会返回 0,应始终结合err判断。
 Go问答:regexp.Regexp LiteralPrefix正则查询怎样利用固定前缀减少扫描怎样完成一个可复用的最小示例
- 上一篇
- Go问答:regexp.Regexp LiteralPrefix正则查询怎样利用固定前缀减少扫描怎样完成一个可复用的最小示例
- 下一篇
- Go问答:debug/elf.SectionByType 找不到节时怎样区分类型缺失和解析失败
-
- Golang · Go问答 | 9分钟前 |
- Go问答:bufio.Reader Discard读取失败后怎样丢弃残留缓冲区为什么结果为空或不符合预期
- 273浏览 收藏
-
- Golang · Go问答 | 11分钟前 |
- Go问答:bufio.Writer.Buffered怎样判断 Flush 前还有多少数据怎样完成一个可复用的最小示例
- 414浏览 收藏
-
- Golang · Go问答 | 14分钟前 | 错误处理 · go · Go问答 · Go ELF debug/elf SectionByType SHT_SYMTAB SHT_DYNSYM
- Go问答:debug/elf.SectionByType 找不到节时怎样区分类型缺失和解析失败
- 468浏览 收藏
-
- Golang · Go问答 | 21分钟前 | regexp · Go问答 · 正则表达式 Go 性能优化 regexp.Regexp LiteralPrefix 字符串筛选
- Go问答:regexp.Regexp LiteralPrefix正则查询怎样利用固定前缀减少扫描怎样完成一个可复用的最小示例
- 254浏览 收藏
-
- Golang · Go问答 | 24分钟前 |
- Go问答:text/template.Clone 复制模板后怎样独立修改 FuncMap
- 469浏览 收藏
-
- Golang · Go问答 | 26分钟前 |
- Go问答:crypto/rand.Read 返回错误后还能不能使用缓冲区怎样处理失败结果
- 154浏览 收藏
-
- Golang · Go问答 | 30分钟前 |
- Go问答:regexp.Regexp FindAllSubmatchIndex正则怎样返回匹配位置而不是文本怎样完成一个可复用的最小示例
- 182浏览 收藏
-
- Golang · Go问答 | 33分钟前 |
- Go问答:database/sql/driver.DriverContext 怎样让驱动按 DSN 创建连接
- 481浏览 收藏
-
- Golang · Go问答 | 35分钟前 |
- Go问答:database/sql StmtContext 让预编译语句继承请求上下文的用法与边界
- 170浏览 收藏
-
- Golang · Go问答 | 54分钟前 |
- Go问答:sql.TxOptions Isolation事务隔离级别设置后为什么看不到变化怎样完成一个可复用的最小示例
- 455浏览 收藏
-
- Golang · Go问答 | 57分钟前 |
- Go问答:sql.RowsAffected返回 0 时怎样区分没有匹配和事务未提交
- 344浏览 收藏
-
- Golang · Go问答 | 59分钟前 |
- Go问答:sql.NullString数据库 NULL 扫描后为什么变成空字符串为什么结果为空或不符合预期
- 172浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 964次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 964次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1076次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1053次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 884次使用
-
- 用Nginx反向代理部署go写的网站。
- 2023-01-17 502浏览
-
- GoLand调式动态执行代码
- 2023-01-13 502浏览
-
- Go flag.FlagSet ContinueOnError 怎么捕获帮助输出和解析错误
- 2026-11-05 501浏览
-
- Go netip.ParseAddr 为什么拒绝带端口字符串
- 2026-11-03 501浏览
-
- Go generate 未执行指令的注释与目录检查
- 2026-10-28 501浏览


