
Go testing.B怎样让基准测试报告自定义指标怎样完成一个可复用的最小示例
我在给排序、解析这类基准补充“每次操作做了多少工作”时,最容易踩的坑不是不会调用 testing.B,而是把累计值、单次值和计时混在一起。Go 的 b.ReportMetric 正好解决了这个问题:在基准主体完成后,把自定义数值和无空白单位写入标准基准报告。
官方文档:https://pkg.go.dev/testing
核心做法是先在循环中累计业务指标,结束后按指标含义除以b.N或b.Elapsed(),再调用b.ReportMetric。单位要稳定、不能含空白,重复上报同一单位时后一次会覆盖前一次。
先把“总量”和“每次操作”分开
默认的 ns/op 是测试框架根据计时得到的结果,但排序比较次数、解析字段数、命中条数等业务指标并不会自动出现。它们通常先以总量累加,最后再换算成每次基准操作的平均值。
下面的示例用一个小切片排序,并把比较次数报告为 compares/op。代码使用当前文档推荐的 b.Loop 组织新基准;如果维护旧代码,也可以把循环条件换成 i 。
package bench

import (
    "cmp"
    "slices"
    "testing"
)

func BenchmarkSortCompareCount(b *testing.B) {
    var compares int64

    for b.Loop() {
        values := []int{5, 4, 3, 2, 1}
        slices.SortFunc(values, func(a, z int) int {
            // 每次比较都累加,循环外再换算成每个操作的平均值。
            compares++
            return cmp.Compare(a, z)
        })
    }

    // compares 是总量,/op 表示要报告每次操作的平均值。
    b.ReportMetric(float64(compares)/float64(b.N), "compares/op")
}
运行方式是 go test -bench=SortCompareCount -benchmem。输出会保留框架生成的 ns/op,并额外出现 compares/op;-benchmem 还会显示分配相关的内置指标。这里的重点是指标写入报告,不是用 fmt.Println 打印一行难以被基准工具消费的文本。
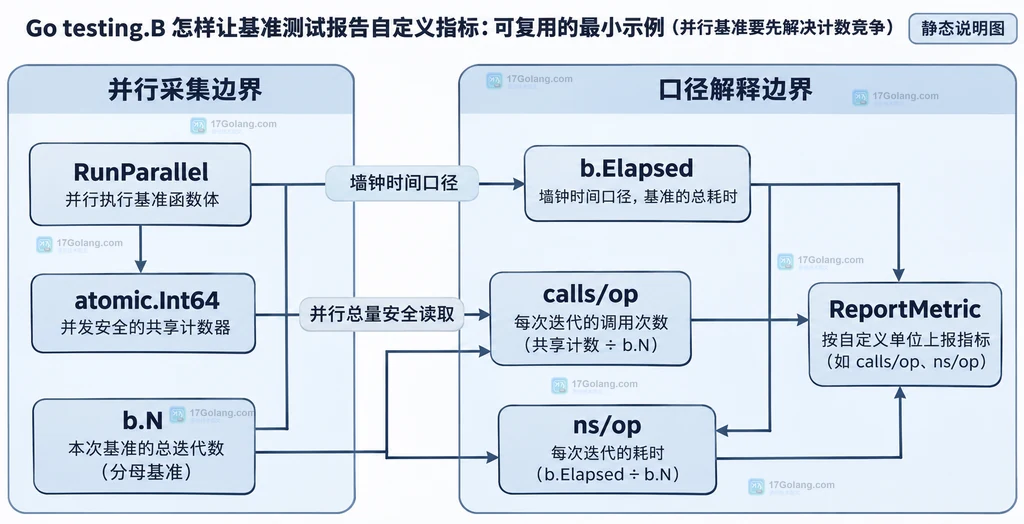
单位决定了读者如何解释数字
ReportMetric 的第二个参数不是装饰文本,而是结果字段的一部分。按操作统计时,使用 compares/op、items/op 这样的无空白单位;按时间统计时,可以使用 compares/ns,计算分母则应来自 b.Elapsed() 的纳秒数。
func BenchmarkParseReport(b *testing.B) {
    input := []byte("id=17&name=go")
    var fields int64

    for b.Loop() {
        // 这里仅演示业务计数,实际解析函数应返回真实字段数量。
        fields += int64(countFields(input))
    }

    // 每次操作的字段数适合 /op;不要把总字段数直接报成平均值。
    b.ReportMetric(float64(fields)/float64(b.N), "fields/op")
    // 处理速度按经过的纳秒统计,单位与分母保持一致。
    b.ReportMetric(float64(fields)/float64(b.Elapsed().Nanoseconds()), "fields/ns")
}

func countFields(input []byte) int {
    // 示例函数只返回分隔后的字段数量,避免把解析细节混入指标说明。
    if len(input) == 0 {
        return 0
    }
    return 2
}
单位必须非空,也不能包含空格或换行,否则会触发 panic。另一个容易忽略的行为是:同一个单位再次上报时会覆盖之前的值。因此可以先计算好最终结果,再对每个单位调用一次,避免同一指标在不同分支中留下难以判断的结果。
并行基准要先解决计数竞争
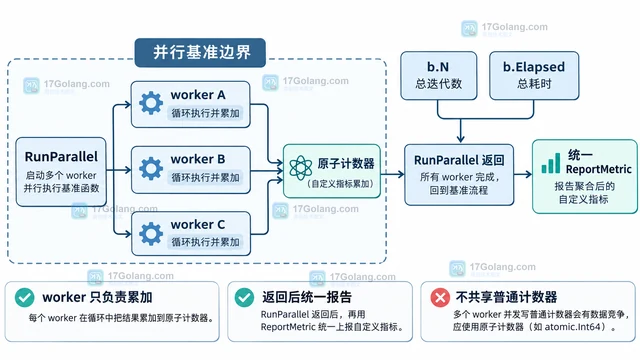
在 b.RunParallel 中,多个 goroutine 会共同完成 b.N 次迭代。普通的 int64++ 会产生数据竞争,最终的自定义指标可能偏小;应使用原子计数,并且等并行工作全部结束后再上报。
import (
    "sync/atomic"
    "testing"
)

func BenchmarkParallelCompareCount(b *testing.B) {
    var compares atomic.Int64

    b.RunParallel(func(pb *testing.PB) {
        for pb.Next() {
            // 并行 goroutine 共享计数器,必须使用原子加法。
            compares.Add(1)
        }
    })

    // RunParallel 返回后再读取总量,避免报告中途的部分结果。
    b.ReportMetric(float64(compares.Load())/float64(b.N), "calls/op")
}
这个片段需要额外导入 sync/atomic。并行基准中的 ns/op 是整个并行基准的墙钟时间口径,自定义的 calls/op 则是所有 goroutine 合计次数除以总迭代数,二者不能混成“每个 goroutine 的速度”。
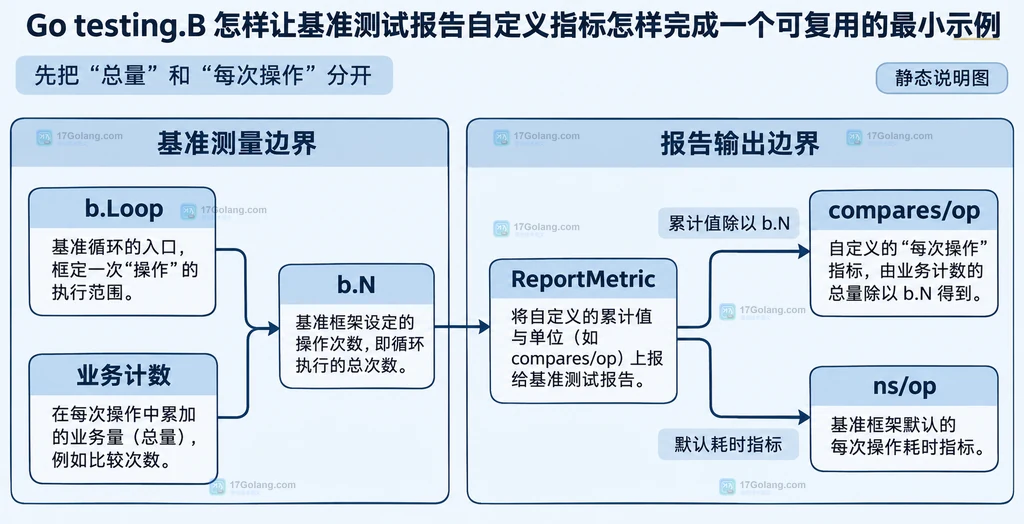
我会保留的三个检查点
- 指标是总量还是每次操作:总量先累计,
/op指标通常除以b.N。 - 计时是否包含了不该测的工作:准备数据可以放在第一次
b.Loop之前;旧式b.N循环则按需要调用ResetTimer。 - 并行数据是否安全:共享计数使用原子操作,
RunParallel返回后再读取并上报。
如果只需要吞吐量,b.SetBytes 会让框架补充 MB/s;如果需要业务维度,就用 ReportMetric。两者可以并存,关键是让单位和分母能让读者一眼看懂。
相关问题
ReportMetric 能修改默认的 ns/op 吗?可以。对同名单位上报会覆盖旧值;把 ns/op 设为 0 还能抑制该内置指标,但一般不建议隐藏默认耗时。
为什么自定义指标显示不稳定?先确认分母是否正确,再确认并行计数没有数据竞争,并避免把准备阶段或清理阶段混入计时。
旧项目必须改成 b.Loop 吗?不必为了本题强行改造。旧式 b.N 循环仍可调用 ReportMetric,但新写的基准优先考虑 b.Loop,以减少重复执行准备和清理逻辑的误解。
 Go testing.F怎样为模糊测试添加稳定种子怎样在批处理代码中减少额外分配
- 上一篇
- Go testing.F怎样为模糊测试添加稳定种子怎样在批处理代码中减少额外分配
- 下一篇
- Go testing.B怎样让基准测试报告自定义指标为什么结果为空或不符合预期
-
- Golang · Go教程 | 11分钟前 |
- Go testing.B怎样让基准测试报告自定义指标为什么结果为空或不符合预期
- 194浏览 收藏
-
- Golang · Go教程 | 17分钟前 |
- Go testing.F怎样为模糊测试添加稳定种子怎样在批处理代码中减少额外分配
- 176浏览 收藏
-
- Golang · Go教程 | 20分钟前 |
- Go testing.F怎样为模糊测试添加稳定种子为什么结果为空或不符合预期
- 501浏览 收藏
-
- Golang · Go教程 | 22分钟前 |
- Go testing.F怎样为模糊测试添加稳定种子怎样完成一个可复用的最小示例
- 344浏览 收藏
-
- Golang · Go教程 | 25分钟前 |
- Go os.DirFS怎样把目录封装成受限文件系统怎样在批处理代码中减少额外分配
- 413浏览 收藏
-
- Golang · Go教程 | 28分钟前 | go · 文件系统 ·
- Go os.DirFS怎样把目录封装成受限文件系统为什么结果为空或不符合预期
- 154浏览 收藏
-
- Golang · Go教程 | 29分钟前 |
- Go os.DirFS怎样把目录封装成受限文件系统怎样完成一个可复用的最小示例
- 131浏览 收藏
-
- Golang · Go教程 | 35分钟前 |
- Go os.Pipe怎样把一个进程的输出接到另一个进程怎样在批处理代码中减少额外分配
- 419浏览 收藏
-
- Golang · Go教程 | 37分钟前 |
- Go os.Pipe怎样把一个进程的输出接到另一个进程为什么结果为空或不符合预期
- 244浏览 收藏
-
- Golang · Go教程 | 40分钟前 |
- Go os.Pipe怎样把一个进程的输出接到另一个进程怎样完成一个可复用的最小示例
- 391浏览 收藏
-
- Golang · Go教程 | 44分钟前 |
- Go io.MultiWriter怎样把一次写入分发到多个目标怎样在批处理代码中减少额外分配
- 168浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 958次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 962次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1074次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1049次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 883次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览


