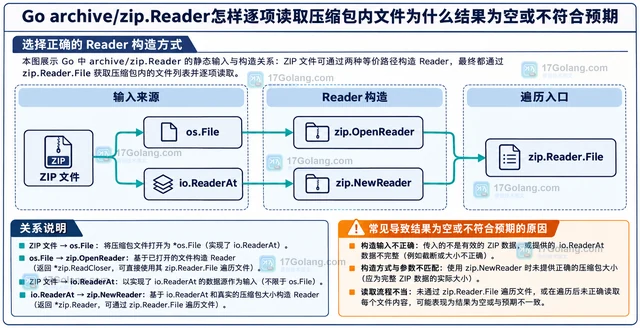
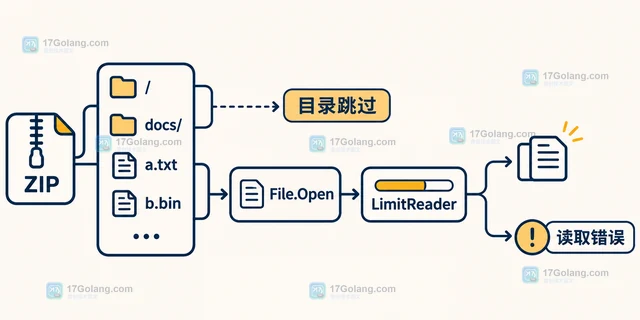
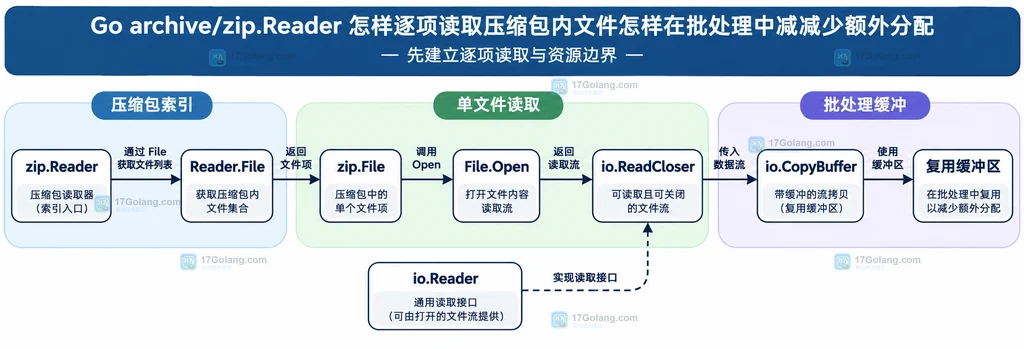
批量读取 ZIP 时,真正容易放大开销的不是 for range 本身,而是每个条目都把完整内容读成新的 []byte,再为复制过程重复创建相同大小的临时缓冲区。更稳妥的做法是:遍历 zip.Reader.File,对每个普通文件调用 File.Open(),把返回的读取器交给处理函数,并在循环外复用一个固定缓冲区。
本文只讨论 Go 标准库 archive/zip.Reader 的逐项读取和批处理分配边界。官方资料:https://pkg.go.dev/archive/zip。
如果处理逻辑可以消费io.Reader,不要先调用io.ReadAll保存每个条目的完整副本;让压缩数据在单个条目范围内流过处理器,并把可复用的[]byte放到循环外,通常就能消除最明显的重复缓冲分配。
先分清 Reader、File 和 Open 的职责
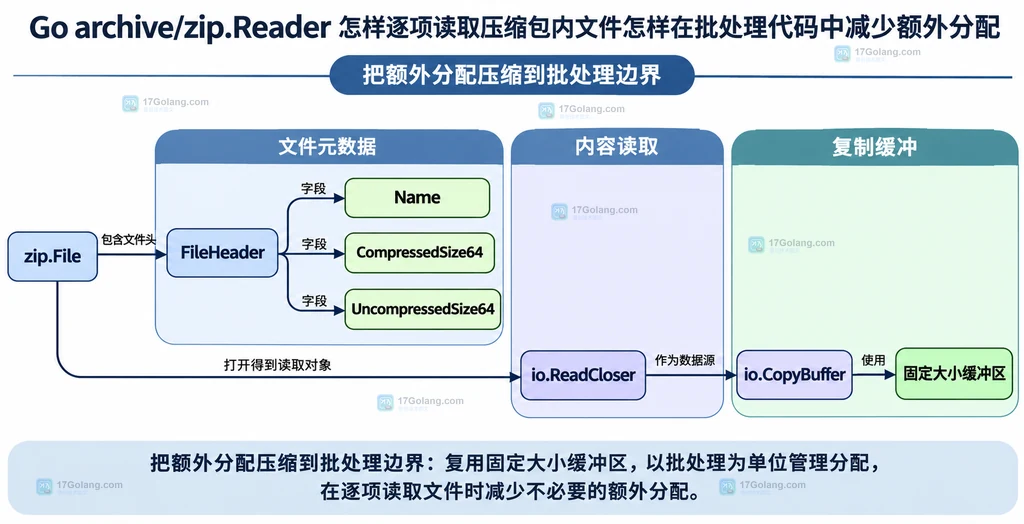
zip.Reader 负责提供 ZIP 归档的目录信息,Reader.File 是归档内条目的集合;集合中的每个 *zip.File 携带名称、压缩方式和尺寸等元数据。真正读取某个条目的内容时,才调用 File.Open() 获取 io.ReadCloser。
这几个对象的边界决定了内存策略:遍历条目只是在访问索引,不能因此推断内容已经全部解压到内存;Open() 返回的读取器才代表当前条目的内容通道。读取完成后要关闭它,让条目级资源尽快释放。
用流式处理替代每项 io.ReadAll
下面的示例把每个普通文件交给一个计数处理器。计数器只是演示“消费读取器”的位置,实际项目可以替换成校验、解析、入库或对象存储写入。示例没有把条目内容拼成完整字节切片,因此单个条目的峰值内容内存不会随文件大小线性增长。
package main

import (
	"archive/zip"
	"fmt"
	"io"
	"log"
)

// byteCounter 只消费数据并统计字节数,不保存整个条目内容。
type byteCounter struct {
	total int64
}

// Write 让 byteCounter 可以作为 io.Writer 交给 io.CopyBuffer。
func (c *byteCounter) Write(p []byte) (int, error) {
	c.total += int64(len(p))
	return len(p), nil
}

func readZipEntries(path string) error {
	archive, err := zip.OpenReader(path)
	if err != nil {
		return fmt.Errorf("打开 ZIP 失败: %w", err)
	}
	defer func() {
		// ReadCloser 由 OpenReader 返回,整个归档处理完再关闭。
		if closeErr := archive.Close(); closeErr != nil {
			log.Printf("关闭 ZIP 失败: %v", closeErr)
		}
	}()

	// 缓冲区放在循环外,所有条目共享这块工作内存。
	buf := make([]byte, 32*1024)
	for _, entry := range archive.File {
		// ZIP 目录项没有文件内容,跳过可避免无意义的 Open。
		if entry.FileInfo().IsDir() {
			continue
		}

		reader, err := entry.Open()
		if err != nil {
			return fmt.Errorf("打开条目 %q 失败: %w", entry.Name, err)
		}

		counter := byteCounter{}
		_, copyErr := io.CopyBuffer(&counter, reader, buf)
		closeErr := reader.Close()
		if copyErr != nil {
			return fmt.Errorf("读取条目 %q 失败: %w", entry.Name, copyErr)
		}
		if closeErr != nil {
			return fmt.Errorf("关闭条目 %q 失败: %w", entry.Name, closeErr)
		}

		log.Printf("%s: %d bytes", entry.Name, counter.total)
	}
	return nil
}

func main() {
	if err := readZipEntries("assets.zip"); err != nil {
		log.Fatal(err)
	}
}
这里的关键不是固定使用 32 KiB,而是让缓冲区的生命周期覆盖整个批次。大小应结合条目平均大小、处理器吞吐和内存预算调整;如果处理器本身会缓存完整内容,外层复用缓冲区也不能消除那部分分配。
为什么循环外的缓冲区能减少额外分配
把 buf := make([]byte, ...) 写在循环内,会为每个条目创建一块新的工作缓冲区。即使这些缓冲区很快变成垃圾,也会增加分配次数和垃圾回收压力。把它移到循环外后,条目之间只共享这块临时空间;每个条目的解压读取器仍然独立,处理结果也必须在当前条目结束前完成。
io.CopyBuffer 适合把读取器和处理器连接起来,但它并不承诺所有情况下都会使用传入缓冲区:当源或目标实现了更专用的复制接口时,标准库可能走对应路径。因此不要用“传入了 buf”推导出固定的分配数量,应该把它理解为一个可复用的工作缓冲区边界。
哪些边界不能为了性能省略
第一,entry.Open() 返回的是 io.ReadCloser,不要在长循环里用 defer reader.Close() 让所有条目等到函数结束才关闭。当前示例显式关闭每一项,避免大量条目同时持有条目级资源。
第二,archive/zip 会处理常见的 Store 和 Deflate 方法,并在正常的 File.Open() 路径中解压和校验校验和。遇到不支持的压缩方法、格式损坏或校验和错误时,读取操作仍可能失败,不能只统计“已经打开了多少个条目”。
第三,尺寸字段优先看 UncompressedSize64 和 CompressedSize64。ZIP64 条目可能无法用 32 位字段表达完整大小,预估内存或设置业务上限时不要只读取旧的 32 位字段。
第四,归档名称要当作输入数据处理。当前 Go 文档说明,OpenReader 和 NewReader 在特定 GODEBUG 设置下会报告不安全路径;如果后续要把条目写到磁盘,还应在应用层继续限制目标目录和相对路径,不要因为读取阶段没有报错就直接拼接本地路径。
从一次性读取迁移到逐项处理
| 写法 | 主要内存特征 | 适合场景 |
|---|---|---|
io.ReadAll(entryReader) | 每个条目生成完整内容副本 | 确实需要随机访问完整字节,且有明确大小上限 |
io.CopyBuffer(processor, entryReader, buf) | 复用批次缓冲区,内容按块交给处理器 | 解析、哈希、上传或写入下游流 |
直接使用 FileHeader | 只访问条目元数据,不读取正文 | 筛选名称、大小、压缩方式和目录项 |
迁移时可以先把处理函数的参数从 []byte 改成 io.Reader,再把读取和关闭责任收拢到遍历循环。只有确实需要多次读取同一条目时,才在更靠近业务边界的位置保存副本。
最小检查清单
- 是否遍历
Reader.File,并在读取前跳过目录项? - 是否对每个
entry.Open()的返回值检查错误并及时Close? - 是否避免了对每个条目调用
io.ReadAll,除非业务确实需要完整字节? - 是否把可复用的复制缓冲区放在循环外,并根据处理器行为设置大小?
- 是否使用 64 位尺寸字段,并对不安全路径、坏压缩和校验和错误保留错误处理?
常见相关问题
逐项读取会不会让压缩包索引也重复分配?
遍历已经建立的 Reader.File 只是访问条目索引;主要新增的对象来自当前条目的打开和处理路径。是否产生更多分配,仍取决于解压器、目标处理器和你的业务代码。
可以把一个 reader 交给多个 goroutine 吗?
不要共享同一个条目的读取器。若需要并行处理,应为不同条目分别调用 Open,为每个并发任务准备独立的处理状态和缓冲区,避免共享可变状态。
什么时候应该保留完整的 []byte?
当下游 API 只接受字节切片、需要重复解析同一内容,或者条目经过明确大小限制且确实适合驻留内存时,可以保留副本;否则优先让处理逻辑接受 io.Reader。
 手机壁纸提示词:怎样让底部细节与图标区域保持层次与锁屏文字留白