
Go问答:runtime/metrics读取运行时指标时为什么没有样本为什么结果为空或不符合预期
用 runtime/metrics 读取运行时指标时,结果为空不一定是 Go 运行时没有数据。最常见的原因是传入了空的 []metrics.Sample、指标名少了单位、指标在当前实现中不存在,或者把直方图的零样本误当成读取失败。
官方地址:https://pkg.go.dev/runtime/metrics
Read只会填充你传入的 Sample,空切片调用本身不会产生结果。- 未知名称的
Value.Kind()是metrics.KindBad,不能直接调用数值读取方法。 - 直方图的
Counts总和为零,代表当前没有样本,不等同于 API 失败。
Go runtime/metrics 没有样本通常先看 Sample 切片和指标名
metrics.Read 没有“返回样本列表”这一步,它只修改调用方提供的 Sample。下面这段代码把一个完整的指标名称放进切片,再读取它的类型和值:
package main

import (
	"fmt"
	"runtime/metrics"
)

func main() {
	// 指标名必须包含路径和单位,不能只写“heap/free”。
	samples := []metrics.Sample{{Name: "/memory/classes/heap/free:bytes"}}
	// Read 会把结果写回 samples[0].Value。
	metrics.Read(samples)

	// 先判断 Kind,再调用对应的取值方法,避免类型不匹配导致 panic。
	switch samples[0].Value.Kind() {
	case metrics.KindUint64:
		fmt.Printf("free=%d bytes\n", samples[0].Value.Uint64())
	case metrics.KindBad:
		fmt.Println("metric is not supported")
	default:
		fmt.Printf("unexpected kind=%v\n", samples[0].Value.Kind())
	}
}
如果写成 make([]metrics.Sample, 0),再调用 Read,函数会直接返回;如果只写了路径而遗漏 :bytes,名称也不会匹配当前的指标描述。排查时先打印 Sample 的 Name 和 Kind,不要先猜数值是不是零。
用 All 和 KindBad 区分空读、错名与不支持
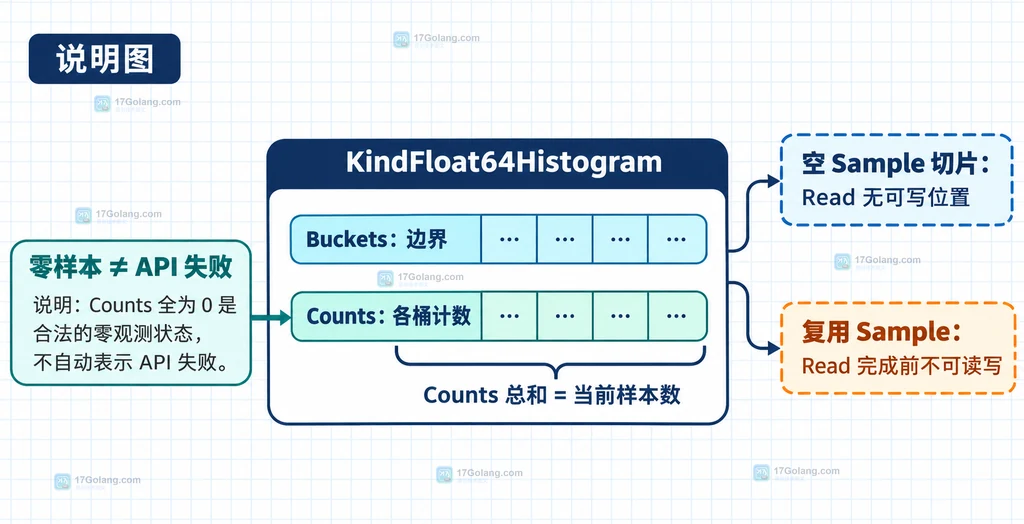
官方建议通过 metrics.All() 获取当前实现支持的名称。运行时指标集合会随实现演进,硬编码关键指标时尤其要保留降级分支。
func readMetric(name string) (metrics.Value, bool) {
	// 用 All 建立支持集合,避免把拼写错误当成“没有样本”。
	supported := make(map[string]struct{}, len(metrics.All()))
	for _, desc := range metrics.All() {
		supported[desc.Name] = struct{}{}
	}
	if _, ok := supported[name]; !ok {
		return metrics.Value{}, false
	}

	// 一个 Sample 对应一个明确的指标名称。
	sample := []metrics.Sample{{Name: name}}
	metrics.Read(sample)
	if sample[0].Value.Kind() == metrics.KindBad {
		// 运行时实现变化时走降级路径,而不是调用错误的取值方法。
		return metrics.Value{}, false
	}
	return sample[0].Value, true
}
这里的两次判断各有作用:All 适合在启动时查看当前可用集合,KindBad 是对单次读取结果的最后保护。真正使用时还要记录指标类型,不能只凭名称决定调用 Uint64 还是 Float64。
| 现象 | 优先检查 | 正确处理 |
|---|---|---|
| 没有任何结果 | Sample 长度是否为 0 | 创建包含目标名称的切片 |
| KindBad | 名称是否完整、当前实现是否支持 | 降级或跳过,不调用取值方法 |
| 读到 0 | 指标语义是否允许为 0 | 结合单位和累计属性解释 |
| 直方图 Counts 全为 0 | 当前观察窗口是否真的没有事件 | 保留零样本状态,不当作接口错误 |
数值、直方图和复用切片要分别处理
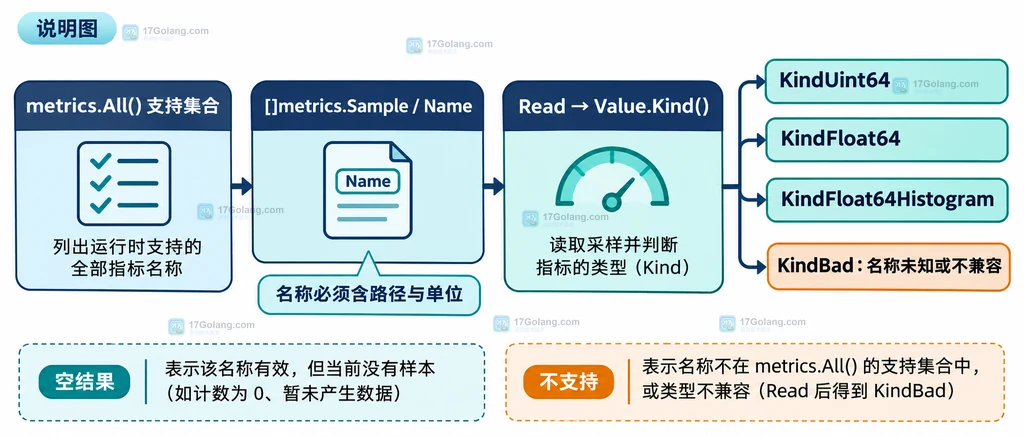
标量指标可以直接读取对应的 Uint64 或 Float64。直方图返回的是 *metrics.Float64Histogram:Buckets 是边界,Counts 是各桶计数,二者长度相差一。判断“有没有样本”应累加 Counts,而不是只检查指针是否为空。
func histogramSamples(v metrics.Value) uint64 {
	// 只有确认是直方图后才能取出其内部结构。
	if v.Kind() != metrics.KindFloat64Histogram {
		return 0
	}
	h := v.Float64Histogram()
	var total uint64
	for _, count := range h.Counts {
		// Counts 的总和表示当前直方图记录的样本数。
		total += count
	}
	return total
}
另外,复用同一组 Sample 可以减少分配,但不能在一次 Read 尚未完成时并发读取或修改其中的 Value;并发调用要使用不共享底层数组的切片。监控采集器通常按固定周期串行复用一组 Sample,就能同时获得稳定语义和较低开销。
部署前的兼容性检查清单
- 指标名是否来自
metrics.All(),并保留冒号后的单位。 - 是否在取值前检查
Value.Kind(),对KindBad有降级策略。 - 是否区分“没有读取对象”和“读取值为零”。
- 直方图是否按
Counts总和判断样本量,并保留桶边界。 - 周期采集是否避免跨 goroutine 共享同一组 Sample。
把这五项放进采集器的启动日志和单元测试后,runtime/metrics 的空结果就能从“神秘异常”变成可分类的兼容性状态。
常见问题
为什么调用 metrics.Read 后 Value 还是默认状态?
先确认切片长度大于零且每个 Sample 已设置 Name。空切片没有可写入的位置,Read 会直接返回。
KindBad 是否表示 Go 运行时坏了?
通常不是。它表示该名称没有出现在当前实现支持的指标集合中,常见原因是拼写、单位缺失或跨实现差异。
直方图 Counts 为零需要重试吗?
不需要立即重试。它可能准确表示采样期间没有对应事件;只有名称未知或 Kind 不符合预期时,才应回到指标选择和兼容性检查。
 Go问答:os.File.Sync写入成功后为什么重启仍可能丢数据为什么结果为空或不符合预期
- 上一篇
- Go问答:os.File.Sync写入成功后为什么重启仍可能丢数据为什么结果为空或不符合预期
- 下一篇
- MySQL 分区表怎样确认查询是否命中了分区裁剪怎样在批处理代码中减少额外分配
-
- Golang · Go问答 | 4小时前 |
- Go adler32.Sum 为什么会保留传入切片的前缀
- 199浏览 收藏
-
- Golang · Go问答 | 5小时前 |
- Go问答:httptrace 如何定位 HTTP 连接未复用:ClientTrace 回调与 Transport 生命周期
- 139浏览 收藏
-
- Golang · Go问答 | 17小时前 | go · Go macho.OpenFat ErrNotFat Mach-O
- Go macho.OpenFat 返回 ErrNotFat 为什么不代表文件已经损坏
- 377浏览 收藏
-
- Golang · Go问答 | 18小时前 | 错误处理 · net/http · Go问答 · Go 反向代理 httputil.ReverseProxy ErrorHandler 上游错误
- Go httputil.ReverseProxy ErrorHandler 怎样接管上游失败响应
- 125浏览 收藏
-
- Golang · Go问答 | 1天前 |
- Go rsa.PrivateKey.Validate 怎样定位私钥参数不一致
- 285浏览 收藏
-
- Golang · Go问答 | 1天前 |
- Go http.Server.BaseContext 返回 nil 会有什么后果
- 322浏览 收藏
-
- Golang · Go问答 | 1天前 |
- Go context.WithTimeout 子协程为什么没有随超时退出怎样构造最小复现
- 159浏览 收藏
-
- Golang · Go问答 | 1天前 |
- Go ast.IsGenerated 为什么识别不到生成文件注释
- 457浏览 收藏
-
- Golang · Go问答 | 1天前 |
- Go time.Timer Stop 后为什么还会收到事件怎样构造最小复现
- 471浏览 收藏
-
- Golang · Go问答 | 1天前 |
- Go bytes.Buffer Grow 后为什么 Len 还是零
- 110浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 952次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 959次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1071次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1040次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 876次使用
-
- 用Nginx反向代理部署go写的网站。
- 2023-01-17 502浏览
-
- GoLand调式动态执行代码
- 2023-01-13 502浏览
-
- Go flag.FlagSet ContinueOnError 怎么捕获帮助输出和解析错误
- 2026-11-05 501浏览
-
- Go netip.ParseAddr 为什么拒绝带端口字符串
- 2026-11-03 501浏览
-
- Go generate 未执行指令的注释与目录检查
- 2026-10-28 501浏览


