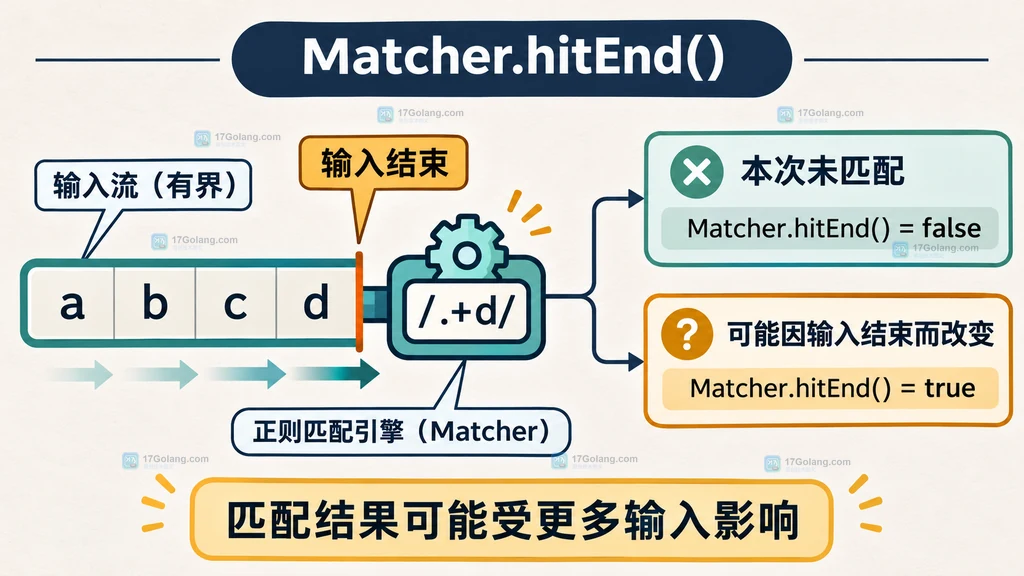
解析分块到达的日志、协议帧或用户输入时,正则匹配失败不一定代表格式错误:输入可能只是刚好在需要后续字符的位置结束。Java 的 Matcher.hitEnd() 可以告诉我们,最近一次匹配操作是否已经碰到了输入末尾。
官方地址:https://docs.oracle.com/en/java/javase/25/docs/api/java.base/java/util/regex/Matcher.html#hitEnd()
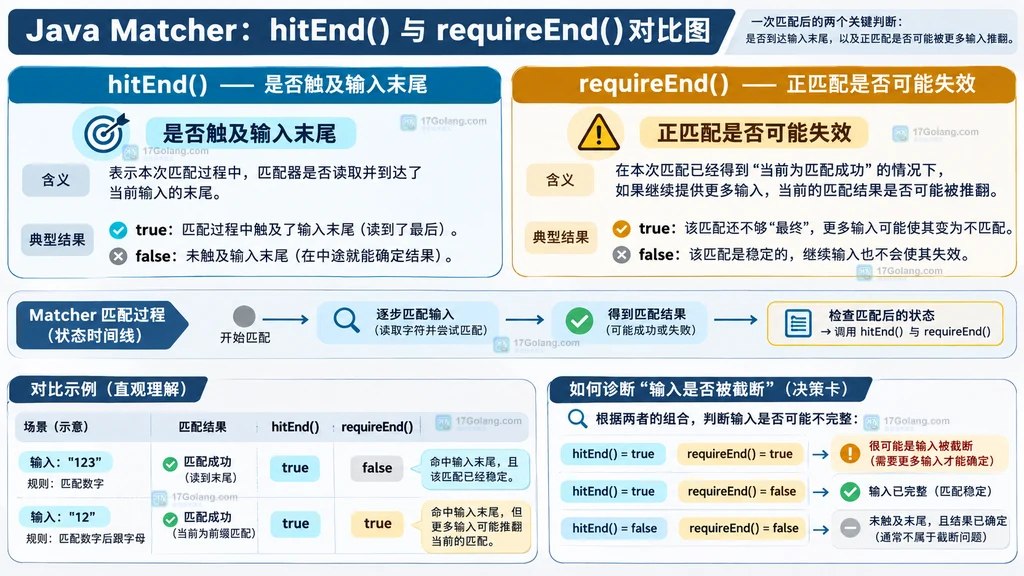
hitEnd()为true时,说明搜索引擎触及了当前输入的末尾,更多输入有可能改变最近一次搜索结果;它不是“已经确认截断”的证明。正确判断还要结合匹配返回值、正则边界和数据是否仍会继续到达。
先把 hitEnd 放在最后一次匹配操作之后读取
hitEnd() 观察的是同一个 Matcher 最近一次 find()、lookingAt() 或 matches() 操作,因此应该紧跟匹配调用读取。
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class HitEndIntro {
    public static void main(String[] args) {
        Pattern pattern = Pattern.compile("\\\\d{4}");
        Matcher matcher = pattern.matcher("202");

        // 只有三位数字,四位数字模式无法完成匹配。
        boolean matched = matcher.find();
        // 必须在同一次 find() 后读取,避免被下一次操作覆盖。
        boolean touchedEnd = matcher.hitEnd();

        System.out.println("matched=" + matched);
        System.out.println("hitEnd=" + touchedEnd);
    }
}
这个输入在搜索时到达末尾,matched 为 false,而 hitEnd 可能为 true。它只表示补充字符有机会改变结果,不表示补充后一定会匹配。
用失败结果与输入末尾判断是否可能还没收全
排查“输入被截断”时,先把结果拆成匹配是否成功、搜索是否触及末尾两个维度:
| 匹配结果 | hitEnd | 解释 |
|---|---|---|
| false | false | 当前输入中没有匹配,补充末尾字符通常不能解释这次失败 |
| false | true | 搜索碰到末尾,可能还缺少后续字符,应等待或拼接下一块 |
| true | false | 匹配完成,搜索没有触及输入末尾 |
| true | true | 匹配触及末尾,还要结合 requireEnd 判断稳定性 |
例如,模式 \\d{4} 对 202 搜索失败并触及末尾,和对 202x 搜索失败,是两种不同的排障方向。前者可以暂存片段,后者更像内容本身不符合模式。
用 requireEnd 补充成功匹配的稳定性判断
匹配成功后,hitEnd() 只说明搜索到过输入末尾;requireEnd() 则回答:继续追加输入时,这个成功结果是否可能变成失败。Oracle API 文档明确区分了两个语义。
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class MatchStability {
    public static void main(String[] args) {
        Pattern pattern = Pattern.compile("cat$");
        Matcher matcher = pattern.matcher("cat");

        // $ 依赖输入末尾,追加字符后当前成功结果可能失效。
        boolean matched = matcher.find();
        // 两个状态都必须在同一次 find() 后读取。
        boolean touchedEnd = matcher.hitEnd();
        boolean mayLoseMatch = matcher.requireEnd();

        System.out.println("matched=" + matched);
        System.out.println("hitEnd=" + touchedEnd);
        System.out.println("requireEnd=" + mayLoseMatch);
    }
}
如果业务协议已经明确一条消息结束,可以接受当前结果;如果数据仍在流入,则应等帧边界明确后再提交业务处理。
处理 find、region 和 matcher 状态边界
hitEnd() 的范围是最近一次匹配操作使用的输入区域。默认区域是整个输入;调用 region(start, end) 后,区域末端也会成为搜索边界。
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class RegionBoundary {
    public static void main(String[] args) {
        Pattern pattern = Pattern.compile("item-[A-Z]+");
        Matcher matcher = pattern.matcher("prefix item-");

        // 只在指定区域内搜索,区域末端会影响边界判断。
        matcher.region(7, matcher.regionEnd());
        boolean matched = matcher.find();
        // 读取前不要再次 reset 或执行新的匹配操作。
        boolean touchedEnd = matcher.hitEnd();

        System.out.println("matched=" + matched);
        System.out.println("hitEnd=" + touchedEnd);
    }
}
hitEnd()不会告诉你缺少几个字符,也不会验证协议长度。reset()、reset(CharSequence)或改变区域后,旧诊断结论不应继续复用。- 读取状态前不要先调用下一次
find(),否则解释对象已经改变。
把诊断结论接到流式输入策略
流式解析器可以把正则层结果整理为完成、等待更多输入、当前输入无效三种状态,但仍需由协议长度、校验和与超时规则兜底。
enum ParseDecision { COMPLETE, WAIT_MORE, INVALID }

static ParseDecision decide(Matcher matcher, boolean matched) {
    // 失败且触及末尾,优先保留片段并等待下一块输入。
    if (!matched && matcher.hitEnd()) return ParseDecision.WAIT_MORE;
    // 成功但可能被更多输入推翻,等协议边界后再提交。
    if (matched && matcher.requireEnd()) return ParseDecision.WAIT_MORE;
    // 其余成功结果交给上层,失败结果视为当前输入无效。
    return matched ? ParseDecision.COMPLETE : ParseDecision.INVALID;
}
WAIT_MORE 分支应设置最大缓冲长度和超时,避免异常上游持续发送“还差一点”的片段造成内存无界增长。
常见误区与速查
- 把
hitEnd() == true当成确定截断:它只是提示更多输入可能改变搜索结果。 - 把
requireEnd()用在失败匹配上:它针对成功匹配是否可能被更多输入推翻。 - 忽略
region():区域末端和完整输入末端不一定相同。
可以记成一句话:失败后看 hitEnd(),成功后再看 requireEnd();是否继续等待,还要由协议边界、缓冲上限和超时共同决定。
相关问题
hitEnd() 返回 true 是否一定说明少了字符?
不是。它只说明搜索到达输入末尾,补充输入有可能改变结果;模式本来允许在末尾结束时,业务上不一定缺数据。
requireEnd() 和 hitEnd() 可以只保留一个吗?
不能简单替代。前者解释成功匹配是否依赖结束位置,后者也能帮助解释失败搜索是否碰到了输入末尾。
读取状态前可以调用 reset() 吗?
不建议。reset 会重置匹配状态,应先保存本次匹配结果与边界判断,再决定是否用新输入重置 matcher。
 Java Package.getImplementationVendor 怎样读取包实现供应商