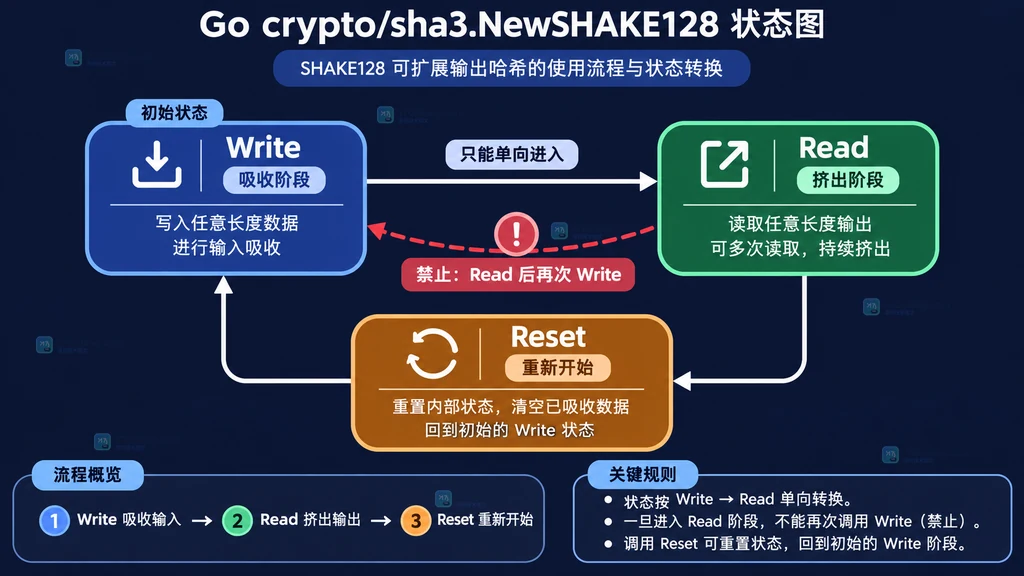
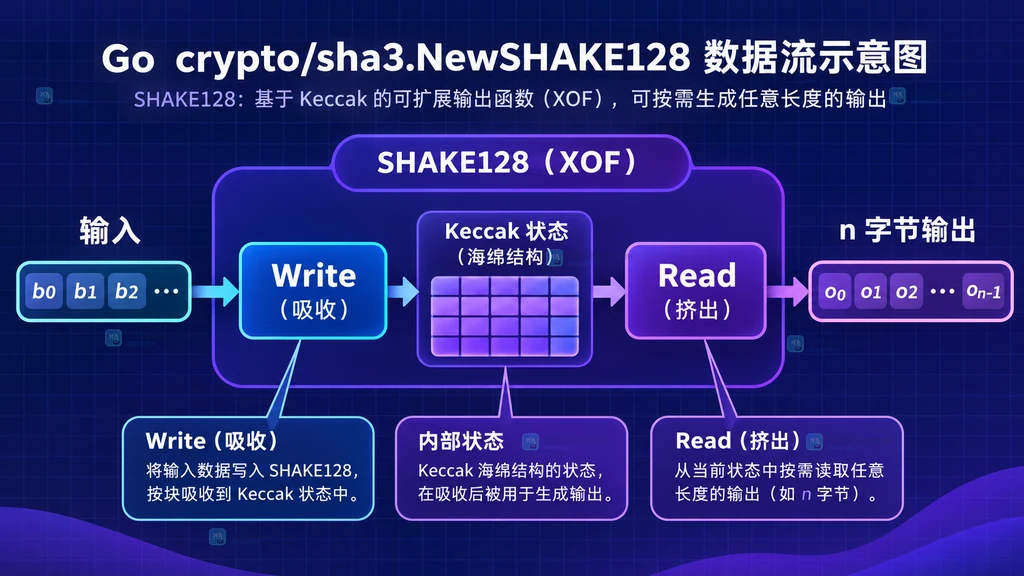
如果输出长度不是固定的 32 或 64 字节,而是由调用方按场景决定,Go 的 crypto/sha3.NewSHAKE128 更适合这个任务。它先通过 Write 吸收输入,再用 Read 按缓冲区长度挤出输出;输出长度由你传入的字节切片决定。
官方地址:https://pkg.go.dev/crypto/sha3
最容易踩到的边界是:一旦调用过 Read,这个 SHAKE 状态就进入输出阶段,后续再调用 Write 会触发 panic。需要计算下一段独立输入时,应调用 Reset 或重新创建实例。
先区分 NewSHAKE128 和 SumSHAKE128
只计算一次、已经知道输入和输出长度时,可以直接使用 sha3.SumSHAKE128(data, length)。需要流式写入、分段读取,或希望把输出长度交给调用方决定时,使用 NewSHAKE128。
| 需求 | 建议入口 | 特点 |
|---|---|---|
| 一次性输入,一次性返回 | SumSHAKE128 | 参数直接表达输入和长度 |
| 分块写入后再读取 | NewSHAKE128 | 符合 Write → Read 顺序 |
| 同一输入连续拿更多输出 | NewSHAKE128 + 多次 Read | 后一次从上一次输出位置继续 |
创建实例并读取指定长度
把输出长度放进目标切片,调用 io.ReadFull 可以明确表达“必须填满这块缓冲区”。当前标准库实现的 SHAKE Read 会持续产生输出,因此这里主要检查读取到的字节数和错误。
package main

import (
    "fmt"
    "io"

    "crypto/sha3"
)

func shake128(data []byte, outputLen int) ([]byte, error) {
    // 输出长度由调用方决定,负数没有实际意义,先拒绝它。
    if outputLen < 0 {
        return nil, fmt.Errorf("output length must not be negative")
    }

    // NewSHAKE128 创建可扩展输出状态,Write 负责吸收输入。
    xof := sha3.NewSHAKE128()
    if _, err := xof.Write(data); err != nil {
        return nil, fmt.Errorf("write input: %w", err)
    }

    // Read 按切片长度产生输出;ReadFull 确保目标切片被填满。
    output := make([]byte, outputLen)
    if _, err := io.ReadFull(xof, output); err != nil {
        return nil, fmt.Errorf("read output: %w", err)
    }
    return output, nil
}

func main() {
    // 同一输入可以按业务需要请求不同长度的结果。
    digest, err := shake128([]byte("17golang"), 24)
    if err != nil {
        panic(err)
    }
    fmt.Printf("%x\n", digest)
}
这里的 24 表示 24 字节,不是 24 位。若协议要求固定长度,应该把长度写进接口约定并在边界处统一管理,避免不同调用方得到不同格式。
连续 Read 会从当前位置继续输出
SHAKE 是可扩展输出函数。第一次 Read 取出前 16 字节后,第二次 Read 取得的是后续字节,而不是重新计算一遍相同的前缀。这个特性适合把结果写入多个固定大小的块,但不适合把每一块当成独立摘要。
func readInChunks(data []byte) ([]byte, error) {
    // 先吸收完整输入,再进入只能读取的输出阶段。
    xof := sha3.NewSHAKE128()
    if _, err := xof.Write(data); err != nil {
        return nil, fmt.Errorf("write input: %w", err)
    }

    first := make([]byte, 16)
    second := make([]byte, 16)
    // 两次 Read 对应同一个连续输出流,second 不是 first 的重复。
    if _, err := io.ReadFull(xof, first); err != nil {
        return nil, fmt.Errorf("read first block: %w", err)
    }
    if _, err := io.ReadFull(xof, second); err != nil {
        return nil, fmt.Errorf("read second block: %w", err)
    }
    return append(first, second...), nil
}
如果业务需要两个相互独立的结果,应为每个结果创建独立实例,或者在开始读取前复制可用状态;不要把连续读取的两段直接当作两个独立哈希。
Read 之后不要再次 Write
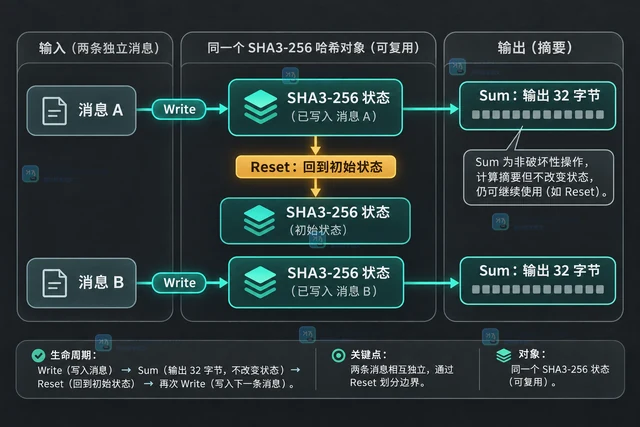
SHAKE 的生命周期可以按“吸收输入”和“挤出输出”理解:Write 属于前一阶段,Read 属于后一阶段。官方文档明确说明,调用 Read 后再调用 Write 会 panic。
func reuseOneInstance() ([]byte, error) {
    // 一个实例完成一轮输入到输出后,用 Reset 开启下一轮。
    xof := sha3.NewSHAKE128()
    if _, err := xof.Write([]byte("first")); err != nil {
        return nil, fmt.Errorf("write first input: %w", err)
    }
    first := make([]byte, 16)
    if _, err := io.ReadFull(xof, first); err != nil {
        return nil, fmt.Errorf("read first output: %w", err)
    }

    // 不能在这里直接 Write;Reset 会清除上一轮的吸收和输出状态。
    xof.Reset()
    if _, err := xof.Write([]byte("second")); err != nil {
        return nil, fmt.Errorf("write second input: %w", err)
    }
    second := make([]byte, 16)
    if _, err := io.ReadFull(xof, second); err != nil {
        return nil, fmt.Errorf("read second output: %w", err)
    }
    return second, nil
}
Reset 适合串行复用;如果多个 goroutine 要同时计算,不要共享同一个 SHAKE 实例,应让每个任务拥有自己的状态。
怎样封装才不容易误用
- 固定长度且一次性计算:优先封装
SumSHAKE128,让输入和长度同时出现在函数参数中。 - 长度由调用方传入:检查长度范围,再创建对应容量的切片。
- 需要分段读取:在函数内部完成所有
Write,之后只允许Read。 - 下一次计算复用实例:读取结束后先
Reset,不要尝试追加输入。
一个实用的判断口诀是:先写完,再读;读完要重来,就 Reset。 这比把 SHAKE 当成普通可以随时追加的 hash.Hash 更安全。
常见问题
SHAKE128 的输出长度必须固定吗?
不必。Read 的目标切片有多长,就可以请求多少字节;但协议或存储格式应自行规定长度。
为什么第二次 Read 得到的不是第一次结果?
因为连续 Read 会推进 XOF 的输出位置,第二次读取的是后续部分。需要重复前缀时,应重新创建实例并重新写入相同输入。
能否 Read 一部分后继续 Write?
不能。读取表示已经进入挤出阶段;要换输入,请调用 Reset 后重新 Write。
 Go reflect.Value.CanFloat 怎样安全读取浮点值