在写 Go 的静态分析器、格式化工具或编译器插件时,我经常需要把“第几行”转换成源码里的精确位置。最容易混淆的是:token.File.LineStart 返回的不是普通整数,而是 token.Pos;它和从文件开头数出来的字节偏移不是同一个坐标系。
先记住三个坐标
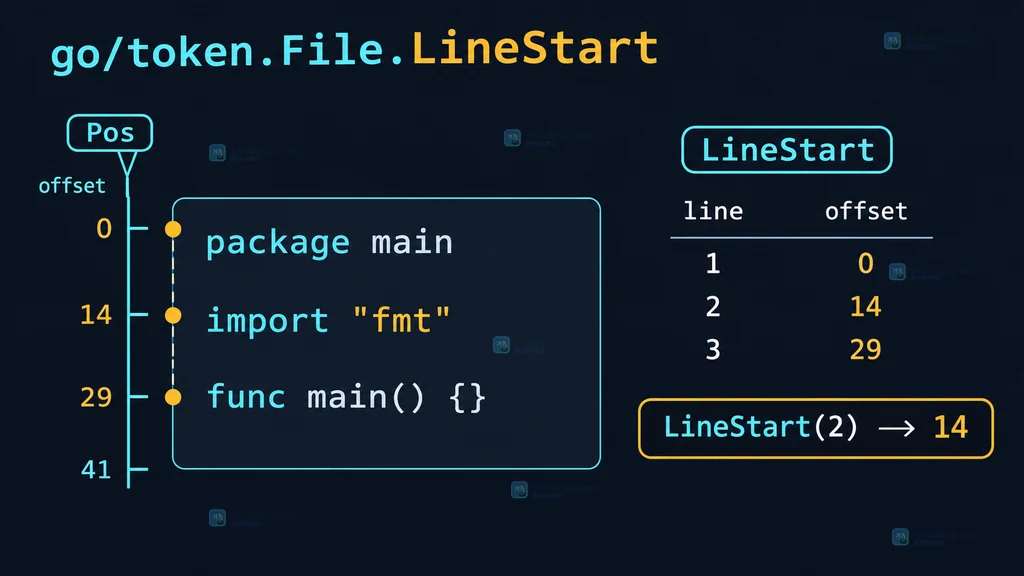
go/token 里通常会同时出现三种值:
- 行号:从 1 开始,人读起来最直观。
- token.Pos:挂在
token.FileSet上的全局位置。 - offset:从当前文件起点计算的字节偏移,从 0 开始。
LineStart(line) 的作用是把第一种坐标转换成第二种坐标;如果要拿去切片或和文件内容下标比较,再调用同一个 token.File 的 Offset(pos)。
一个可运行的最小例子
下面的例子把一段源码登记到 FileSet,再读取第二行的起始位置。这里故意使用 SetLinesForContent,让 token.File 根据真实内容建立行表。
package main

import (
	"fmt"
	"go/token"
)

func main() {
	// 行首偏移以字节计算,第二行从 offset 13 开始。
	src := []byte("package demo\nfunc main() {}\n")
	fset := token.NewFileSet()
	file := fset.AddFile("demo.go", -1, len(src))
	file.SetLinesForContent(src)

	lineStart := file.LineStart(2)
	offset := file.Offset(lineStart)
	pos := fset.Position(lineStart)

	fmt.Println(offset) // 13
	fmt.Println(pos.Line, pos.Column) // 2 1
}运行后,offset 是当前文件中的 0-based 字节位置,而 Position 负责把这个 token.Pos 显示成文件名、行和列。不要把 int(lineStart) 直接当成文件内下标,因为 FileSet 可能同时管理多个文件。
LineStart 的行号是 1-based
LineStart(1) 表示第一行的开始。传入 0,或者传入大于当前文件行数的值,都属于调用方的边界错误;应在业务层先检查行号,而不是用 recover 把它当作正常分支。
func lineOffset(file *token.File, line int) (int, bool) {
	// 先检查行号,避免无效行号触发 panic。
	if line < 1 || line > file.LineCount() {
		return 0, false
	}
	return file.Offset(file.LineStart(line)), true
}
这个小封装返回的是当前文件内的字节偏移。如果调用方后面要构造诊断位置,可以保留 LineStart 返回的 token.Pos,交给 FileSet.Position 统一格式化。
LineStart、Offset、Pos 怎样配合
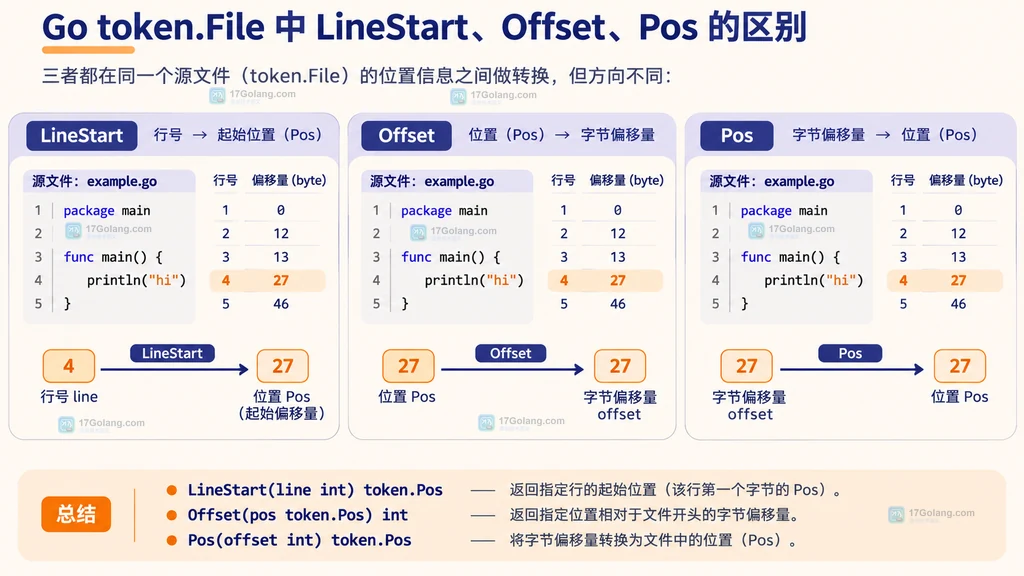
可以把三个方法记成一条闭环:
line  --LineStart-->  token.Pos  --Offset-->  file offset
offset --Pos--------> token.Pos  --FileSet.Position--> 文件名/行/列
file.Pos(offset) 要求 offset 属于当前文件范围;file.Offset(pos) 则把属于当前文件的 token.Pos 还原成文件内偏移。跨文件使用另一个 File 去转换,会让结果失去意义。
换行符和 UTF-8 是两个常见坑
偏移是字节,不是 Unicode 字符数。中文、表情或其他多字节 UTF-8 字符会让“看起来的第几个字符”和 offset 不一致。另一方面,Windows 文本中的 \r\n 也会占两个字节;如果源码是从磁盘读入的,应让 SetLinesForContent 处理原始内容,不要先用字符数自行推算行首。
如果你要把偏移用于 Go 字符串切片,仍然要确保它落在字节边界上;LineStart 给出的行首天然位于边界,但从行首继续计算列位置时不能把列号直接当作字节数。
排查清单
- 确认行号从 1 开始,而不是从 0 开始。
- 确认
File的大小与登记的源码字节数一致。 - 确认已经调用
SetLinesForContent,或用AddLine正确建立了行表。 - 需要文件内下标时使用
Offset,不要直接强转token.Pos。 - 需要对外展示时使用
FileSet.Position,不要把全局位置当成列号。
结论
这次我会把 LineStart 记成“行号到位置”的入口:先用它得到当前行的 token.Pos,再根据场景选择 Offset 或 FileSet.Position。只要把 1-based 行号、全局 token.Pos 和文件内字节 offset 分开,源码诊断中的大多数行首偏移问题就不会再靠猜。
参考:go/token.File.LineStart、go/token.File.Offset、go/token.File.Pos。
 Go image/color.RGBA 为什么读取到的 RGB 已经乘过 Alpha