
解释 interleaved 模式下并发语句预分配自增值和编号间隔的关系
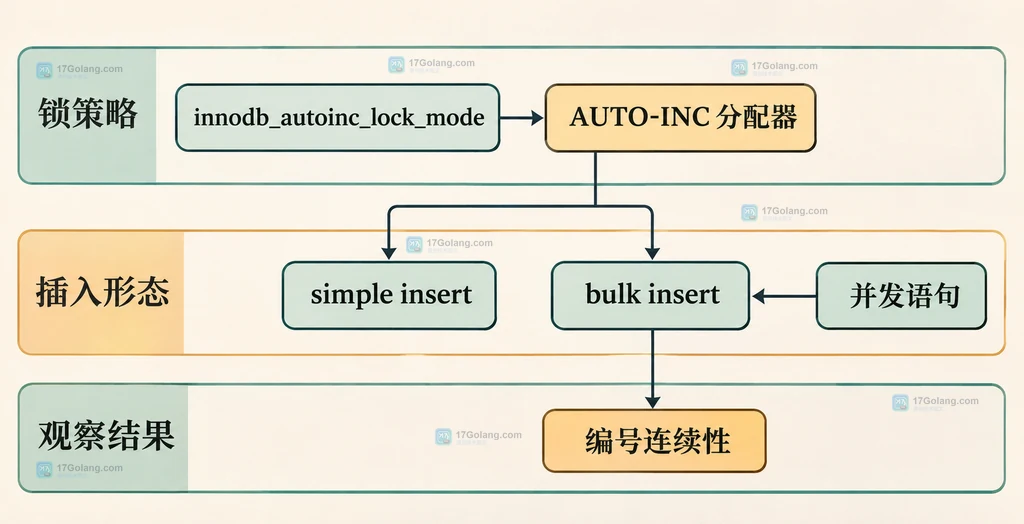
先给结论:innodb_autoinc_lock_mode=2(interleaved)允许多个 INSERT-like 语句同时申请自增值,所以编号在不同语句之间交错并不奇怪。它保证的是编号唯一且总体单调递增,不保证每一条并发语句拿到的编号连续;当语句是 bulk insert 时,还可能因为预估和并发分配留下间隔。
这里的“间隔”是自增列的存储结果,不等于数据丢失,也不适合拿来生成严格连续的业务单号。理解这一点后,再看锁模式、插入类型和事务结果,排查就不会混在一起。
先区分唯一、递增和连续
三个词描述的是不同保证:
- 唯一:不同并发语句不会拿到同一个自动生成值。
- 单调递增:后分配的值不会小于先分配的值;这不代表查询结果按插入完成顺序排列。
- 连续:某个语句或整张表的可见编号没有缺口,这是更强的要求。
interleaved 模式主要优化的是并发度。它不再让每个 INSERT-like 语句串行持有表级 AUTO-INC 锁,而是让多个语句同时参与编号分配。因此,“主键没有 100、103”不能直接推出“这一行插入失败”。
三种锁模式到底差在哪里
配置项是启动时的 innodb_autoinc_lock_mode,常见取值为 0、1、2:
| 模式 | 核心行为 | 更适合的判断 |
|---|---|---|
| 0 traditional | 所有 INSERT-like 语句使用表级 AUTO-INC 锁,语句内编号保持连续 | 兼容旧语义、需要 statement-based replication 时优先考虑 |
| 1 consecutive | bulk insert 使用表级锁,已知行数的 simple insert 只在分配阶段取轻量互斥 | 希望兼顾并发和 statement-based replication |
| 2 interleaved | INSERT-like 语句不使用表级 AUTO-INC 锁,允许编号跨语句交错 | 使用 row-based 或 mixed replication、优先并发吞吐时 |
注意:模式 2 是“允许并发分配”,不是“强制每条语句都产生间隔”。如果只有已知行数的 simple insert,单个语句通常仍不会出现间隔;bulk insert 的行数事先不完全确定时,风险才明显。
为什么 bulk insert 会出现预分配间隔
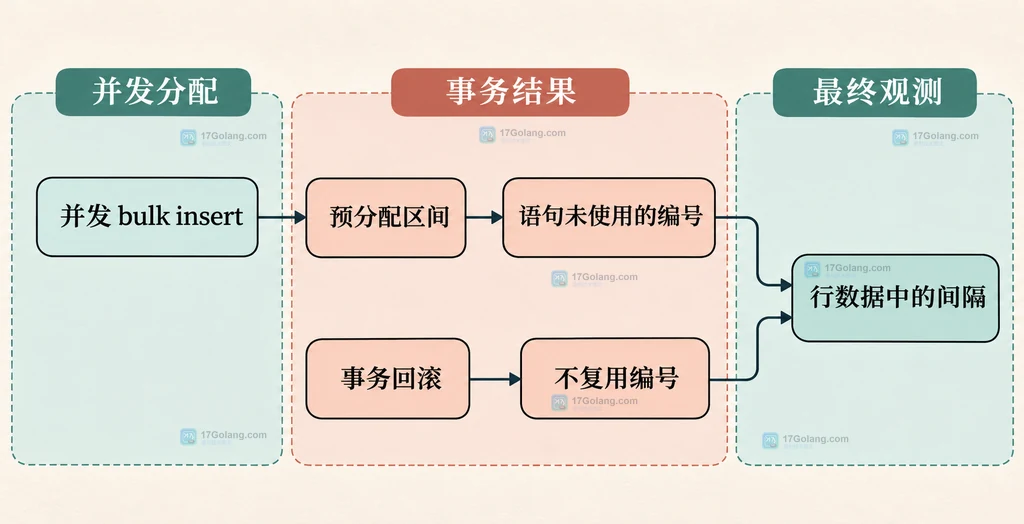
以 INSERT ... SELECT 或 LOAD DATA 为例,InnoDB 在语句开始时可能不知道最终要插入多少行。并发模式下,分配器会在多个语句之间交错提供编号;当某个 bulk insert 先拿到一段估计区间、实际只使用其中一部分时,未使用的编号就不会回收给下一条语句。
可以用一个抽象场景理解,而不要把下面的数字当作固定复现结果:
-- 建立一个用于观察自增列的示例表;业务字段不参与编号分配
CREATE TABLE orders_demo (
    id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT PRIMARY KEY,
    source_name VARCHAR(32) NOT NULL
) ENGINE = InnoDB;

-- bulk insert 的行数来自查询,分配器在处理过程中可能无法预先知道最终行数
INSERT INTO orders_demo (source_name)
SELECT source_name FROM import_stage;

-- 查看实际落盘的编号;结果重点看 id 是否有间隔,不要假设按提交顺序排列
SELECT id, source_name
FROM orders_demo
ORDER BY id;
如果另一条 INSERT-like 语句在第一条处理期间也申请编号,它拿到的值可能落在前一条语句最终写入的编号之间。于是你会看到“单条语句生成的行并不连续”,但所有已经分配的值仍然保持唯一和递增。
编号间隔要拆成三种原因
排查时建议分别问三个问题:
- 是否有并发 bulk insert? 如果有,interleaved 模式下跨语句交错和预分配间隔是正常可能性。
- 是否是 mixed-mode insert? 同一条多行 INSERT 同时显式提供部分自增值时,自动分配的数量可能超过实际使用数量。
- 是否发生过回滚? 只要自增值已经分配,即使语句或事务后来失败并回滚,这些编号也不会被复用。
第三种原因并非 interleaved 独有。传统模式和 consecutive 模式同样会因为回滚产生丢失的自增值;删除数据也会让查询结果看起来不连续,但那属于数据生命周期问题,不是分配器预留问题。
复制模式决定能不能直接用 2
如果使用 statement-based replication,副本需要按语句重放并得到可预测的自增值;这时应在源库和副本使用 0 或 1,并保持配置一致。interleaved 允许并发语句交错,按语句重放时可能得到不同分配顺序,因此不适合这种复制方式。
如果使用 row-based replication,副本关注的是行变化而不是重新执行语句的顺序,三种锁模式都可以安全使用。mixed format 对不适合 statement-based 的语句会采用行方式,也可以按实际复制策略评估。
| 现象或约束 | 先看什么 | 判断方向 |
|---|---|---|
| 高并发导入吞吐优先 | 是否有 row-based/mixed replication | 满足条件时考虑模式 2,接受编号不连续 |
| 必须按语句可预测地重放 | binlog_format 与副本配置 | 选择模式 0 或 1,并保持源副本一致 |
| 业务要求连续票号 | 是否把 AUTO_INCREMENT 当业务编号 | 重新设计独立的业务序列,不要靠改锁模式补连续性 |
一条实用的判断口诀
看到自增列有空洞,先查“并发 bulk insert、mixed-mode、回滚、删除”四件事;看到 interleaved,不要只问“为什么不连续”,而要问“复制格式是否允许、业务是否真的需要连续”。
对普通主键来说,唯一性和并发吞吐往往比连续性更重要。只有当编号承担票据、发票或外部序号职责时,才应该单独设计可审计、可补偿的业务编号机制。
常见追问
interleaved 会让主键重复吗?
正常的 InnoDB 自增分配保证并发生成值不重复;间隔和重复是两个不同问题。若出现重复,应另查显式写入、数据类型上限或表结构约束。
把锁模式改成 0 能消除所有间隔吗?
不能。模式 0 主要保证语句分配的连续性,但回滚、删除以及显式混合插入仍可能留下间隔。
能否用 MAX(id)+1 生成连续编号?
不建议在并发写入中这样做。它会把编号生成变成需要额外锁和冲突处理的业务逻辑,不能替代 InnoDB 的自增机制。
 用锁监控信息解释多个插入事务在同一索引间隙中的等待与兼容关系
- 上一篇
- 用锁监控信息解释多个插入事务在同一索引间隙中的等待与兼容关系
- 下一篇
- 使用多个 JSON path 删除嵌套对象成员并保持剩余文档结构
-
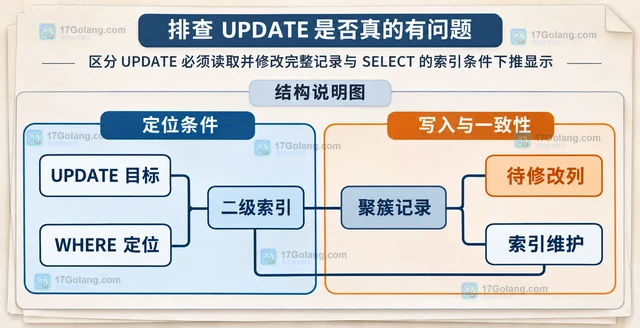
- 数据库 · MySQL | 28分钟前 | MySQL · 执行计划 · 索引优化 · mysql Update explain Index Condition Pushdown
- 区分 UPDATE 必须读取并修改完整记录与 SELECT 的索引条件下推显示
- 205浏览 收藏
-
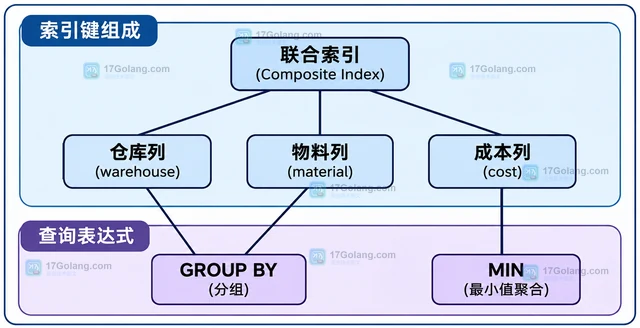
- 数据库 · MySQL | 31分钟前 |
- 用左前缀分组索引配合 MIN 直接取得每组最小值
- 203浏览 收藏
-
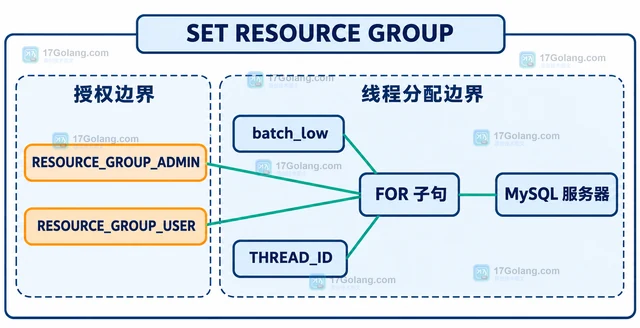
- 数据库 · MySQL | 1天前 | MySQL · mysql Performance Schema SET RESOURCE GROUP
- MySQL SET RESOURCE GROUP怎样把指定线程切换到目标资源组
- 291浏览 收藏
-
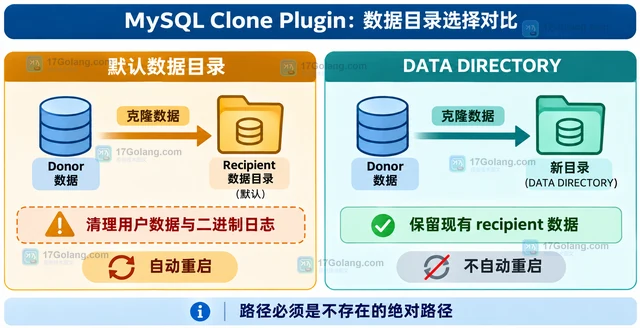
- 数据库 · MySQL | 1天前 |
- MySQL clone plugin怎样复制实例用于测试环境
- 260浏览 收藏
-
- 数据库 · MySQL | 1天前 | MySQL · 权限管理 ·
- MySQL roles怎样为只读账号组合最小权限
- 368浏览 收藏
-
- 数据库 · MySQL | 1天前 | MySQL · 空间计算 MySQL GIS ST_Distance_Sphere 经纬度距离
- MySQL GIS ST_Distance_Sphere怎样计算经纬度近似距离
- 148浏览 收藏
-
- 数据库 · MySQL | 1天前 | mysql JSON_TABLE JSON查询 ON EMPTY ON ERROR JSON null EXISTS PATH
- MySQL JSON_TABLE怎样把缺失字段和 JSON null 区分开
- 102浏览 收藏
-
- 数据库 · MySQL | 1天前 |
- MySQL recursive CTE怎样限制递归查询深度
- 137浏览 收藏
-
- 数据库 · MySQL | 1天前 |
- MySQL window function怎样在分组内取第二条记录
- 488浏览 收藏
-
- 数据库 · MySQL | 1天前 |
- MySQL optimizer_trace怎样读取一次查询的优化决策
- 152浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 893次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 894次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 978次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 965次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 790次使用
-
- MySQL 明明加了索引,为什么查询还是很慢?先查这 6 个点
- 2026-06-27 374浏览
-
- 接口返回的数据和数据库不一致怎么办?按数据生命周期排查
- 2026-06-27 398浏览
-
- Go map 并发写 panic 怎么办:从共享 map 到可控写入路径
- 2026-06-30 123浏览
-
- golang MySQL实现对数据库表存储获取操作示例
- 2022-12-22 499浏览
-
- golang 基于 mysql 简单实现分布式读写锁
- 2023-01-07 384浏览


