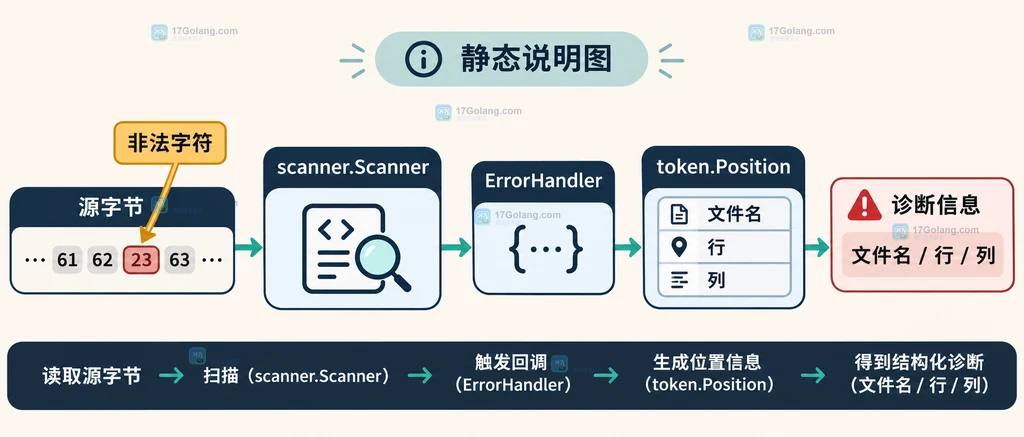
用 go/scanner 扫描一段 Go 源码时,词法错误里没有文件名,通常不是 Scanner 丢了信息,而是初始化时给它的 token.File 没有设置有意义的名称。Scanner 本身没有公开的 Filename 字段;正确做法是用 token.FileSet.AddFile 创建文件对象,把源文件名传进去,再把 Scanner.Init 的错误回调收到的 token.Position 输出出来。
把文件名交给token.File,把错误位置交给token.Position。只要Init使用的文件对象名称不是空的,回调就能生成类似configs/app.go:2:9的诊断前缀。
先分清 Scanner 与 token.File 的职责
scanner.Scanner 负责从 []byte 中逐个扫描 token,并在遇到语法或字符问题时调用 ErrorHandler。它保存的是扫描状态和错误计数;文件名、行列信息属于 go/token 的文件位置体系。
Scanner.Init 接收的第一个参数是 *token.File。扫描器根据它的名称、大小和行偏移表生成 token.Position。因此,下面两个对象的关系可以记成:
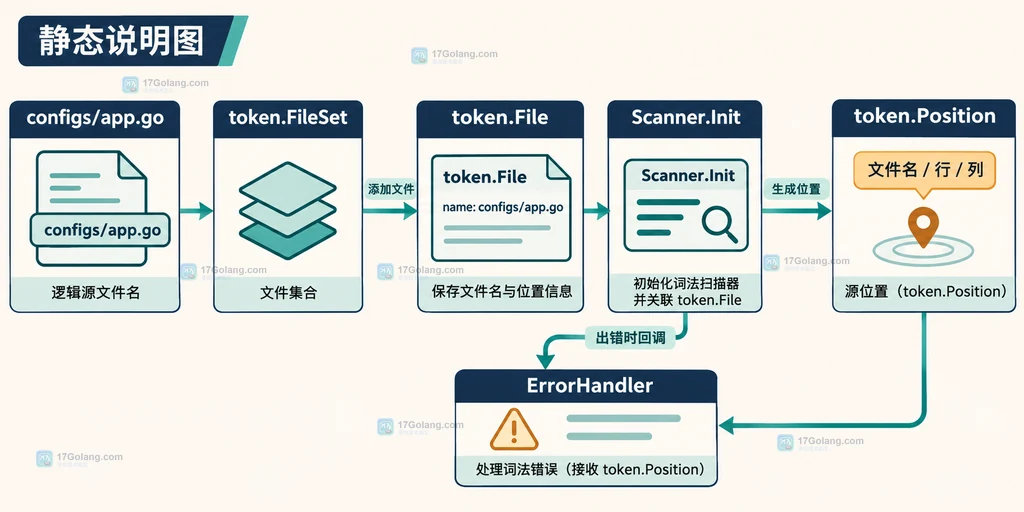
| 对象 | 职责 | 本文关注点 |
|---|---|---|
token.FileSet | 管理一组逻辑源文件 | 创建并定位文件 |
token.File | 保存文件名、基址、大小和行信息 | AddFile(name, base, size) 的 name |
scanner.Scanner | 扫描字节并调用错误处理器 | Init 与 Scan |
token.Position | 表达文件、行、列、偏移 | 回调中的诊断位置 |
创建带名称和大小的 token.File
先建立一个 FileSet,然后用 AddFile 传入逻辑路径。这里的路径不要求文件已经存在,它只是诊断信息中的源文件名;真正被扫描的内容仍然是 src。第三个参数必须等于 len(src),否则 Scanner.Init 会因为文件大小和源字节数不匹配而 panic。
package main

import (
    "fmt"
    "go/scanner"
    "go/token"
)

func main() {
    // 这个名称只是逻辑源文件名,会进入后续的 token.Position。
    filename := "configs/app.go"
    src := []byte("package main\nvar port = @\n")

    fset := token.NewFileSet()
    // base 使用 -1 让 FileSet 自己安排不重叠的偏移区间。
    file := fset.AddFile(filename, -1, len(src))

    var s scanner.Scanner
    s.Init(file, src, func(pos token.Position, msg string) {
        // pos.String() 会把文件名、行号和列号组合成可读前缀。
        fmt.Printf("%s: %s\n", pos, msg)
    }, 0)

    for {
        // Scan 返回当前位置、token 类型和可选的字面量。
        pos, tok, lit := s.Scan()
        if tok == token.EOF {
            break
        }
        fmt.Printf("%s\t%s\t%q\n", fset.Position(pos), tok, lit)
    }
}
关键不在于给 Scanner 赋一个不存在的字段,而在于把 filename 传给 AddFile。错误回调拿到的 pos 就拥有这个名称;扫描正常 token 时,也可以用 fset.Position(pos) 转成带文件名的位置。
通过 ErrorHandler 接住词法错误
Init 的第三个参数是函数类型 scanner.ErrorHandler。遇到错误字符时,扫描器会把错误位置和消息交给这个函数,并同步增加 Scanner.ErrorCount。回调不是只在 Scan 中才可能发生:官方文档特别说明,源文本第一个字符就有问题时,Init 也可能立即调用它,所以回调应在调用 Init 前准备好。
用 token.Position.String() 输出时,文件名、行号和列号会放在消息前面。若应用需要 JSON 日志或编辑器协议,也可以读取 pos.Filename、pos.Line、pos.Column 和 pos.Offset,不要再从格式化字符串反向解析。
需要汇总时使用 ErrorList
实时回调适合边扫边记录;如果调用方希望一次拿到全部问题,可以把回调收到的位置和消息加入 scanner.ErrorList。它实现了 error 接口,也可以交给 scanner.PrintError 按行输出。
package main

import (
    "fmt"
    "go/scanner"
    "go/token"
    "os"
)

func scanSource(filename string, src []byte) error {
    fset := token.NewFileSet()
    // AddFile 的 size 必须与 src 的字节长度一致,位置才能正确换算。
    file := fset.AddFile(filename, -1, len(src))

    var errors scanner.ErrorList
    var s scanner.Scanner
    s.Init(file, src, func(pos token.Position, msg string) {
        // ErrorList 保留每个错误的结构化位置,便于后续排序或转 JSON。
        errors.Add(pos, msg)
    }, scanner.ScanComments)

    for {
        // 即使出现词法错误,也继续扫描,尽量收集同一文件的更多问题。
        _, tok, _ := s.Scan()
        if tok == token.EOF {
            break
        }
    }
    if errors.Len() == 0 {
        return nil
    }

    // PrintError 会按行打印 ErrorList;不是 ErrorList 时才只打印单条错误。
    scanner.PrintError(os.Stderr, errors)
    return errors.Err()
}

func main() {
    if err := scanSource("configs/app.go", []byte("package main\nvar p = @\n")); err != nil {
        // 这里由上层决定是终止构建、返回接口错误还是继续处理其他文件。
        fmt.Println("scan failed:", err)
    }
}
ErrorList.Err() 在列表为空时返回 nil,有错误时返回等价的错误值。若只是要记录第一条问题,直接在回调中输出即可;不要为了打印文件名重复扫描。
处理复用与边界
复用扫描器时,文件对象和源字节要成对更新。官方实现会先检查 file.Size() != len(src),所以不能沿用旧文件对象去装载长度不同的新内容。重新扫描同一个文件时可以复用文件行信息;换了文件名或内容范围,就应创建匹配的新 token.File。
- 文件名是逻辑诊断名,不代表
scanner会自动打开或读取该路径。 AddFile和Init按字节长度工作,UTF-8 字符的列位置由扫描器和 token 文件共同换算。- 错误处理器可能在
Init期间被调用,注册回调和准备收集器要放在Init之前。 ScanComments只控制注释是否作为 token 返回,不负责错误文件名。ErrorCount适合快速判断扫描器遇到过多少错误,但需要错误详情时仍要保存回调参数。
采用建议
如果你的解析器只处理一段内存文本,给它一个稳定、可复制的逻辑文件名就够了,例如配置入口、生成文件或请求中的资源名;如果要处理多文件,则让每个文件拥有自己的 token.File,把调度问题留在上层。本文只解决词法诊断的文件名来源,不延伸到多文件解析顺序。
我的经验是:先把 token.Position 当作结构化数据保留下来,最后一步才格式化成人类可读文本。这样命令行可以打印 configs/app.go:2:13,服务端也能把同一个位置编码进 JSON,而不必再次猜测文件名和列号。
相关问答
Scanner 有可以直接设置的 Filename 字段吗?
没有。文件名由传给 Scanner.Init 的 *token.File 持有,通常通过 FileSet.AddFile 的第一个参数设置。
为什么 Init 还没有 Scan 就触发了错误回调?
初始化会读取源文本的起始字符。如果第一个字符已经是非法编码或非法字符,Init 可能立即报告错误。
只使用 ErrorCount 能得到文件名吗?
不能。ErrorCount 只有数量;文件名和具体消息需要从 ErrorHandler 的 token.Position 与 msg 中保存。
 Go crypto/rand.Prime 怎样按位数生成随机素数并处理错误