
Go HTTP 服务端怎么边读取请求体边写回响应
我第一次遇到这个问题,是在做一个边接收大请求体、边把处理结果写回客户端的 HTTP handler:代码明明已经调用了 Write,客户端却要等请求体接收得差不多以后才看到响应。把读取循环换成别的写法没有解决,真正的关键在 HTTP/1 服务端对“尚未读完的请求体”有一条默认处理边界。
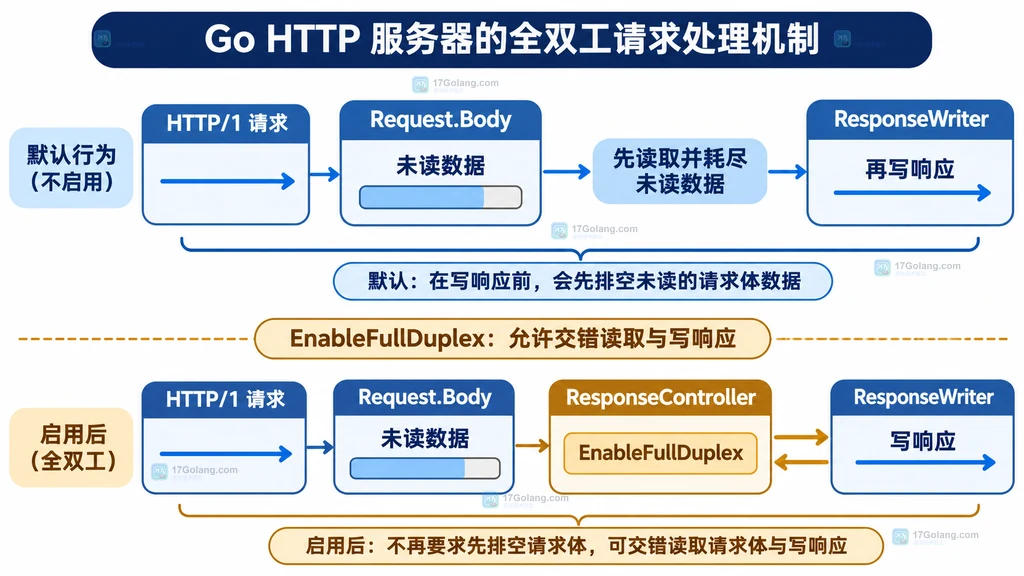
在 handler 第一次写响应之前,先用当前的 http.ResponseWriter 创建 http.ResponseController,再调用 EnableFullDuplex()。这样 Go 的 HTTP/1 服务端就允许 handler 继续读取 Request.Body,并把分块结果交错写到 ResponseWriter。HTTP/2 本身已经允许并行读取和响应,但调用这个方法仍然应该检查返回错误,因为自定义或包装过的 writer 可能不支持该能力。
要边读边写,调用时机比读取循环更重要:EnableFullDuplex 应该发生在第一次响应写出之前;它解决的是服务端默认消费未读请求体的问题,不是把任意 ResponseWriter 变成网络代理。
为什么普通 Write 看起来没有及时返回
HTTP/1 请求到达服务端后,handler 可以从 r.Body 读取数据。默认情况下,如果请求体还有一部分没有读完,Go HTTP 服务端会在开始写响应前先消费这部分未读数据。这个行为对普通“先收完请求、再返回响应”的接口很自然,却会让流式处理出现错觉:应用代码已经准备好一段结果,网络上的响应却没有按预期开始。
这也是为什么只在循环里增加 Flush 往往不够。Flush 负责把已经写入的响应数据尽量向客户端推进,而 EnableFullDuplex 负责改变 HTTP/1 请求体与响应写出的协调方式。一个是输出刷新,一个是读写边界,不能互相替代。
EnableFullDuplex 要放在第一次响应写出之前
ResponseController 是 handler 控制响应行为的入口。创建它时应传入 handler 收到的原始 ResponseWriter,然后在设置好响应头、但还没有调用 Write 或 WriteHeader 之前开启全双工能力:
func duplexHandler(w http.ResponseWriter, r *http.Request) {
	// 用 handler 收到的 writer 创建控制器,避免丢失底层能力。
	controller := http.NewResponseController(w)
	if err := controller.EnableFullDuplex(); err != nil {
		// 能力不可用时还没有写响应,可以安全返回明确的状态码。
		http.Error(w, "full duplex is not supported", http.StatusNotImplemented)
		return
	}

	// 设置响应头不会开始写响应,仍然可以放在能力开启之后。
	w.Header().Set("Content-Type", "application/octet-stream")
	// 这里再进入读取和写回循环,HTTP/1 才不会先替 handler 消费剩余请求体。
}
调用成功只表示当前 writer 暴露了这项能力,不代表客户端一定会立刻看到每一个小块。网络缓冲、代理、客户端读取方式以及是否调用 Flush,仍然会影响可见的到达节奏。
按块读取 Request.Body 并写回响应
下面的例子把请求体按 32 KB 读取,收到一块就写回一块,并在写入成功后尝试刷新。这个模式适合演示接口边界:真实业务通常会在写回之前做解析、校验或转换,但不能在未开启全双工时假定 HTTP/1 会同时推进读写。
package main

import (
	"io"
	"net/http"
)

func echoDuplex(w http.ResponseWriter, r *http.Request) {
	// 这个 handler 只接受提交请求,其他方法不进入流式读写逻辑。
	if r.Method != http.MethodPost {
		http.Error(w, "method not allowed", http.StatusMethodNotAllowed)
		return
	}

	// 必须在第一次 Write 之前开启 HTTP/1 的交错读写能力。
	controller := http.NewResponseController(w)
	if err := controller.EnableFullDuplex(); err != nil {
		// 此时尚未输出正文,仍可返回可读的错误响应。
		http.Error(w, "full duplex is not supported", http.StatusNotImplemented)
		return
	}
	w.Header().Set("Content-Type", "application/octet-stream")

	// 缓冲区控制每次读写的粒度,避免为整个请求体一次性分配内存。
	buf := make([]byte, 32*1024)
	for {
		n, readErr := r.Body.Read(buf)
		if n > 0 {
			// 先处理有效字节,再单独判断本次读取附带的错误。
			if _, writeErr := w.Write(buf[:n]); writeErr != nil {
				// 响应写失败后继续读取没有意义,直接结束 handler。
				return
			}
			// Flush 只负责推动已经写出的数据,不替代 EnableFullDuplex。
			if flushErr := controller.Flush(); flushErr != nil {
				return
			}
		}

		if readErr == io.EOF {
			// 请求体读完,正常结束流式响应。
			return
		}
		if readErr != nil {
			// 请求读取失败时不能把错误当成正常 EOF 继续写回。
			return
		}
	}
}

func main() {
	// 绑定示例 handler;生产服务还应配置超时、大小限制和日志策略。
	http.HandleFunc("/echo", echoDuplex)
	_ = http.ListenAndServe(":8080", nil)
}
代码把 n > 0 放在错误判断前,是因为一个 Read 调用可能同时返回有效字节和 io.EOF。先写出这批有效数据,再结束循环,比只看错误值更稳妥。响应已经开始后,如果后续读取失败,示例直接结束 handler;这时再调用 http.Error 可能把错误文本混进已经开始的二进制响应,不应机械套用。
HTTP/1、HTTP/2 和包装器的边界
EnableFullDuplex 的名字容易让人误以为所有协议都需要额外配置。实际判断可以压缩成下面三类:
| 场景 | 需要做什么 | 注意点 |
|---|---|---|
| HTTP/1 | 在首次写响应前调用 EnableFullDuplex | 它阻止服务端为了开始响应而先消费未读请求体 |
| HTTP/2 | 通常不需要额外开启 | 官方实现本身允许请求读取与响应写出并行进行 |
| 自定义 ResponseWriter | 检查返回错误 | 不支持时会得到匹配 ErrNotSupported 的错误 |
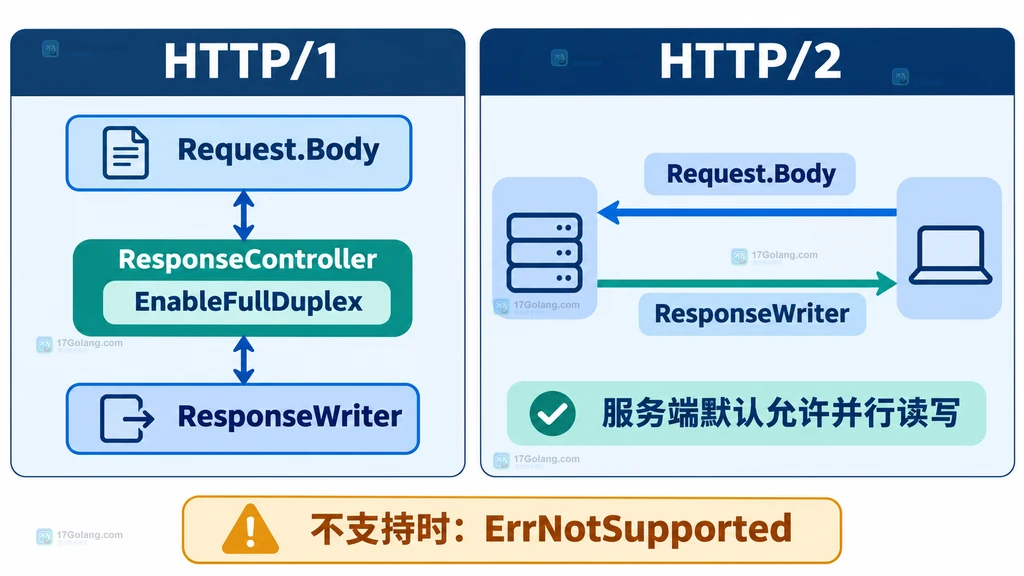
如果中间件包装了 ResponseWriter,要特别注意它是否实现了 Unwrap() http.ResponseWriter。ResponseController 会沿着可解包的 writer 查找底层能力;一个只转发 Header、Write、WriteHeader 却把其他方法完全藏起来的包装器,可能让控制器返回不支持。对这类中间件,优先让包装器保留官方约定的底层访问方式,而不是在业务 handler 里猜测具体实现类型。
三个容易把问题带偏的写法
先写一小段,再开启全双工
第一次 Write 可能已经触发响应提交。把 EnableFullDuplex 放到第一次写出之后,不能可靠地改变服务端此前已经做出的协调决定。调用顺序应固定为:创建控制器、开启能力、设置或确认响应头、进入读写循环。
只调用 Flush,不调用 EnableFullDuplex
Flush 解决的是缓冲数据何时向外推进;它并不会告诉 HTTP/1 服务端“不要先消费剩余请求体”。如果症状是请求还没有读完时响应迟迟不开始,先检查全双工能力是否在第一次写出前开启。
把请求体读写当成任意并发安全共享对象
全双工表示服务端允许 handler 交错读取请求体和写响应,不等于可以在多个 goroutine 中无约束地同时操作同一个 Request.Body 或 ResponseWriter。是否并发、如何退出、客户端断开后如何取消,都要由业务代码明确管理。本文示例刻意采用单 goroutine 的读一块、写一块,先把协议边界讲清楚。
我的取舍:需要实时回传时才打开它
如果接口本来就是“完整接收后统一返回”,不必为了形式调用 EnableFullDuplex;普通 handler 更容易阅读,服务端默认消费请求体也更符合常见生命周期。只有当客户端需要在上传尚未结束时看到阶段性结果、回显片段或处理进度,并且响应确实依赖于持续读取请求体时,全双工才有明确价值。
落地时我会把三个判断写在代码评审清单里:第一,调用是否发生在第一次响应写出之前;第二,读取循环是否同时处理有效字节和错误;第三,响应已经开始后是否避免再用 http.Error 破坏正文协议。这样排查时,问题就从“为什么流式响应不实时”收敛到了可以直接检查的接口边界。
相关问题
EnableFullDuplex 会让 HTTP/2 更快吗?
它主要针对 HTTP/1 的默认读写协调。HTTP/2 服务端本身已经允许并行读取请求和写响应,不应把这个方法当成通用性能开关。
调用 EnableFullDuplex 之后还要 Flush 吗?
如果希望已经写入的小块更早向客户端推进,仍可能需要调用 Flush。两者职责不同:前者改变 HTTP/1 的未读请求体处理,后者推动已写响应数据。
为什么 EnableFullDuplex 返回 ErrNotSupported?
通常说明当前 ResponseWriter 或它能解包到的底层 writer 没有提供这项能力。检查中间件是否保留原始 writer 和 Unwrap 能力,并为不支持的环境准备降级路径。
 Go time.Duration 怎么序列化成可读配置并正确反序列化
- 上一篇
- Go time.Duration 怎么序列化成可读配置并正确反序列化
- 下一篇
- Go go list -test -json 怎么查看测试变体和依赖包信息
-
- Golang · Go教程 | 22分钟前 |
- Go generate 怎么只对指定包运行代码生成指令
- 245浏览 收藏
-
- Golang · Go教程 | 25分钟前 |
- Go database/sql 怎么连续读取存储过程返回的多个结果集
- 136浏览 收藏
-
- Golang · Go教程 | 28分钟前 |
- Go database/sql.NamedArg 为什么有些驱动不能按名字绑定参数
- 325浏览 收藏
-
- Golang · Go教程 | 29分钟前 |
- Go go list -test -json 怎么查看测试变体和依赖包信息
- 461浏览 收藏
-
- Golang · Go教程 | 34分钟前 |
- Go time.Duration 怎么序列化成可读配置并正确反序列化
- 298浏览 收藏
-
- Golang · Go教程 | 35分钟前 |
- Go 优先队列元素优先级改变后怎么用 heap.Fix 重新排序
- 234浏览 收藏
-
- Golang · Go教程 | 37分钟前 |
- Go container/ring 怎么一次摘除连续的多个环形节点
- 226浏览 收藏
-
- Golang · Go教程 | 40分钟前 |
- Go time.Timer.Reset 在定时器未触发和已触发时有什么区别
- 381浏览 收藏
-
- Golang · Go教程 | 42分钟前 |
- Go 怎么从内置 TZif 数据加载自定义时区
- 390浏览 收藏
-
- Golang · Go教程 | 43分钟前 |
- Go 基准测试怎么用 ReportMetric 输出自定义吞吐指标
- 273浏览 收藏
-
- Golang · Go教程 | 45分钟前 |
- Go tool test2json 怎么把独立测试二进制输出转成事件流
- 494浏览 收藏
-
- Golang · Go教程 | 47分钟前 |
- Go 基准测试用 b.Cleanup 释放资源会不会算入基准耗时
- 272浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 891次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 891次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 974次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 961次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 785次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览


