Linux perf stat怎样按 CPU 核心查看硬件计数器
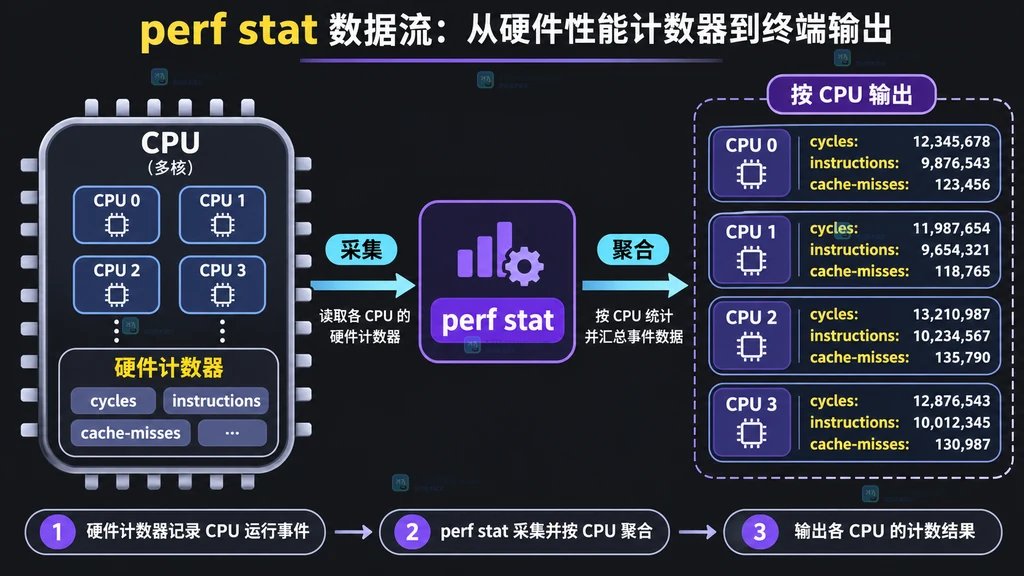
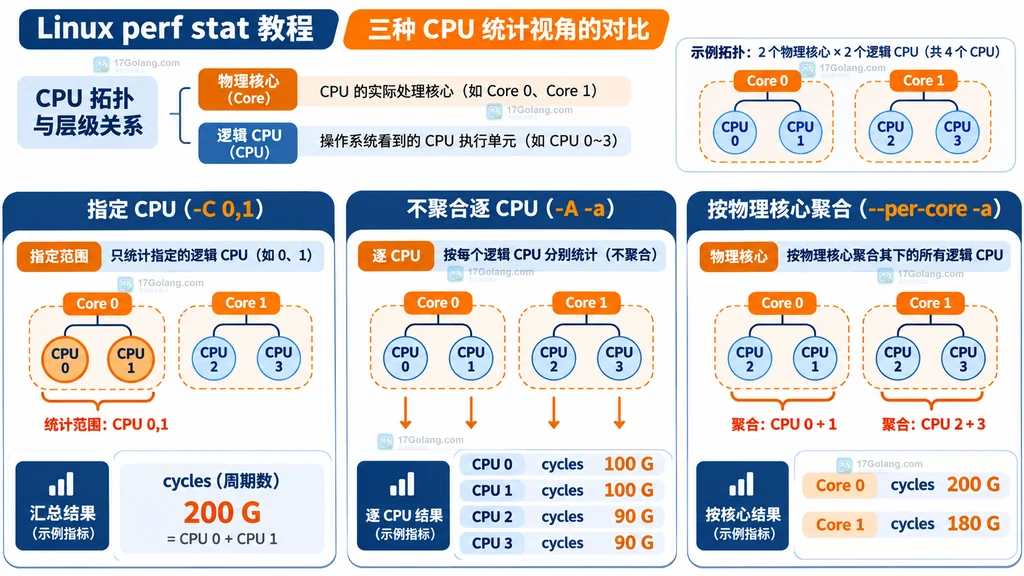
如果直接执行 perf stat -a,看到的通常是整机范围的汇总值;想知道哪个逻辑 CPU 或物理核心承担了更多 cycles、instructions,就要把“采集范围”和“聚合方式”分开设置。最实用的组合是:用 -C 选择逻辑 CPU,用 -A 取消跨 CPU 汇总,用 --per-core 按物理核心汇总。
官方地址:https://man7.org/linux/man-pages/man1/perf-stat.1.html
先用perf list确认事件,再用perf stat -a -C 0,1 -A -e cycles,instructions -- sleep 2查看指定逻辑 CPU 的独立计数;要看物理核心,则改用perf stat -a --per-core -e cycles,instructions -- sleep 2。-C解决“看哪些 CPU”,-A解决“是否合并”,--per-core解决“按什么硬件层级合并”。
先分清逻辑 CPU、物理核心和汇总值
Linux 的 CPU 编号通常指逻辑 CPU。开启超线程后,一个物理核心可能对应两个或更多逻辑 CPU;因此“CPU 0 的计数”与“核心 0 的计数”不是同一层含义。perf stat 默认会把同一类事件合并成较少的行,适合回答整机总量,却不适合定位 CPU 之间的负载差异。
这篇只讨论硬件计数器的系统级统计:不展开采样调用栈,也不把示意输出当成某台机器的实测结果。真实可用的事件名称取决于 CPU、内核和 PMU,不能把一台机器上的 raw event 编码直接搬到另一台机器。
一、确认 perf 事件和权限
先列出当前环境能够识别的事件,再选择通用的 cycles 和 instructions 做第一轮观察。硬件事件不可用时,perf 可能报权限错误、事件不存在或计数器无法调度;这时先处理环境问题,不要用一组看似精确的数字继续分析。
# 列出本机 perf 能识别的事件,避免直接猜测硬件事件名
perf list

# 查看系统级 perf 访问限制;数值越严格,普通用户越可能被拒绝
cat /proc/sys/kernel/perf_event_paranoid

# 只做一个短时系统级采集,先确认 cycles 和 instructions 能否打开
perf stat -a -e cycles,instructions -- sleep 1
命令中的 -- 用来分隔 perf 选项和被测命令。这里的 sleep 1 只是一个短窗口占位,不代表业务负载;分析真实程序时,把它替换成目标命令,或使用已有进程的 PID 模式。
二、用 -C 只看指定逻辑 CPU
-C 接收逗号分隔的 CPU 列表,也支持连续范围,例如 0,1 或 0-3。它解决的是“在哪里采集”,并不会自动让每个 CPU 单独显示。如果目标进程被调度到了其它 CPU,指定范围内的数字可能很小,这反而是一个有价值的调度线索。
# 只统计逻辑 CPU 0 和 1;-a 表示系统范围,-C 再缩小 CPU 集合
perf stat -a -C 0,1 -e cycles,instructions -- sleep 2

# 只统计连续的逻辑 CPU 0 到 3,事件名称保持不变
perf stat -a -C 0-3 -e cycles,instructions -- sleep 2
如果只需要观察某个进程,不能把 -C 当成进程绑定;可以先用 taskset 控制进程亲和性,再用 perf 采集,或者直接使用 perf 的进程筛选选项。CPU 选择和进程调度是两个不同问题。
三、用 -A 取消跨 CPU 聚合
要把每个被监控 CPU 的计数展开,使用 -A(--no-aggr)。它最适合配合 -a 和 -C:前者让统计作用于系统范围,后者限制范围,-A 再阻止 perf 把不同 CPU 合并成一行。
# 指定四个逻辑 CPU,并保留每个 CPU 的独立计数
perf stat -a -C 0-3 -A -e cycles,instructions -- sleep 2

# 用 CSV 风格分隔符输出,方便后续脚本按字段读取
perf stat -a -C 0-3 -A -x ';' -e cycles,instructions -- sleep 2
开启 -x 后,输出会包含 CPU 标识、计数值、事件名、计数器运行时间和运行百分比等字段;不要把整行只按空格切割。事件被分时复用时,运行百分比可能小于 100%,计数值也可能经过缩放,比较时要同时看运行时间和缩放状态。
四、用 --per-core 按物理核心聚合
--per-core 适用于系统级模式,会按物理处理器核心聚合计数,并显示该核心包含的逻辑 CPU 数。它和 -A 的目标不同:-A 保留被监控 CPU 或 PMU 实例的分开结果,--per-core 主动把同一物理核心下的逻辑 CPU 合并成核心级结果。
# 按物理核心汇总系统级 cycles 与 instructions
perf stat -a --per-core -e cycles,instructions -- sleep 2

# 只观察指定逻辑 CPU 所覆盖的范围,再按物理核心查看
perf stat -a -C 0-7 --per-core -e cycles,instructions -- sleep 2
在超线程机器上,物理核心聚合有助于回答“哪个核心更忙”,但会隐藏同一核心内部各逻辑 CPU 的差异。如果要判断线程是否集中在某个逻辑 CPU,先用 -A;如果要判断核心级的总体压力,再用 --per-core。两次采集的负载窗口应尽量一致。
五、让结果适合比较和脚本处理
实时排查可以使用间隔模式,让 perf 定期输出计数增量;批量分析则使用 -x 固定分隔符,再把 CPU 或核心标识作为维度保存。下面的示例只展示命令形状,输出中的数字会随硬件、内核和负载变化。
# 每 1000 毫秒输出一次增量,连续输出两次后结束
perf stat -a -C 0-3 -A -I 1000 --interval-count 2 -e cycles,instructions

# 重复执行同一短命令,观察均值和离散程度
perf stat -r 5 -e cycles,instructions -- ./workload
如果要把输出交给程序,建议保留事件名、CPU/核心标识、计数值和运行百分比;不要只保存一个总数。对于混合架构或不同 PMU 的机器,同名事件可能来自不同 PMU,必要时通过 perf list 和官方平台文档确认事件语义。
常见误区和排查顺序
| 现象 | 优先判断 | 处理方式 |
|---|---|---|
| 每个 CPU 都有数,但与预期差很多 | 工作负载是否真的运行在这些 CPU 上 | 结合 CPU 亲和性和调度情况重新确认采集范围 |
| 只能看到一个合计值 | 是否仍在默认聚合 | 系统级统计加 -A,再结合 -C 限定范围 |
| 核心数和 CPU 数对不上 | 是否启用了超线程或核心级聚合 | 分别比较 -A 与 --per-core 的结果 |
| 出现权限或 event open 错误 | perf 访问策略与硬件事件支持 | 先检查权限、内核配置和 perf list,不要直接解释数字 |
| 同一命令多次结果波动 | 负载和采样窗口是否稳定 | 使用 -r 或间隔模式,并记录运行百分比 |
速查:该选哪种写法
| 目标 | 建议命令骨架 | 结果层级 |
|---|---|---|
| 只看指定逻辑 CPU | perf stat -a -C 0,1 ... | 指定范围,默认可能仍汇总 |
| 逐个逻辑 CPU 查看 | perf stat -a -C 0-3 -A ... | CPU 级 |
| 按物理核心查看 | perf stat -a --per-core ... | 核心级 |
| 导入脚本或表格 | perf stat -a -A -x ';' ... | 带标识的分隔字段 |
结语
perf stat 按 CPU 核心查看硬件计数器时,关键不是记住一个参数,而是先确定要回答哪一层问题:-C 选择逻辑 CPU,-A 展开独立计数,--per-core 聚合物理核心。先用通用事件确认权限和采集范围,再用固定输出格式保存结果,才能把一次观察变成可比较的性能证据。
相关问题
- 为什么
-C后某个 CPU 的计数接近零? 可能是目标任务没有在该 CPU 上运行,也可能是系统级窗口太短,应结合亲和性和更长采样窗口判断。 -A和--per-core能同时使用吗? 两者表达的聚合意图不同,实际是否被当前 perf 版本接受应以本机帮助和输出为准;通常先分别采集,避免把逻辑 CPU 级与核心级结果混读。- 为什么 hardware event 在一台机器上可用,换机器就失败? 硬件 PMU 事件和内核支持有关,应先用本机
perf list确认,不要照搬 raw 编码。 - CSV 输出为什么还有空字段? 不同事件和模式会产生不同字段,官方手册定义的 CPU、计数值、事件名、运行时间等列应按字段位置解析。
 Linux cgroup v2 io.stat怎样区分设备读写吞吐