
Go bufio.Reader.Peek 怎样复用已有缓冲空间
我在处理“先判断消息类型,再把同一条流交给解析器”的 Go 代码时,最先想到的是把前几个字节读进一个新切片。后来发现,这个判断通常只需要持续几微秒:bufio.Reader.Peek 已经把数据放在自己的缓冲区里,直接借用那段窗口就够了。
想复用已有缓冲空间时,把Peek(n)的返回值当成“暂时可读的视图”,在下一次读取前完成判断或解析;如果还要跨读取保存,就复制一份。需要反复接入不同输入时,再用Reader.Reset复用同一个 Reader 对象和内部缓冲区。
官方文档:https://pkg.go.dev/bufio#Reader.Peek
先弄清楚 Peek 到底复用了什么
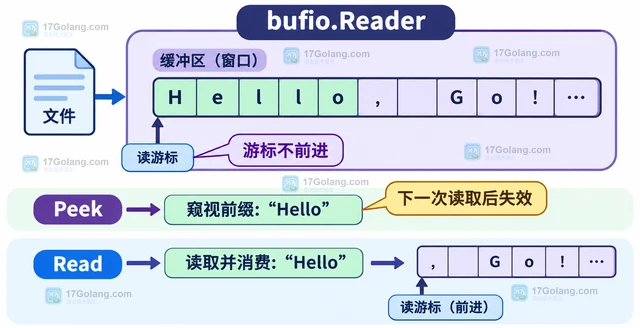
Peek(n) 返回当前输入接下来最多 n 个字节的切片,而且不会推进 Reader 的读取位置。为了凑够长度,Reader 必要时会继续从底层 io.Reader 填充自己的内部缓冲区。这里的“复用”有两个边界:调用方没有传入一块可由 Peek 写入的目标数组,返回切片也不能在下一次读取后继续当作稳定数据保存。
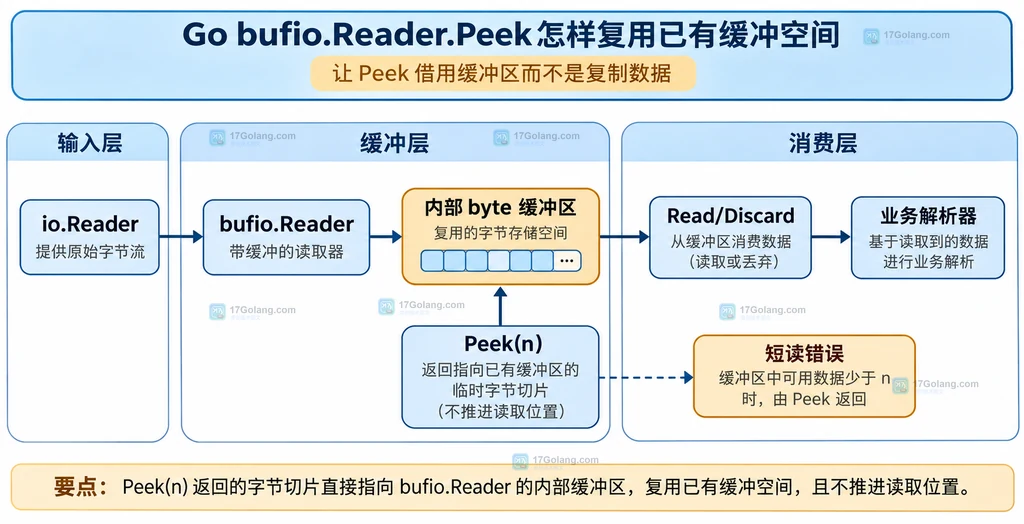
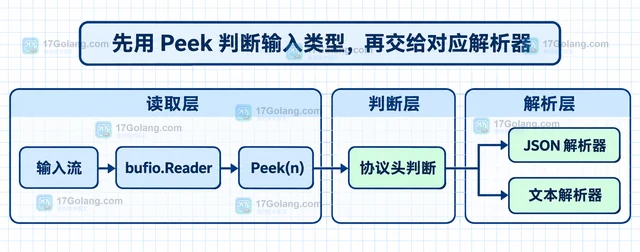
所以它适合做协议头判断、文件格式前缀判断、消息路由和轻量分类。它不适合替代真正的读取:确认完前缀后,仍然要用同一个 Reader 继续 Read、ReadString 或交给解析器。
直接用 Peek 返回的窗口做判断
下面的例子用四字节前缀区分两种消息。判断只读取返回切片,不把它转成字符串,也不复制到新的字节数组;确认类型以后,仍然把同一个 Reader 交给后续处理。
package main

import (
    "bufio"
    "bytes"
    "fmt"
    "io"
    "strings"
)

// classifyMessage 只查看流头部,不消费已经缓冲的字节。
func classifyMessage(reader *bufio.Reader) (string, error) {
    // Peek 返回 Reader 内部缓冲区的窗口;这里的判断应在下一次读取前完成。
    prefix, err := reader.Peek(4)
    if err != nil {
        // 短输入可能仍带回已有字节;没有完整前缀时按输入不足处理。
        if err == io.EOF && len(prefix) > 0 {
            return "输入过短", fmt.Errorf("消息头只有 %d 个字节", len(prefix))
        }
        return "", fmt.Errorf("查看消息头失败: %w", err)
    }

    // bytes.Equal 直接使用返回窗口,不为分类判断创建副本。
    switch {
    case bytes.Equal(prefix, []byte("GMSG")):
        return "文本消息", nil
    case bytes.Equal(prefix, []byte("GBIN")):
        return "二进制消息", nil
    default:
        return "未知消息", nil
    }
}

// handleStream 展示分类后继续消费同一个 Reader 的方式。
func handleStream(input io.Reader) error {
    reader := bufio.NewReaderSize(input, 64)

    kind, err := classifyMessage(reader)
    if err != nil {
        return err
    }

    // Peek 不会前移游标,所以这里仍从消息开头读取后续内容。
    line, err := reader.ReadString('\n')
    if err != nil && err != io.EOF {
        return fmt.Errorf("读取消息体失败: %w", err)
    }
    fmt.Printf("类型=%s,首段=%q\n", kind, strings.TrimSpace(line))
    return nil
}

func main() {
    // 真实项目中 input 可以来自连接、文件或管道;这里仅展示调用关系。
    if err := handleStream(strings.NewReader("GMSG:hello\n")); err != nil {
        fmt.Println(err)
    }
}
这段代码的关键不是 bytes.Equal 本身,而是分类函数没有把 prefix 长期带出去。ReadString 一旦继续读取,Reader 可能移动或覆盖内部缓冲区;如果后面需要保存消息头,就要在读取前显式复制。
需要长期保存时,复制而不是延长 Peek 的寿命
“复用缓冲空间”与“永久持有返回切片”是两件相反的事。前者减少短暂判断的分配,后者如果不复制,会让业务对象引用一段随时可能被覆盖的内部存储。
// readHeaderCopy 在需要跨下一次读取保存消息头时创建独立副本。
func readHeaderCopy(reader *bufio.Reader, n int) ([]byte, error) {
    // n 必须先限制在业务允许的范围,避免无界地扩大缓冲需求。
    if n  64 {
        return nil, fmt.Errorf("消息头长度不在允许范围内: %d", n)
    }

    // Peek 只负责借出当前窗口,不负责提供长期存储。
    view, err := reader.Peek(n)
    if err != nil {
        return nil, fmt.Errorf("读取消息头失败: %w", err)
    }

    // append 到 nil 切片会建立独立副本,后续 Read 不会改写它。
    saved := append([]byte(nil), view...)
    return saved, nil
}
如果业务只在当前函数里比较前缀,保留零复制路径;如果要把头部放入队列、缓存或异步任务,复制的成本换来清晰的所有权。不要用“把切片容量调大”来解决生命周期问题,容量大小不会改变底层数组的所有权。
用 Reset 复用同一个 Reader 的内部空间
另一种常见需求是批量处理很多短输入:每条输入都创建一个新的 bufio.Reader,会不断分配和回收 Reader 及其缓冲区。只要前一个输入已经处理完,就可以保留 Reader,把底层来源替换成下一个输入。
// scanManyInputs 复用一个 Reader 对象处理多段独立输入。
func scanManyInputs(inputs []io.Reader) error {
    // 先创建一次固定容量的缓冲区,后面由 Reset 继续使用。
    reader := bufio.NewReaderSize(strings.NewReader(""), 128)

    for index, input := range inputs {
        // Reset 会丢弃旧的缓冲数据,并把 Reader 连接到新的输入。
        reader.Reset(input)

        prefix, err := reader.Peek(4)
        if err != nil && err != io.EOF {
            return fmt.Errorf("第 %d 段输入查看前缀失败: %w", index, err)
        }

        // 当前循环只在本轮使用 prefix,下一轮 Reset 后不再引用它。
        fmt.Printf("第 %d 段前缀=%q\n", index, prefix)
    }
    return nil
}
Reset 复用的是 Reader 自己的内部状态和缓冲空间,不会把旧输入的剩余字节带到新输入中。调用方必须保证旧输入的处理已经结束,并且不能把旧的 Peek 切片带进下一轮。若把一个已经足够大的 *bufio.Reader 再传给 NewReaderSize,官方实现也会直接复用这个 Reader,而不是无条件包一层。
把短读、容量上限和 Unread 边界分开
遇到异常时,我会先看返回了多少字节,再看错误类型。不要把所有非空错误都当成“Peek 没有读到数据”。
| 情况 | 含义 | 处理方式 |
|---|---|---|
err == nil | 已经拿到完整的 n 个字节 | 立即完成判断或把窗口交给当前解析函数 |
返回部分字节并带 io.EOF | 输入比 n 短,但已有字节仍然存在 | 按业务区分短消息与可接受的末尾片段 |
bufio.ErrBufferFull | 请求长度大于 Reader 的缓冲容量 | 降低预览长度,或用更大的 NewReaderSize 创建 Reader |
Peek 后立即调用 UnreadByte | Peek 不是一次可供 UnreadByte 追溯的读取操作 | 不要把 Peek 与 UnreadByte 的状态假设混在一起 |
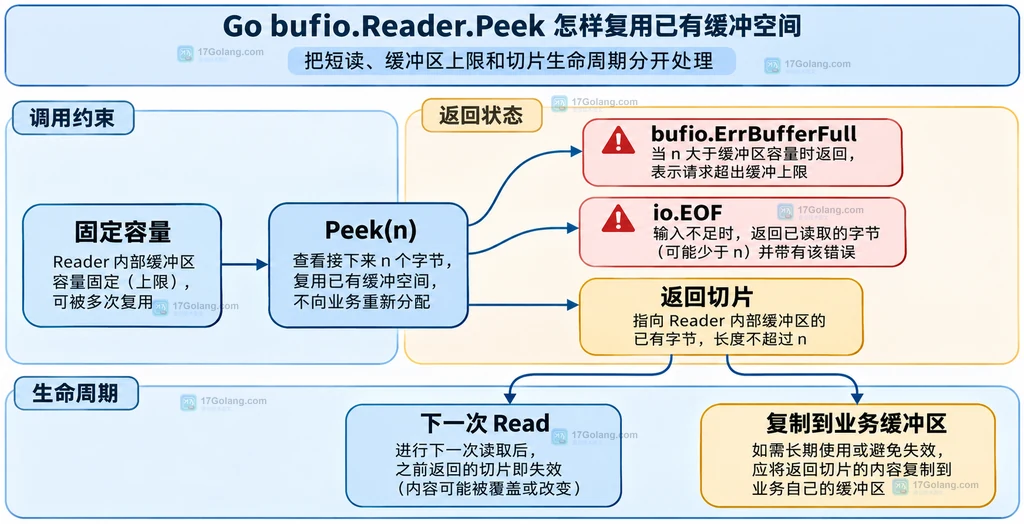
特别要注意,ErrBufferFull 不是“底层流坏了”,而是预览需求超过了当前 Reader 的容量。调整 Reader 容量可以解决长度问题,却不会替你处理无限长输入;协议头应有明确上限,不能为了让 Peek 成功而把整条消息都放进缓冲区。
我最后会保留的使用准则
- 只需要判断前缀时,直接消费
Peek返回窗口,避免把它转换成字符串或新切片。 - 需要跨下一次读取保存时,用
append([]byte(nil), view...)明确复制,建立业务自己的所有权。 - 批量处理独立输入时,用
Reset复用 Reader;每次切换前结束上一段输入的引用。 - 把预览长度限制在协议允许范围内,并为
ErrBufferFull、短输入和底层错误提供不同分支。 - 不要把 Peek 当作消费动作,也不要把它当作安全边界;真正的权限、协议和资源限制仍由外层设计负责。
常见追问
Peek 会不会把前 n 个字节读走?
不会。它不会推进 Reader 的读取位置,后续 Read 仍能看到同一段数据;但返回切片只在下一次读取前有效。
能不能让 Peek 把数据写入我提供的 []byte?
不能。Peek 的签名返回的是 Reader 内部窗口。如果需要把数据读入调用方拥有的切片,应使用 Read 或 io.ReadFull,并自行处理读取位置。
把 NewReaderSize 的容量调得很大是不是更快?
不一定。容量只决定一次能在 Reader 内部保留多少数据;它应匹配前缀或协议头上限。过大的容量会放大每个 Reader 的内存占用,不能替代流式消费。
 Go bufio.Reader.Peek 怎样读取受限根目录中的文件
- 上一篇
- Go bufio.Reader.Peek 怎样读取受限根目录中的文件
- 下一篇
- Go bufio.Reader.Peek 怎样组合到一个小型工具中
-
- Golang · Go教程 | 30分钟前 |
- Go slices.BinarySearch 怎样判断输入是否满足边界
- 453浏览 收藏
-
- Golang · Go教程 | 33分钟前 |
- Go slices.BinarySearch 怎样读取受限根目录中的文件
- 403浏览 收藏
-
- Golang · Go教程 | 37分钟前 |
- Go slices.Compact 怎样组合到一个小型工具中
- 242浏览 收藏
-
- Golang · Go教程 | 37分钟前 | 标准库 · go · Go 切片去重 slices.Compact
- Go slices.Compact 怎样处理空值和异常分支
- 140浏览 收藏
-
- Golang · Go教程 | 38分钟前 | go · Go切片 slices.Compact
- Go slices.Compact 怎样复用已有缓冲空间
- 125浏览 收藏
-
- Golang · Go教程 | 38分钟前 |
- Go slices.Compact 怎样判断输入是否满足边界
- 123浏览 收藏
-
- Golang · Go教程 | 42分钟前 |
- Go slices.Compact 怎样去除连续重复元素并保留原切片顺序
- 383浏览 收藏
-
- Golang · Go教程 | 47分钟前 |
- Go strings.CutSuffix 怎样只删除最外层重复后缀
- 410浏览 收藏
-
- Golang · Go教程 | 54分钟前 |
- Go regexp/syntax.Parse 怎样把正则模式转成可分析语法树
- 182浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go strings.CutSuffix 怎样复用已有缓冲空间
- 113浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go regexp.Compile 怎样把配置错误返回给调用方
- 107浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 863次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 866次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 944次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 922次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 754次使用
-
- Go map 并发写 panic 怎么办:从共享 map 到可控写入路径
- 2026-06-30 123浏览
-
- GScript 编写标准库示例详解
- 2022-12-30 369浏览
-
- 关于Golang标准库flag的全面讲解
- 2023-02-25 344浏览
-
- Golang标准库unsafe源码解读
- 2022-12-29 464浏览
-
- go语言中的defer关键字
- 2023-02-17 150浏览