
Service Worker Cache 怎样按请求方法过滤缓存
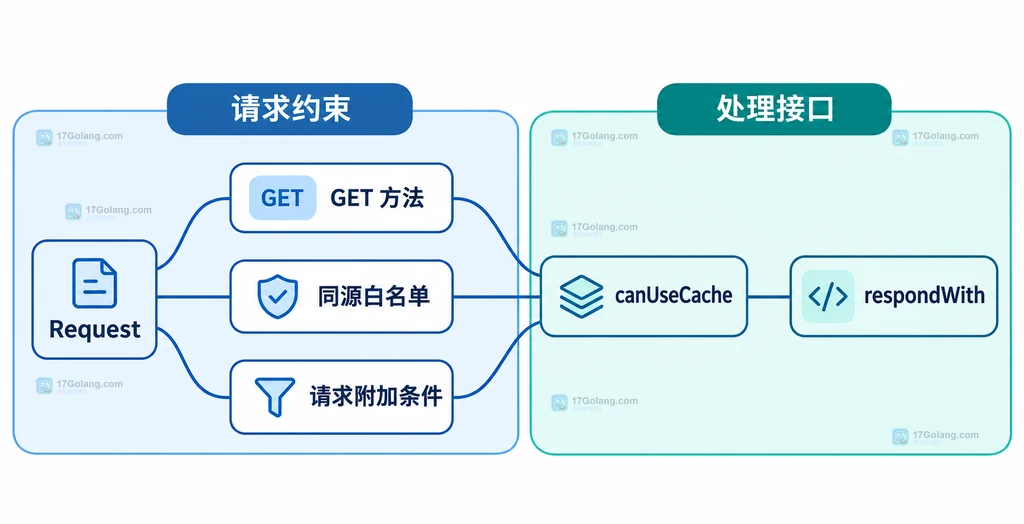
Service Worker 中按请求方法过滤 Cache,最直接的做法是在 fetch 监听器入口检查 request.method === "GET",只有符合业务白名单的请求才调用 event.respondWith 并读写缓存。不要把 POST 转成 GET 再存,也不要用 ignoreMethod: true 当作允许写入其他方法的开关。方法过滤与资源是否适合缓存,是两层不同的决定。
规范地址:https://w3c.github.io/ServiceWorker/
先确定哪些请求属于缓存接口
假设一个资料阅读器同时请求公共样式、公共脚本和提交收藏的接口。这里是原创设计场景,不是线上事故记录。我的选择是让缓存只负责两个带版本名的公共静态资源,把收藏提交留给正常网络路径。这样离线样式可以复用,提交动作不会误收到一份旧的静态响应。
GET 是必要条件,却不是“可以长期保存”的证明。用户资料、带身份信息的响应和动态业务接口不属于本例的白名单。服务端还应保证下面两个静态路径对不同账号返回相同的公开内容;若同一路径会按会话改变内容,就不满足这个设计前提。
| 请求 | 本例决定 | 理由 |
|---|---|---|
| GET 白名单静态资源 | 允许缓存处理 | 内容公开且路径带版本 |
| POST、PUT、PATCH、DELETE | 本监听器不拦截 | 不复用 GET 缓存 |
| HEAD | 本监听器不拦截 | 不在本例的 GET 合约内 |
| 其他 GET 路径或查询串 | 本监听器不拦截 | 未获得缓存授权 |
把方法过滤放到 respondWith 之前
下面是 Service Worker 脚本中的 fetch 处理片段,用来替换相同职责的既有监听器。注册、安装和激活属于宿主应用已有流程,不在本例重复增加。把公共资源实际路径替换进白名单,再与服务器的发布版本保持一致。Cache API 与 Service Worker 依赖相应运行环境,通常部署在 HTTPS 安全上下文。
// 此白名单仅适用于服务器保证公开、与登录身份无关的版本化资源。
const CACHE_NAME = "reader-public-static-v3";
const PUBLIC_PATHS = new Set([
  "/public-static/reader.v3.css",
  "/public-static/reader.v3.js",
]);

function canUseCache(request) {
  if (request.method !== "GET") return false; // 先限定方法。
  const url = new URL(request.url);
  return url.origin === self.location.origin
    && PUBLIC_PATHS.has(url.pathname)
    && url.search === ""
    && !request.headers.has("Authorization")
    && !request.headers.has("Range")
    && request.cache !== "no-store"
    && request.cache !== "reload";
}

self.addEventListener("fetch", (event) => {
  const request = event.request;
  if (!canUseCache(request)) return; // 此监听器放行,不创建替代请求。
  event.respondWith(readPublicAsset(request)); // 同步登记响应承诺。
});
入口判断不需要等待异步任务,因此 respondWith 能在事件回调期间调用。return 表示这个监听器不提供响应,并不替服务器返回成功;其他 fetch 监听器仍可能处理它。项目若有多个路由,应把相同规则合并到统一入口,避免一处放行、另一处又重新缓存。
保持读取和写入使用同一请求
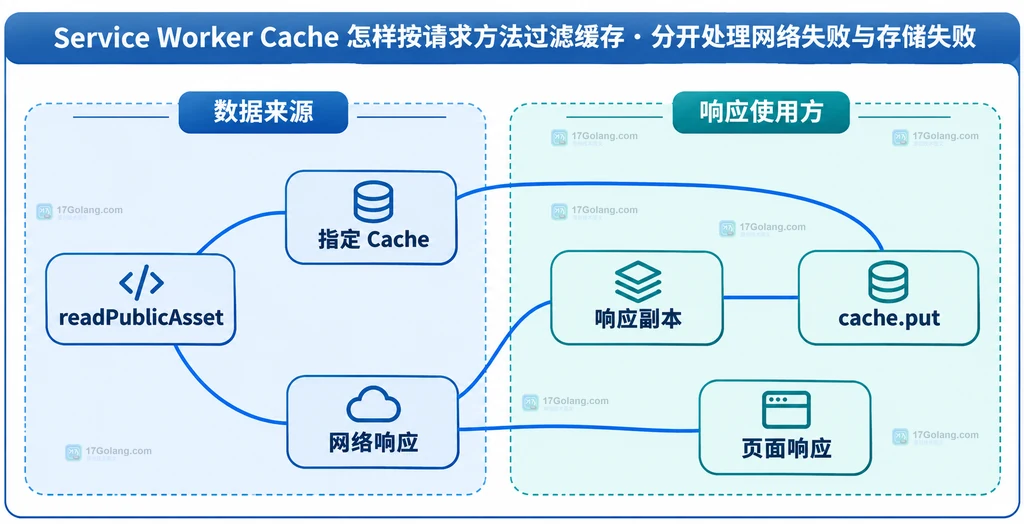
readPublicAsset 延续同一个 Request:先从指定 Cache 读取,未命中才请求网络。它采用缓存优先,适合上述路径不变则内容不变的版本化资源。新内容应换新路径;如果希望同路径更新,应另外设计刷新策略,不能期待本例自动重新验证。
// 缓存不可用时仍允许网络读取;错误日志不打印 URL、请求头或响应内容。
async function readPublicAsset(request) {
  let cache = null;
  try {
    cache = await caches.open(CACHE_NAME);
    const hit = await cache.match(request); // 保留默认匹配选项。
    if (hit) return hit;
  } catch {
    console.warn("公共资源缓存读取失败");
  }

  // 网络失败让 Promise 拒绝,不伪装成提交成功或空白 200 响应。
  const response = await fetch(request);
  const cacheControl = response.headers.get("Cache-Control") ?? "";
  const vary = response.headers.get("Vary") ?? "";
  const hasVaryStar = vary.split(",").some((field) => field.trim() === "*");
  const mayStore = response.status === 200
    && response.type === "basic"
    && !response.redirected
    && !/\b(?:no-store|private)\b/i.test(cacheControl)
    && !hasVaryStar;

  if (cache && mayStore) {
    try {
      // 分出一份响应体供 Cache 消费,原响应仍交给浏览器。
      await cache.put(request, response.clone());
    } catch {
      console.warn("公共资源缓存写入失败");
    }
  }
  return response;
}
这个函数应与上一段放在同一个 Service Worker 脚本中。它没有主动扩大存储范围:只接受状态 200、同源 basic、未重定向的响应;分段 206、opaque 及错误响应不保存。Cache API 本身不会替应用遵循 HTTP 缓存头,本例对 no-store、private 的判断是主动增加的业务限制,不是一个完整的 HTTP 缓存实现。
Cache.put 的写入请求方法被规范限定为 GET。调用时传入原 request,保留方法、URL 和请求头,而不是只传 request.url 创建默认 GET。Response.clone 则是为了区分给页面与给缓存的响应体使用方;它不是解决请求方法问题的工具。
分开处理网络失败与存储失败
我更倾向于让存储失败降低离线能力,而不毁掉已经拿到的网络响应。因此代码在 put 失败后仍返回 response。相反,网络本身失败且缓存没有命中时,函数拒绝,浏览器得到相应失败结果;若产品需要离线提示,可以增加专门的资源或页面回退,但不能对所有业务请求返回同一份“成功”。
本例等待 put 完成后才交出网络响应,使写入处于响应承诺的生命周期内,代价是未命中路径会多等一次存储。需要缩短这段等待时,可以专门设计 waitUntil 延长后台任务生命周期;不要简单去掉 await,留下无人处理的 Promise。这里选择代码短、错误边界明确的写法,没有声称它是所有页面的最快方案。
保留匹配参数并限定缓存生命周期
ignoreMethod 只改变查询时的方法条件,不会赋予 Cache.put 保存 POST 的能力,更不会把请求体纳入一个可靠的业务缓存键。如果给提交请求打开这个选项,相同 URL 的 GET 缓存可能被拿来代替提交响应。对于“同 URL、不同方法”的接口,我会把方法条件固定在入口,不让调用方随意传查询开关。
本例也不设置 ignoreSearch 或 ignoreVary。URL 查询参数可能代表不同内容,Vary 可能要求按请求头区分响应,忽略它们需要额外证明。这里直接拒绝任何查询串,让白名单集合的含义清楚。
缓存名使用 reader-public-static-v3,只读取这一份缓存,不跨所有缓存寻找“碰巧匹配”的响应。更新后可在应用既有激活策略中清理自己拥有的旧版本;不要删除同源下所有 Cache。Cache 条目没有因为 HTTP max-age 到点就自动过期,存储也可能被浏览器回收,因此它不能替代持久业务存储。
按调用方结果排查常见问题
为什么加了 ignoreMethod 仍然 put 失败?它是查询参数,不改变写入约束。先确认写入请求确实是 GET,再区分响应体已消费、响应类型、Vary 和存储等原因。
为什么 HEAD 没走这个缓存?本例显式只接收 GET;需要 HEAD 语义时单独设计,不能通过返回含正文的 GET 响应含糊替代。
为什么 POST 离线仍失败?方法过滤没有提供离线提交队列,也没有重放业务动作。这里的目标是公共静态资源复用,提交请求的离线处理属于另一项接口设计。
GET 白名单是否意味着一定返回缓存?不意味着。缓存未命中、被回收或存储不可用时仍需要网络。本例只限定缓存职责,不能保证永久离线可用。
技术依据:Cache 查询与写入规则见 Service Workers 规范;接口说明可查 https://developer.mozilla.org/en-US/docs/Web/API/Cache、https://developer.mozilla.org/en-US/docs/Web/API/Cache/put 与 https://developer.mozilla.org/en-US/docs/Web/API/Cache/match。代码中的公开资源白名单和失败策略是本文的应用设计选择。
 CSS Custom Highlight API 怎样高亮搜索结果而不改 DOM
- 上一篇
- CSS Custom Highlight API 怎样高亮搜索结果而不改 DOM
- 下一篇
- ElementInternals 怎样让自定义元素参与表单校验
-
- 文章 · 前端 | 1小时前 | 前端 · CSS Ruby ruby-align rt 注音排版
- CSS ruby-align 怎样调整注音与汉字的对齐方式
- 124浏览 收藏
-
- 文章 · 前端 | 1小时前 |
- ElementInternals 怎样让自定义元素参与表单校验
- 109浏览 收藏
-
- 文章 · 前端 | 1小时前 | javascript · css · range CSS Custom Highlight API Highlight CSS.highlights ::highlight()
- CSS Custom Highlight API 怎样高亮搜索结果而不改 DOM
- 118浏览 收藏
-
- 文章 · 前端 | 1小时前 | 前端 · CSS container-type @container scroll-state 滚动状态查询
- CSS scroll-state() 怎样根据容器滚动状态切换样式
- 441浏览 收藏
-
- 文章 · 前端 | 1小时前 | 错误处理 · javascript · 异步编程 · 前端开发 · JavaScript 异步任务 Promise Promise.allSettled 结果处理
- JavaScript Promise.allSettled 怎样保留每个任务结果
- 410浏览 收藏
-
- 文章 · 前端 | 1小时前 | css · 瀑布流布局 Grid @supports CSS Masonry CSS grid lanes 不等高卡片
- CSS grid lanes 怎样实现不等高卡片的紧凑布局
- 486浏览 收藏
-
- 文章 · 前端 | 1小时前 | css · anchor-name position-area CSS anchor positioning
- CSS anchor positioning 怎样把提示框对齐到按钮
- 344浏览 收藏
-
- 文章 · 前端 | 1小时前 | javascript · 前端开发 · 浏览器API · JavaScript sort 浅拷贝 toSorted Array.prototype.toSorted 不可变排序
- JavaScript Array.toSorted 怎样避免原数组被改写
- 177浏览 收藏
-
- 文章 · 前端 | 1小时前 |
- JavaScript Map.groupBy 怎样按对象引用分组
- 106浏览 收藏
-
- 文章 · 前端 | 1小时前 | javascript · 浏览器API · JavaScript dom Hidden disabled 布尔属性 Element.toggleAttribute
- JavaScript Element.toggleAttribute 怎样同步布尔属性
- 102浏览 收藏
-
- 文章 · 前端 | 1小时前 | html · javascript · 可访问性 · 模态框 无障碍 焦点管理 HTML inert HTMLElement.inert
- HTML inert 属性怎样让模态框外内容不可交互
- 199浏览 收藏
-
- 文章 · 前端 | 1天前 | vite package.json optimizeDeps 依赖预构建 条件导出
- Vite 依赖预构建为什么会因条件导出重复
- 357浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 858次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 862次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 940次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 919次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 747次使用
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览