
MySQL 锁等待超时怎样定位阻塞事务
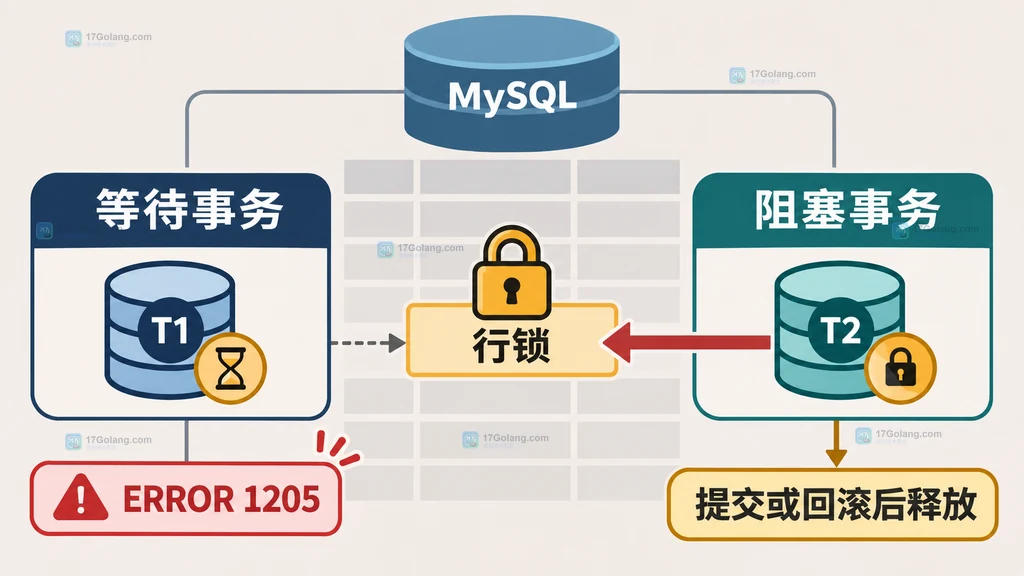
MySQL 出现 ERROR 1205 (HY000): Lock wait timeout exceeded; try restarting transaction 时,最先要找的不是“把超时时间调大”,而是哪个事务一直占着锁、哪个事务正在等待。最短路径是先查询 sys.innodb_lock_waits,拿到 waiting_pid、blocking_pid、等待 SQL 和阻塞 SQL,再回到事务上下文判断应该提交、回滚、终止连接,还是修正应用的事务边界。
官方地址:https://dev.mysql.com/doc/refman/8.4/en/innodb-information-schema-transactions.html
本文只讨论 InnoDB 行锁等待的定位过程,同时把死锁和元数据锁列为必须先排除的相邻问题。下面的查询用于观察和定位,不代表已经在你的实例上执行过。
先判断:你遇到的到底是哪类等待
锁等待超时常见于一个事务修改了行但迟迟没有提交,另一个事务随后修改同一行。InnoDB 的 innodb_lock_wait_timeout 默认值是 50 秒,单位是秒,针对的是 InnoDB 行锁等待;默认超时后只回滚当前语句,不会自动把整个事务清掉。
但以下三种情况不能混在一起处理:
| 现象 | 优先观察 | 处理思路 |
|---|---|---|
| 单个事务长时间等行锁 | sys.innodb_lock_waits、INNODB_TRX | 找出持锁事务,确认是否应提交或回滚 |
| 事务之间形成环路 | 死锁错误、InnoDB 状态 | 按死锁处理,重试完整事务并修复访问顺序 |
| DDL 或表结构操作被卡住 | performance_schema.metadata_locks | 排查元数据锁,不要只查 InnoDB 行锁表 |
第一步:用 sys.innodb_lock_waits 快速找出双方
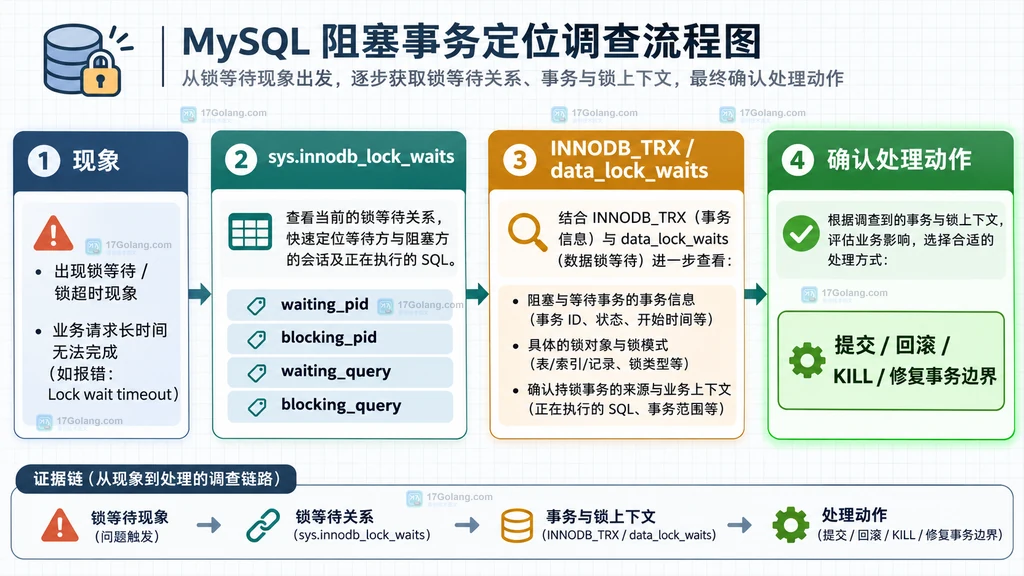
如果实例安装并启用了 MySQL sys schema,优先执行下面这条只读查询。它把等待方和阻塞方放到同一行,适合事故现场快速复制结果。
-- 先按等待时长查看当前仍未解决的 InnoDB 锁等待
SELECT
    wait_started,
    wait_age,
    locked_table_schema,
    locked_table_name,
    locked_index,
    waiting_trx_id,
    waiting_pid,
    waiting_query,
    blocking_trx_id,
    blocking_pid,
    blocking_query,
    sql_kill_blocking_connection
FROM sys.innodb_lock_waits
ORDER BY wait_age_secs DESC;
重点看四组字段:
waiting_pid是正在等锁的连接,waiting_query是等待语句。blocking_pid是持有冲突锁的连接,blocking_query是它当前正在执行的语句。locked_table_schema、locked_table_name、locked_index帮你确认冲突资源。sql_kill_blocking_connection只是生成建议命令,不等于应该立即执行。
如果 blocking_query 是 NULL,不要以为阻塞已经消失。阻塞事务可能已经执行完上一条 SQL,当前处于空闲状态,但事务仍未提交,锁依然由这个连接持有。此时要结合 blocking_pid 和事务表继续查。
第二步:回到 INNODB_TRX 看事务年龄和修改量
阻塞 SQL 为空时,事务上下文比当前语句更有价值。下面的查询把连接 ID、事务状态、开始时间、锁定行数和修改行数列出来。
-- 通过连接 ID 还原事务是否仍然打开,以及它占用了多少事务资源
SELECT
    trx_id,
    trx_mysql_thread_id,
    trx_state,
    trx_started,
    trx_wait_started,
    trx_rows_locked,
    trx_rows_modified,
    trx_query
FROM information_schema.innodb_trx
WHERE trx_mysql_thread_id IN (/* 替换为 waiting_pid 和 blocking_pid */ 123, 456)
ORDER BY trx_started;
判断时可以先问三个问题:
- 阻塞事务的
trx_started是否远早于等待事务?如果是,通常是长事务或连接拿到锁后迟迟没有结束。 trx_rows_modified是否很大?修改量大时,直接终止连接可能带来更长的回滚时间。trx_state是RUNNING、LOCK WAIT还是正在回滚?不同状态决定了是否还值得等待。
这里的 trx_mysql_thread_id 与 SHOW PROCESSLIST 或 KILL 使用的连接 ID 对应。不要把 InnoDB 内部的 trx_id 直接当成连接 ID。
第三步:用 data_lock_waits 还原具体的锁关系
sys.innodb_lock_waits 适合快速定位,但复杂场景还需要知道“等待的锁请求”具体被哪些锁挡住。MySQL 8.4 的 Performance Schema 提供 data_lock_waits 关系表和 data_locks 锁明细表。
-- 用等待关系表连接两侧事务,确认请求锁和阻塞锁属于谁
SELECT
    r.trx_id AS waiting_trx_id,
    r.trx_mysql_thread_id AS waiting_thread,
    r.trx_query AS waiting_query,
    b.trx_id AS blocking_trx_id,
    b.trx_mysql_thread_id AS blocking_thread,
    b.trx_query AS blocking_query
FROM performance_schema.data_lock_waits AS w
JOIN information_schema.innodb_trx AS r
  ON r.trx_id = w.requesting_engine_transaction_id
JOIN information_schema.innodb_trx AS b
  ON b.trx_id = w.blocking_engine_transaction_id;
如果还要看索引、锁类型和记录值,可以把 data_locks 接进来:
-- 两次连接 data_locks,分别查看等待锁和已经持有的阻塞锁
SELECT
    w.requesting_engine_transaction_id AS waiting_trx_id,
    req.object_schema,
    req.object_name,
    req.index_name AS waiting_index,
    req.lock_type AS waiting_lock_type,
    req.lock_mode AS waiting_lock_mode,
    req.lock_data AS waiting_lock_data,
    blk.index_name AS blocking_index,
    blk.lock_type AS blocking_lock_type,
    blk.lock_mode AS blocking_lock_mode,
    blk.lock_data AS blocking_lock_data
FROM performance_schema.data_lock_waits AS w
JOIN performance_schema.data_locks AS req
  ON req.engine_lock_id = w.requesting_engine_lock_id
 AND req.engine = 'INNODB'
JOIN performance_schema.data_locks AS blk
  ON blk.engine_lock_id = w.blocking_engine_lock_id
 AND blk.engine = 'INNODB';
不要依赖 ENGINE_LOCK_ID 的具体字符串格式,它是内部标识;排障时只使用表之间提供的关联关系。还要注意锁表是实时快照,查询完成后等待关系可能已经变化,单次结果不应被当成完整历史。
第四步:确认后再选择处理动作
定位出 blocking_pid 后,处理顺序建议从影响最小的动作开始:
- 如果阻塞连接属于当前发布流程或可控后台任务,优先让应用正常提交或回滚。
- 如果连接处于空闲事务,先联系任务负责人确认,再对该连接执行
KILL CONNECTION。 - 如果修改量很大,预估回滚和重试成本后再终止,不要因为一行
blocking_query为空就直接 KILL。 - 如果每次都在同一业务路径发生,修复事务边界、缩短持锁时间、减少事务内的外部调用,并统一多表访问顺序。
-- 只有在确认连接归属和影响范围后,才执行终止连接动作
KILL CONNECTION 456;
锁等待超时后,默认只回滚触发超时的那条语句;应用层是否重试,要看事务是否仍然有效以及业务是否允许重复执行。若启用了 innodb_rollback_on_timeout,失败处理边界会变成整个事务,重试策略也要随之调整。
为什么把超时时间调大通常不是根治
增大 innodb_lock_wait_timeout 只能让等待方更久才放弃,不能让阻塞事务更快提交。如果根因是连接池借出连接后忘记提交、事务里调用外部服务、批量更新持锁过多,调大参数反而可能让请求堆积得更久。
更稳的改进方式是:
- 事务内先完成必要校验,尽量把网络调用和慢计算移到事务外。
- 批量写入按较小批次提交,避免一次事务修改过多行。
- 让高并发业务以一致的顺序访问多张表或多组资源。
- 在应用日志中记录连接、事务开始、提交、回滚和重试原因,方便把数据库快照与请求链路对应起来。
排查结论可以压缩成这张表
| 要回答的问题 | 先看什么 | 得到什么结论 |
|---|---|---|
| 谁在等,谁在挡 | sys.innodb_lock_waits | 双方连接、SQL、表和等待时长 |
| 阻塞事务是否长期打开 | INNODB_TRX | 事务状态、开始时间、锁行数、修改量 |
| 到底是哪把锁冲突 | data_lock_waits + data_locks | 请求锁、阻塞锁、索引和锁模式 |
| 是否属于 DDL/表结构等待 | metadata_locks | 元数据锁的持有与等待状态 |
常见问题
只有 ERROR 1205,没有查到阻塞事务怎么办?
锁等待可能在你查询前已经结束,也可能实际是元数据锁或快照变化造成的短暂空窗。先保留错误发生时间和连接 ID,再在下一次复现时同时查询 sys.innodb_lock_waits 与 metadata_locks。
blocking_query 为 NULL,说明阻塞连接没问题吗?
不说明。它可能只是当前处于空闲状态,未提交的事务仍然持有锁。继续用 blocking_pid 查 INNODB_TRX 的开始时间和状态。
能不能直接 KILL waiting_pid?
可以终止等待方来快速释放它自己的资源,但这不会解决真正的阻塞源。若阻塞事务仍被保留,后续请求可能继续等待,所以应先确认阻塞方是否是根因。
锁等待超时和死锁需要同样处理吗?
不完全相同。死锁通常会被 InnoDB 立即检测并回滚一个事务;锁等待超时则是等待超过阈值后才返回错误。应用应分别记录错误类型,并按事务完整性设计重试。
总结
定位 MySQL 锁等待超时可以固定成四步:先判断是行锁、死锁还是元数据锁;再用 sys.innodb_lock_waits 找到等待和阻塞双方;然后用 INNODB_TRX、data_lock_waits 和 data_locks 补齐事务与锁对象;最后根据事务年龄、修改量和业务归属决定提交、回滚、KILL 或修复代码。真正的根治点通常是缩短事务持锁时间,而不是单纯调大等待阈值。
 MySQL STR_TO_DATE 怎样处理带时区的日期字符串
- 上一篇
- MySQL STR_TO_DATE 怎样处理带时区的日期字符串
- 下一篇
- Redis HSETNX 怎样避免覆盖已有字段
-
- 数据库 · MySQL | 57分钟前 | MySQL · mysql 时区 STR_TO_DATE 日期时间 CONVERT_TZ
- MySQL STR_TO_DATE 怎样处理带时区的日期字符串
- 117浏览 收藏
-
- 数据库 · MySQL | 1小时前 | MySQL · 数据校验 · mysql IPv6 INET6_ATON INET6_NTOA VARBINARY
- MySQL INET6_ATON 怎样把 IPv6 文本转成二进制
- 207浏览 收藏
-
- 数据库 · MySQL | 1小时前 |
- MySQL JSON_SCHEMA_VALID 怎样校验 JSON 文档
- 331浏览 收藏
-
- 数据库 · MySQL | 1小时前 |
- MySQL DECLARE HANDLER 怎样只处理 NOT FOUND 条件
- 160浏览 收藏
-
- 数据库 · MySQL | 1小时前 |
- MySQL ST_GeomFromText 怎样把 WKT 文本转成空间对象
- 339浏览 收藏
-
- 数据库 · MySQL | 1小时前 |
- MySQL WITH ROLLUP 怎样生成小计和总计
- 107浏览 收藏
-
- 数据库 · MySQL | 1小时前 |
- MySQL REGEXP_LIKE 怎样判断字符串是否匹配正则
- 108浏览 收藏
-
- 数据库 · MySQL | 1小时前 |
- MySQL 派生表为什么阻止索引下推
- 412浏览 收藏
-
- 数据库 · MySQL | 1小时前 |
- MySQL optimizer hint 怎样临时禁止索引合并
- 325浏览 收藏
-
- 数据库 · MySQL | 1小时前 |
- MySQL performance_schema.setup_consumers 怎样开启长语句历史
- 332浏览 收藏
-
- 数据库 · MySQL | 2小时前 |
- MySQL JSON_CONTAINS_PATH 怎样判断 JSON 路径是否存在
- 399浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 851次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 855次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 936次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 910次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 740次使用
-
- MySQL JSON_TABLE 展开数组时如何保留缺失字段
- 2026-09-10 501浏览
-
- MySQL 分区表怎么处理跨分区唯一键:分区列约束与建表取舍
- 2026-08-30 501浏览
-
- MySQL权限管理设置全攻略
- 2026-03-29 501浏览
-
- MySQL分片实现方法及常见方案解析
- 2025-06-24 501浏览
-
- MySQL表空间碎片怎么清理?超详细优化教程
- 2025-06-13 501浏览


