Go bufio.Reader.Reset 怎样复用读取器并替换输入源
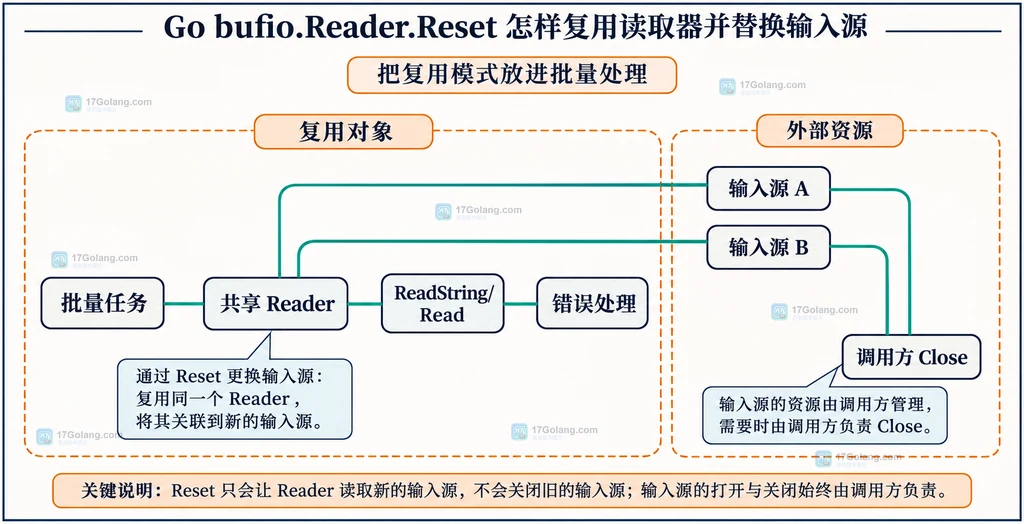
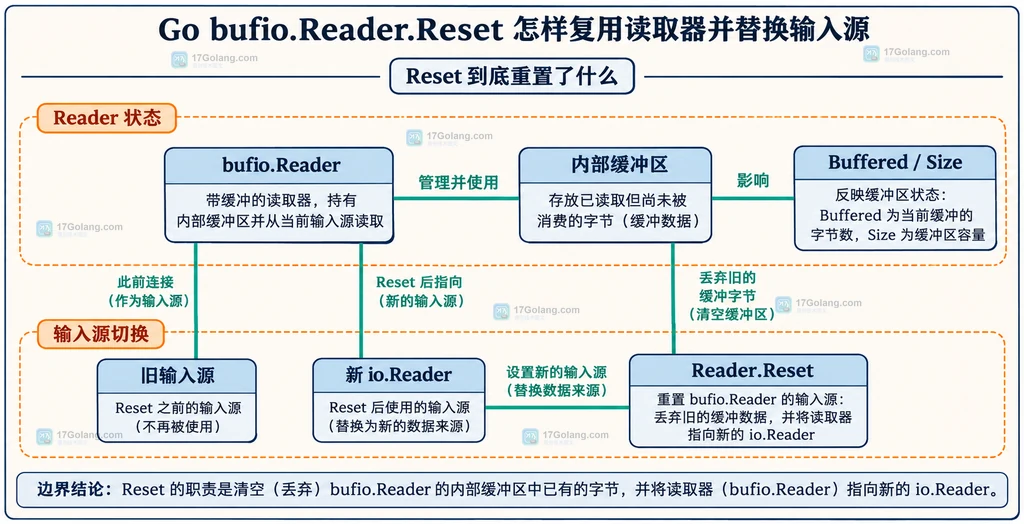
在批量处理多段文本、多个请求体或多份文件时,可以保留一个 bufio.Reader,每次把新的 io.Reader 交给 Reset。它会丢弃旧的缓冲数据、重置读取状态,再从新的输入源开始读取;Reader 自身和已经分配的缓冲区可以继续复用。
官方文档:https://pkg.go.dev/bufio#Reader.Reset
直接记住三个边界:Reset 会清空旧缓冲,不会替你关闭旧文件或连接,也不会把一个 Reader 变成线程安全的共享对象。它只负责切换缓冲读取器的状态和底层输入源。
Reset 到底重置了什么
Reader.Reset(r) 的参数是新的 io.Reader。调用之后,之前通过 Peek、预读或普通读取留在内部缓冲区里的字节都不再属于下一次读取,Buffered() 会回到没有可读旧数据的状态,读取错误和 UnreadByte、UnreadRune 相关状态也会被重置。
它保留的是 Reader 对象本身以及可复用的缓冲容量。可以把 Reader 看成“读取策略和缓冲空间”,把传入的文件、字符串读取器或网络连接看成“本轮数据源”。Reset 改变后者,不负责管理后者的生命周期。
官方源码还给出了两个容易被忽略的细节:对零值 Reader 调用 Reset 会初始化默认大小的内部缓冲区;如果把 Reader 重置为自身,即 r.Reset(r),调用会直接返回,避免递归式包装。
先用一个 Reader 处理多段文本
最容易看出复用价值的场景,是循环处理多段独立输入。下面的函数只创建一个 Reader,之后每轮先 Reset,再读取当前文本。示例没有把上一轮的尾部数据带到下一轮。
package main

import (
    "bufio"
    "io"
    "strings"
)

// readLines 复用同一个 Reader,分别读取每一段独立文本。
func readLines(reader *bufio.Reader, input string) ([]string, error) {
    // Reset 会清空上一轮的缓冲,并把读取源切换到当前字符串。
    reader.Reset(strings.NewReader(input))

    var lines []string
    for {
        line, err := reader.ReadString('\n')
        // 最后一行可以没有换行符,仍要先保留已经读到的内容。
        if len(line) > 0 {
            lines = append(lines, strings.TrimSuffix(line, "\n"))
        }
        if err == io.EOF {
            return lines, nil
        }
        if err != nil {
            return nil, err
        }
    }
}

func main() {
    // 初始输入只用于创建 Reader,后续循环会由 Reset 替换它。
    reader := bufio.NewReaderSize(strings.NewReader(""), 128)
    batches := []string{"alpha\nbeta\n", "gamma\ndelta"}

    for _, batch := range batches {
        lines, err := readLines(reader, batch)
        if err != nil {
            panic(err)
        }
        _ = lines // 实际项目中在这里交给当前批次的处理逻辑。
    }
}
这个模式的重点不是保证某个固定的性能数字,而是让对象生命周期与数据批次解耦。若每轮输入都很短,收益通常只是减少对象创建;若 Reader 的缓冲容量已经适合任务,复用还能避免反复建立同样大小的缓冲。
已有缓冲数据会被直接丢弃
Reset 不是“在当前输入后继续追加新输入”。假设 Reader 已经预读了旧源中的一部分字节,此时调用 Reset,旧源中尚未交给调用方的字节也会被放弃。这个行为正是批次切换需要的隔离边界。
package main

import (
    "bufio"
    "fmt"
    "strings"
)

func main() {
    reader := bufio.NewReader(strings.NewReader("old-rest"))

    // 先消费旧源的一小段,Reader 可能已经在内部预读更多旧字节。
    _, _ = reader.ReadByte()

    // Reset 会丢弃旧源剩余的缓冲数据,不会返回 "ld-rest"。
    reader.Reset(strings.NewReader("new-data"))

    first, err := reader.ReadString('-')
    if err != nil {
        // 这里的 EOF 只属于新输入源,不能和旧源的状态混在一起。
        fmt.Println("读取新源时结束:", err)
    }
    fmt.Println("新源开头:", first)
}
因此,凡是需要把旧输入完整消费完的场景,都应在 Reset 之前完成旧源的读取和错误处理。如果旧数据还没有处理完就切换,丢失是确定行为,而不是偶发的缓存问题。
Reset 不会关闭旧文件或网络连接
这是生产代码里最容易留下资源泄漏的地方。bufio.Reader 只依赖 io.Reader 接口,它不知道底层对象是否实现了 Close,所以 Reset 不可能替调用方完成关闭。文件、请求体或连接的关闭仍应由打开它们的代码负责。
处理多个文件时,可以复用 Reader,但每次打开的文件都要在切换下一份之前关闭。下面的写法把“读取错误”和“关闭错误”都保留下来,避免在循环里使用延迟关闭导致大量文件同时保持打开。
package main

import (
    "bufio"
    "io"
    "os"
)

// consumeLines 只消费当前 Reader,不负责关闭底层文件。
func consumeLines(reader *bufio.Reader) error {
    for {
        _, err := reader.ReadString('\n')
        if err == io.EOF {
            return nil
        }
        if err != nil {
            return err
        }
    }
}

// readFiles 复用 Reader,但把每个文件的关闭责任留在本函数。
func readFiles(paths []string) error {
    // 零值 Reader 也可以先 Reset;这里显式指定容量,便于统一配置。
    reader := bufio.NewReaderSize(nil, 4096)

    for _, path := range paths {
        file, err := os.Open(path)
        if err != nil {
            return err
        }

        // Reset 只切换底层来源,不会替 file.Close。
        reader.Reset(file)
        readErr := consumeLines(reader)
        closeErr := file.Close()

        if readErr != nil {
            return readErr
        }
        if closeErr != nil {
            return closeErr
        }
    }
    return nil
}
上例中用 NewReaderSize(nil, 4096) 只是为了先创建一个容量明确的 Reader;在第一次真正读取前会由循环里的 Reset 换成有效文件。实际项目也可以声明零值 var reader bufio.Reader,然后第一次调用 reader.Reset(file),两种方式都符合官方约定。
四个边界决定是否应该复用
| 场景 | Reset 的影响 | 建议 |
|---|---|---|
| 上一轮还有未处理数据 | 未消费的缓冲字节会被丢弃 | 先完成读取和错误处理,再切换来源 |
| 底层对象是文件或连接 | Reset 不调用 Close | 由打开资源的代码明确关闭 |
| 需要保持缓冲容量 | Reader 和内部缓冲可以继续使用 | 按最长正常输入选择 NewReaderSize |
| 传入同一个 Reader | Reset(reader) 直接不做处理 | 不要把它当作清空状态的方法 |
| 多个 goroutine 同时读写 | Reset 会改变共享 Reader 的状态 | 不要无锁共享,按任务隔离或加外部同步 |
批量任务中的落地清单
- 把 Reader 的创建放在批次循环外,确认缓冲大小符合正常输入,而不是盲目追求更大的容量。
- 每次切换前处理完旧 Reader 的返回值;不要把旧源的尾部数据留给下一批。
- 把文件、HTTP 请求体或连接的 Close 放回资源所有者,不要期待 Reset 自动释放它们。
- 如果需要保留未处理数据,先复制或消费数据,再 Reset;Reset 本身不是暂存操作。
- 并发场景中让每个任务拥有自己的 Reader,或由外部锁保护 Reset 与读取的完整临界区。
常见问题
Reset 后 Reader 的缓冲区容量会不会变小?
通常不会因为切换输入源而缩小。Reset 复用已有缓冲;零值 Reader 第一次 Reset 时才会建立默认大小的缓冲。需要不同容量时,应在创建阶段用 NewReaderSize 选择,而不是把 Reset 当作调节容量的 API。
调用 Reset 前必须先调用 Buffered 或 Discard 吗?
不必须。Reset 的语义本来就是丢弃已有缓冲并重置状态。只有在业务上必须处理旧源剩余数据时,才需要先继续读取或显式 Discard;如果旧批次可以直接放弃,直接 Reset 即可。
Reset 能不能代替关闭文件?
不能。Reset 只接收 io.Reader,不会检查或调用旧对象的 Close。谁打开了文件、连接或请求体,谁就应当在合适的生命周期节点关闭它。
总结
bufio.Reader.Reset 适合把一个读取器对象复用于多段互相独立的输入。它保留 Reader 和缓冲空间,丢弃旧缓冲,清理读取状态并切换到新的 io.Reader。只要把“数据切换”和“资源关闭”分开,把旧数据是否允许丢弃说清楚,就能在批量文本、文件和请求体处理里稳定使用这种模式。
 Go encoding/binary.Decode 怎样把字节切片解析到结构体