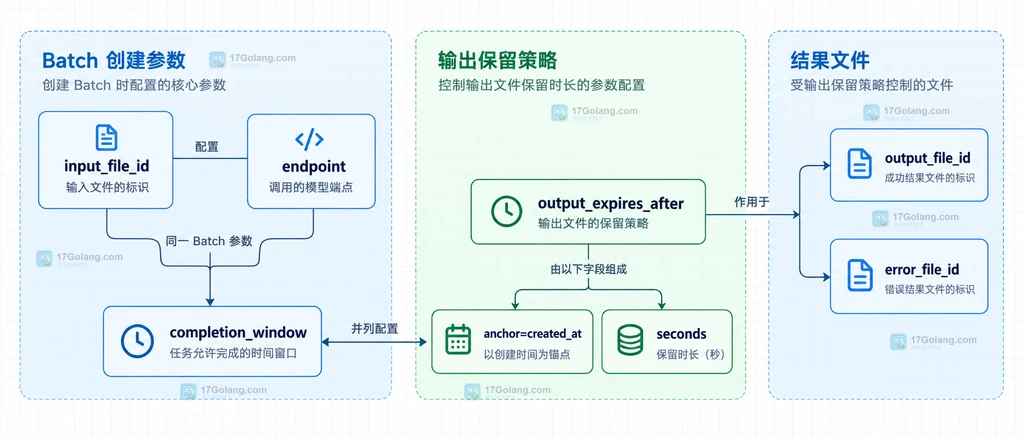
我在把离线分类任务交给 OpenAI Batch API 时,最容易忽略的不是批次什么时候完成,而是结果文件还要保留多久。output_expires_after 就是创建 Batch 时用来约束输出文件和错误文件保留期限的配置。它不改变批次的处理窗口,也不负责让请求更快完成。
官方文档:https://developers.openai.com/api/reference/resources/batches/methods/create
实际配置时,把anchor固定为created_at,再用seconds指定文件从创建时间起保留多少秒;最小 3600 秒,最大 2592000 秒。处理完成后,再通过 Batch 返回的文件 ID读取结果。
output_expires_after 到底控制什么
这个对象控制 Batch 生成的输出文件和错误文件何时过期。官方 API 参考目前支持的结构是:
{
  "output_expires_after": {
    "anchor": "created_at",
    "seconds": 604800
  }
}
上面的 604800 是 7 天。需要注意三个边界:
anchor目前使用created_at,指的是文件创建时间,不是 Batch 对象创建时间。seconds必须是整数,范围是 3600 秒到 2592000 秒,也就是 1 小时到 30 天。- 它只约束输出文件和错误文件,不会替你清理输入文件,也不会改变批次的
completion_window。
创建 Batch 时怎样填写保留期限
我更建议在创建 Batch 的位置一次性写清楚保留策略,而不是等任务完成后再凭经验判断。下面示例使用 Python SDK,输入文件和模型请求内容仍由你自己的 JSONL 文件提供:
import os
from openai import OpenAI

# 使用环境变量读取密钥,示例中不把凭据写进代码。
client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])

# 创建批次,并让输出文件从文件创建时间起保留 7 天。
batch = client.batches.create(
    input_file_id="file-batch-input",
    endpoint="/v1/responses",
    completion_window="24h",
    output_expires_after={
        "anchor": "created_at",
        "seconds": 7 * 24 * 60 * 60,
    },
)

# 保存 Batch ID,后续用它查询状态和 output_file_id。
print(batch.id)
这里的 completion_window 和 output_expires_after.seconds 是两件事:前者描述批次处理时限,后者描述结果文件的保存时限。为了让代码更容易维护,我会把保留天数先换算成秒,并在配置旁写清楚用途。
如果使用原始 HTTP 请求,JSON 结构保持一致;严格 JSON 不能写注释,所以把字段解释放在正文中,不要为了注释破坏请求体格式。
批次完成后,什么时候读取结果文件
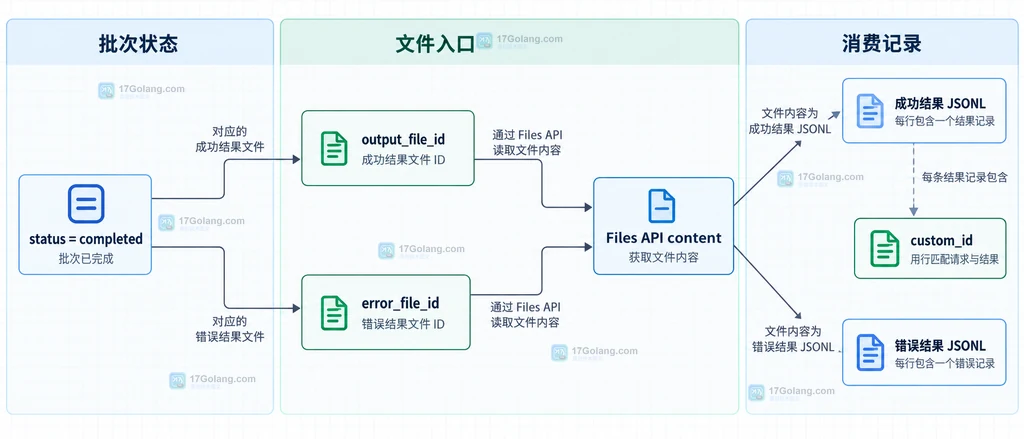
创建 Batch 后先查询状态。只有进入 completed,才按返回的 output_file_id 读取成功结果;存在失败请求时,再根据 error_file_id 读取错误文件。官方指南还提醒,结果行的顺序不保证和输入顺序一致,业务关联应使用每行的 custom_id。
from openai import OpenAI

client = OpenAI()
batch = client.batches.retrieve("batch_abc123")

# 只有批次完成后,输出文件才适合进入下载处理。
if batch.status == "completed" and batch.output_file_id:
    output = client.files.content(batch.output_file_id)
    with open("batch-output.jsonl", "wb") as target:
        # 读取二进制内容并关闭本地文件句柄。
        target.write(output.read())

# 错误文件单独处理,不把失败行误当成成功输出。
if batch.error_file_id:
    errors = client.files.content(batch.error_file_id)
    with open("batch-errors.jsonl", "wb") as target:
        target.write(errors.read())
上面的判断是消费端的基本保护。真正落地时还应把 batch.id、output_file_id、error_file_id 和读取时间写入自己的任务记录;这样即使文件被清理,也能知道当时应该读取哪个对象。
seconds 应该设置多长
官方范围只是合法边界,具体值要看下游什么时候消费文件。我通常按下面的思路选:
| 场景 | 建议思路 | 原因 |
|---|---|---|
| 临时实验或一次性评估 | 接近 1 小时至 1 天 | 消费窗口短,减少无意义的文件留存 |
| 日常离线任务 | 约 3 天至 7 天 | 给重跑、人工抽查和下游补取留出时间 |
| 需要跨周留档的结果 | 接近 30 天 | 覆盖较长的业务复核周期,但仍要同步到自己的存储 |
这些是工程取舍,不是服务端保证。若结果需要长期保存,不应把 Batch 输出文件当作归档系统:在文件仍可读取时复制到自己的存储,并保留 custom_id 与任务元数据。
最容易踩到的几个误区
把它当成批次超时配置
不对。批次是否过期由 Batch 的处理窗口和状态决定;output_expires_after 只影响结果文件和错误文件。批次过期时,已经完成的请求仍可能出现在输出文件中,未完成请求会进入错误信息。
把 anchor 写成 batch_created_at
不要自造锚点名称。当前 API 参考支持的是 created_at,并且解释为文件创建时间。
设置成 0 或超过 30 天
这会越过官方参数范围。用秒数计算时,先确认结果是整数,再把它限制在 3600 到 2592000 之间。
只保存 output_file_id,不保存 error_file_id
批处理结果并不等于所有请求都成功。成功文件和错误文件应分开记录,否则后续只能看到部分结果,却无法解释缺失的请求。
结语
如果你的目标是控制 OpenAI Batch API 生成文件的保留时间,最小配置就是 output_expires_after.anchor="created_at" 加上合法的 seconds。我会把短期结果设置为几小时到几天,把需要复核的结果先复制到自己的存储,再让 Batch 文件按策略过期。这样既能控制临时文件生命周期,也不会把批处理结果的长期保存责任误交给 API 文件对象。
相关问题
- Batch API 的 output_file_id 和 error_file_id 可以同时存在吗?可以分别存在,成功行和失败行应按不同文件处理。
- output_expires_after 会影响输入文件吗?不会,本文参数针对 Batch 生成的输出文件和错误文件。
- 结果文件行顺序和输入文件一致吗?不应依赖顺序,应使用每行的 custom_id 做对应。
 DBeaver 怎样配置结果集分页避免一次加载过多数据