Go 的 runtime/trace.Logf 用来向执行追踪写入一条带格式化参数的一次性消息。它适合记录“某个请求处理到了哪个阶段”“本次任务关联了哪个业务编号”这类事件;如果要表示一段持续时间,应使用区域标记 API,而不是把开始和结束文本硬拼在一起。
官方文档:https://pkg.go.dev/runtime/trace#Logf
最小可靠用法是:先用trace.Start开启输出,把包含任务信息的context.Context传到业务函数,再调用trace.Logf(ctx, category, format, args...)写消息,最后确保文件和追踪都通过defer关闭。Logf只记录事件,不负责计算耗时。
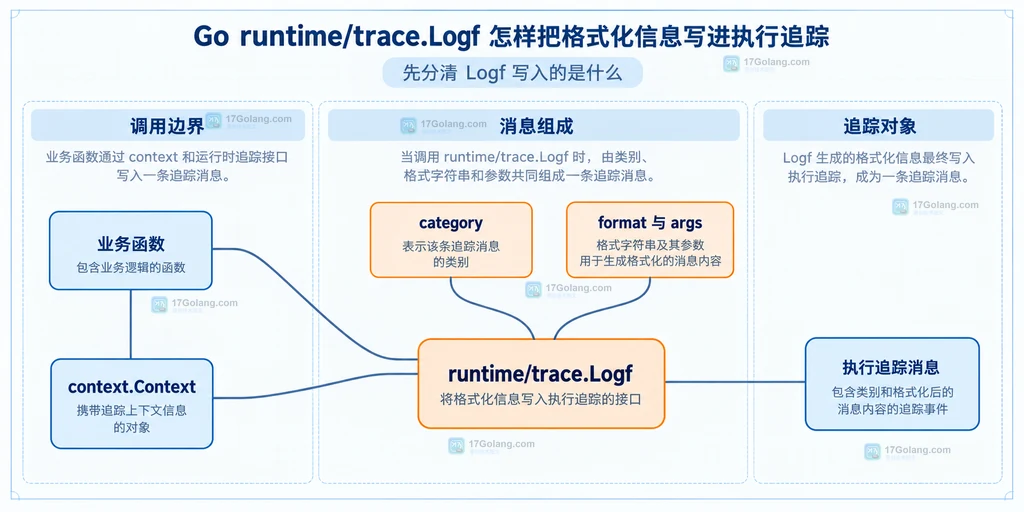
先分清 Logf 写入的是什么
Logf 的签名是 Logf(ctx context.Context, category, format string, args ...any)。ctx 决定消息是否能附着到当前任务,category 是追踪工具中用于筛选和归类的短标签,format 与 args 则负责生成消息文本。
因此,下面这条调用表达的是“一次订单处理事件带着当前阶段和订单号写入追踪”,而不是“从这里开始计时”:消息本身没有自动的结束点,也不会替代区域或任务的生命周期。
建立一个最小追踪输出
要让消息进入追踪,程序必须处于追踪状态。下面的骨架只负责创建输出文件、启动追踪、执行一个业务函数并在返回时清理资源。示例没有把本地运行结果当作文章证据,重点是 API 的职责关系。
package main

import (
	"context"
	"log"
	"os"
	"runtime/trace"
)

func main() {
	// 创建追踪输出文件;真实项目可把路径交给配置管理。
	f, err := os.Create("trace.out")
	if err != nil {
		log.Fatalf("创建追踪文件失败: %v", err)
	}
	defer func() {
		// 关闭文件时仍检查错误,避免静默丢失尾部写入。
		if err := f.Close(); err != nil {
			log.Printf("关闭追踪文件失败: %v", err)
		}
	}()

	if err := trace.Start(f); err != nil {
		log.Fatalf("启动追踪失败: %v", err)
	}
	defer trace.Stop() // Stop 会等待追踪数据写完。

	ctx := context.Background()
	processOrder(ctx, 1001)
}

func processOrder(ctx context.Context, orderID int) {
	// 这里只演示业务入口,具体消息写入放在下一节。
	_ = orderID
}
trace.Start 重复启动会返回错误,trace.Stop 会等待当前追踪写入完成。文件关闭放在 trace.Stop 之后执行,是为了让追踪器先完成写入,再释放底层文件描述符。
用上下文写入格式化消息
有了追踪生命周期后,把 Logf 放到业务代码里即可。格式化消息适合把少量、能直接帮助定位的值拼进事件,例如订单号、阶段名和重试次数;分类则保持为少数稳定值,便于在追踪工具中筛选。
func processOrder(ctx context.Context, orderID int) {
	phase := "reserve"
	retry := 0

	// category 用稳定短名,format 只描述一次性事件及其参数。
	trace.Logf(ctx, "order", "order_id=%d phase=%s retry=%d", orderID, phase, retry)

	// 业务继续执行;下面的消息仍应使用同一个任务上下文。
	phase = "commit"
	trace.Logf(ctx, "order", "order_id=%d phase=%s retry=%d", orderID, phase, retry)
}
如果业务上已经有任务上下文,应把它一路传入,而不是在深层函数里重新创建一个无关的 context.Background()。这样消息才有机会和同一任务关联起来。Logf 的格式语法遵循 fmt.Sprintf 的习惯,但不要把大对象、密钥或完整请求体塞进追踪消息。
Logf、Log 和 WithRegion 怎么选
三个 API 解决的是不同问题。Log 适合已经准备好完整字符串的一次性事件;Logf 适合需要把参数格式化后再写入的事件;WithRegion 则描述同一个 goroutine 中一段有开始和结束边界的执行区间。
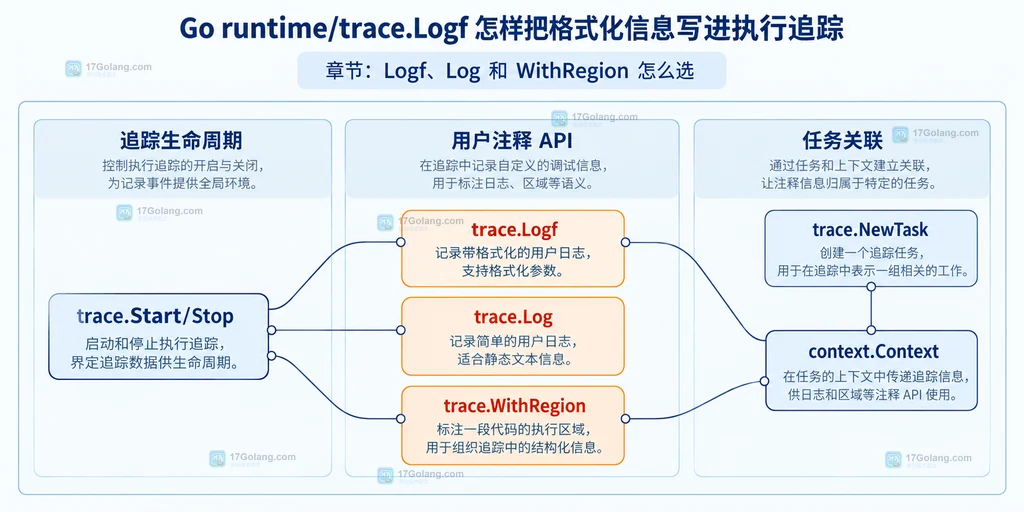
| 需求 | 优先 API | 判断依据 |
|---|---|---|
| 参数需要格式化成一条事件 | trace.Logf | 有 format 和 args,消息没有自动结束点 |
| 已经有完整文本 | trace.Log | 直接写 category 与 message |
| 观察一段函数执行时间 | trace.WithRegion | 由函数边界结束区域,适合嵌套阶段 |
| 跨多个 goroutine 关联一次逻辑操作 | trace.NewTask | 用返回的 context 传递任务关系 |
常见误区是连续写两条“开始”和“结束”消息,然后把两条消息之间的时间当成区域耗时。这样做只能提供两个事件,不能让追踪工具把它们识别为一个有持续时间的区域;如果需要耗时语义,应直接使用区域 API。
控制开销与上下文边界
trace.IsEnabled() 可以告诉调用方当前是否启用了追踪,但官方文档明确它只是提示,状态可能在返回后变化。因此,不要把它当作正确性条件,也不要围绕它构造必须执行的业务分支。
func recordCacheLookup(ctx context.Context, key string, hit bool) {
	// 只记录低成本、可脱敏的字段;不要把用户输入全文写进追踪。
	trace.Logf(ctx, "cache", "key=%s hit=%t", key, hit)
}

func submitWorkers(ctx context.Context, jobs []int) {
	for _, jobID := range jobs {
		id := jobID // 为 goroutine 固定本轮任务值,避免闭包读取变化中的循环变量。
		go func() {
			// goroutine 继承的是显式传入的 ctx,不会自动继承调用方局部变量。
			trace.Logf(ctx, "worker", "job_id=%d", id)
		}()
	}
}
在高频循环中,消息数量本身可能成为追踪负担。更稳妥的做法是只记录能区分故障路径的关键节点,限制分类数量,并对可能包含隐私或高基数内容的字段做脱敏或截断。跨 goroutine 时要明确传递同一个任务上下文;如果只需要表达一个局部阶段,就不要为了“看起来完整”额外建立全局任务。
常见问题
Logf 的 category 可以每次都动态生成吗?
不建议。category 的用途是归类和筛选,保持少量稳定值比把用户 ID、路径或请求参数拼进去更容易阅读,也能避免高基数消息污染追踪。
没有开启 trace.Start 时调用 Logf 会怎样?
调用仍可以保留在业务代码中,但不会得到有效的执行追踪输出。不要依赖 Logf 改变业务结果;是否记录只属于观测层行为。
Logf 能替代日志系统吗?
不能。它服务于 Go execution trace 的关联和分析,不是长期日志存储、检索或审计系统。需要持久化业务日志时,仍应使用专门的日志方案。
为什么要把 context 传到最深处?
因为消息和任务的关联依赖调用时传入的 context。深层函数如果重新使用无关上下文,消息就失去原有任务的关联信息。
总结
runtime/trace.Logf 的核心是“把格式化的一次性消息写入当前执行追踪”:稳定的 category 负责归类,format 与 args 负责表达有限的诊断信息,context 负责保留任务关系。先正确管理 trace.Start/trace.Stop,再按消息、区域、任务三种语义选择 API,文章中的示例就能保持清晰、低耦合和可维护。
 Go runtime/debug.SetMaxThreads 怎样限制操作系统线程数量