
Go crypto/ecdh X25519 公钥为什么固定为 32 字节
接入 ECDH 协议时,如果对端约定的是 X25519,公钥字段通常就应该是固定的 32 字节。这个长度不是 Go 临时规定的,也不是把一条椭圆曲线公钥“截短”后的结果:X25519 使用的是 Curve25519 上的 Montgomery u 坐标,标准编码直接保存一个 32 字节的坐标值。
因此,crypto/ecdh 的正确做法是先根据协议确定曲线,再把对应编码交给该曲线的 NewPublicKey。不要把 P-256 的未压缩点、PEM 文本或带曲线标识的 DER 数据直接当成 X25519 的 32 字节输入。
官方文档:https://pkg.go.dev/crypto/ecdh
先回答:为什么正好是 32 字节
X25519 的公钥是一个有限域元素的标准字节编码,长度为 32 字节,也就是 256 bit。这里的“公钥”更接近一个经过约定编码的 u 坐标,而不是 NIST 曲线常见的 0x04 + X + Y 点格式。
Go 文档对 ecdh.X25519().NewPublicKey 的约束也很直接:X25519 只检查传入的 u 坐标长度;长度不对时无法构造对应的 PublicKey。这就是为什么协议层必须保留曲线字段或上下文,不能只传一段“看起来像公钥”的字节。
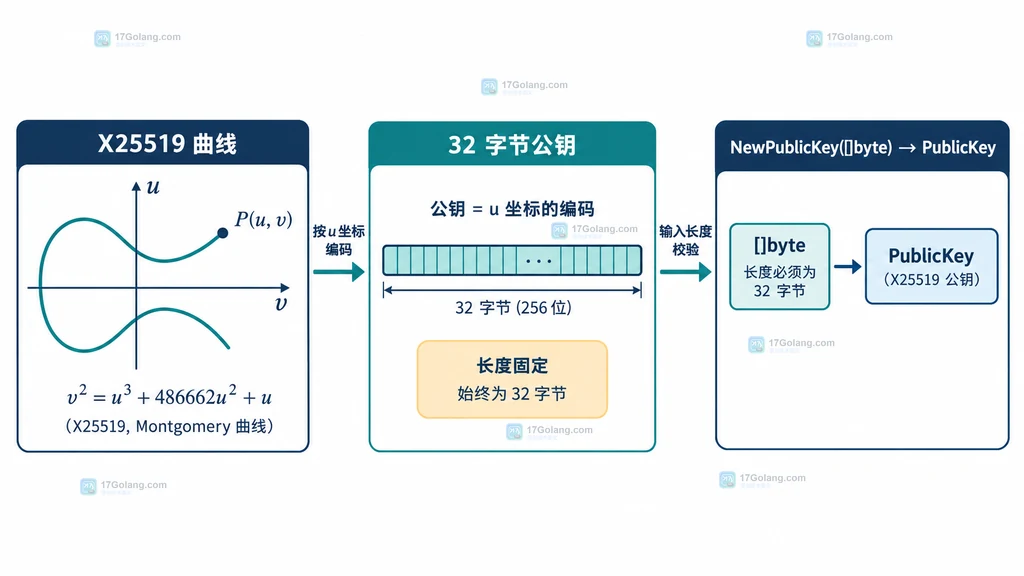
用 NewPublicKey 接收对端的 32 字节公钥
实际接收网络字段时,先复制或切片出公钥字段,再调用 X25519 曲线的 NewPublicKey。示例只演示导入边界,不生成真实密钥,也不把示例数组当成可用的生产密钥。
package main

import (
    "crypto/ecdh"
    "fmt"
)

func parseX25519PublicKey(encoded []byte) (*ecdh.PublicKey, error) {
    // X25519 的公钥编码固定为 32 字节,先在协议边界给出清晰错误。
    if len(encoded) != 32 {
        return nil, fmt.Errorf("X25519 public key length = %d, want 32", len(encoded))
    }

    // NewPublicKey 负责按 X25519 曲线解释 u 坐标并构造不透明公钥对象。
    return ecdh.X25519().NewPublicKey(encoded)
}

func main() {
    wireKey := make([]byte, 32) // 示例占位数据,不代表真实公钥。
    key, err := parseX25519PublicKey(wireKey)
    if err != nil {
        // 解析失败时不要继续进入 ECDH,避免把错误字节当成密钥使用。
        fmt.Println("invalid peer key:", err)
        return
    }
    fmt.Println("peer key bytes:", len(key.Bytes()))
}
这里的长度判断属于协议层的快速失败;即使不写这层判断,NewPublicKey 仍然会检查 X25519 的输入长度。保留显式判断的好处是能把“字段截断”“曲线选错”和“编码损坏”更早地区分出来。
公钥导出和导入为什么能互相对应
PublicKey.Bytes() 返回的是当前公钥编码的一份副本。对同一条 X25519 曲线来说,导出的结果可以作为另一端 NewPublicKey 的输入;但这只说明字节格式对应,并不意味着任何 32 字节数据都能完成有效的密钥交换。
完成 ECDH 时,私钥和对端公钥必须属于同一条曲线。一个常见的工程边界是:协议消息中除了公钥字节,还要能确定算法或曲线,例如把曲线枚举放在字段头里;解析端根据枚举选择 ecdh.X25519(),而不是根据长度猜测曲线。
func exchangeX25519(local *ecdh.PrivateKey, peerBytes []byte) ([]byte, error) {
    // 先按本协议约定的 X25519 格式导入对端公钥。
    peer, err := ecdh.X25519().NewPublicKey(peerBytes)
    if err != nil {
        return nil, fmt.Errorf("parse peer X25519 key: %w", err)
    }

    // ECDH 只接受同曲线的密钥;返回值是共享秘密的原始字节。
    secret, err := local.ECDH(peer)
    if err != nil {
        return nil, fmt.Errorf("compute X25519 shared secret: %w", err)
    }
    return secret, nil
}
共享秘密通常还要进入协议规定的 KDF 或密钥派生步骤,不能直接当作长期对称密钥保存。本文关注的是公钥字节边界,派生算法应由具体协议另行定义。
不要把 X25519 和 P-256 的公钥字节混用
X25519 和 P-256 都能用于 ECDH,但公钥编码不同。X25519 的公开值是固定 32 字节;P-256 的 SEC 1 未压缩点通常由一个前缀字节 0x04 加上两个固定宽度坐标组成,因此常见长度是 65 字节。
这也是“长度校验通过但仍然失败”的典型来源:一段 32 字节数据可能被错误地送到 P-256,或者把 65 字节的 P-256 点送到 X25519。正确的解析顺序应当是先读取曲线标识,再选择曲线,再执行该曲线自己的公钥解析。
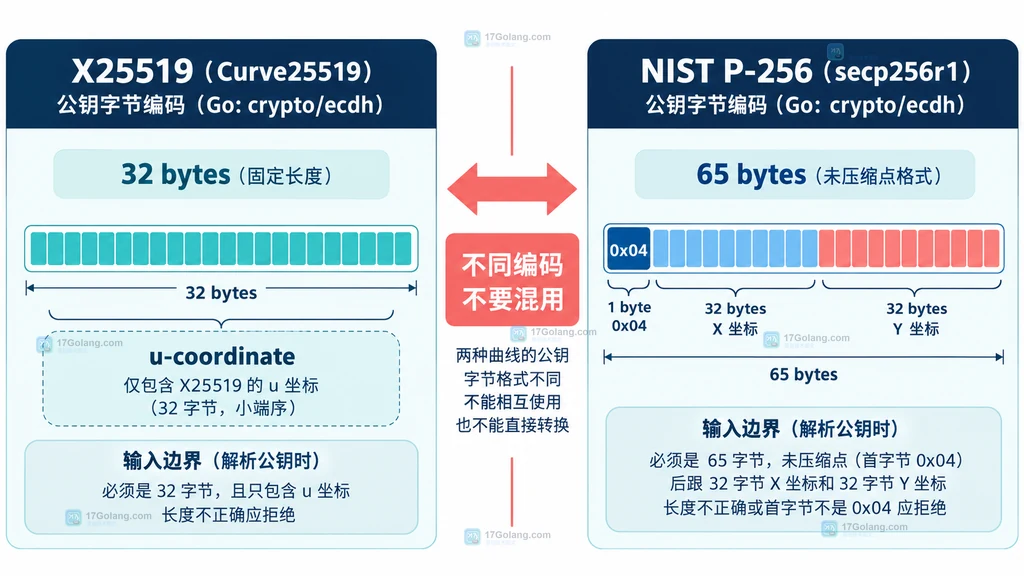
| 项目 | X25519 | P-256 未压缩点 |
|---|---|---|
| Go 曲线入口 | ecdh.X25519() | ecdh.P256() |
| 公钥含义 | u 坐标编码 | 椭圆曲线点的 X、Y 坐标 |
| 常见公钥字节数 | 32 | 65,含 0x04 前缀 |
| 解析方式 | 按 X25519 长度解释 | 按 SEC 1 未压缩点格式解释 |
工程接入时的五个检查点
- 先定曲线:协议字段或握手上下文明确写出 X25519、P-256 等算法标识。
- 再定编码:文档写清楚是裸公钥字节、DER、PEM,还是带自定义头部的二进制字段。
- 边界校验:对 X25519 预期 32 字节,对 P-256 按所选 SEC 1 编码规则处理,不根据模糊经验猜长度。
- 错误分层:长度错误、曲线不匹配和 ECDH 计算错误分别记录上下文,避免只返回一个“密钥无效”。
- 秘密派生:ECDH 返回的共享秘密交给约定的 KDF,不在日志、错误信息或持久化字段中输出。
常见问题
32 字节的 X25519 公钥可以直接 Base64 解码后使用吗?
可以,但前提是 Base64 解码后得到的正是协议约定的裸 X25519 公钥字节;调用 NewPublicKey 前仍要处理解码失败和长度不为 32 的情况。
为什么不能只根据公钥长度判断算法?
长度只能作为局部格式检查,不能承担算法协商。协议扩展、封装方式或未来新增曲线都可能让“猜算法”变成兼容性和安全边界问题。
NewPublicKey 成功就代表 ECDH 一定成功吗?
不代表。X25519 的公钥导入和实际 ECDH 计算是两个阶段;计算时还会受到私钥曲线是否匹配以及对端公钥是否导致无效共享结果等因素影响。
记住一句话:X25519 的 32 字节是它的公钥编码规则,不是所有椭圆曲线公钥的通用长度。先确认曲线和封装,再让对应的 NewPublicKey 解析。  Go weak.Pointer 怎样在缓存中实现可失效引用
- 上一篇
- Go weak.Pointer 怎样在缓存中实现可失效引用
- 下一篇
- Go binary.PutUvarint 怎样把整数写入固定字节缓冲区
-
- Golang · Go教程 | 31分钟前 |
- Go filepath.IsAbs 怎样判断用户输入是否为绝对路径
- 322浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go binary.PutUvarint 怎样把整数写入固定字节缓冲区
- 137浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go weak.Pointer 怎样在缓存中实现可失效引用
- 350浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go io.SectionReader 怎样读取文件片段而不移动共享偏移量
- 306浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go unique.Handle 怎样复用重复值并减少内存
- 257浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go iter.Seq 怎样把回调式数据暴露为迭代器
- 407浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go compress/zlib.NewReader 怎样读取压缩数据流
- 191浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go maps.Keys 怎样遍历映射键并保持可排序结果
- 190浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go database/sql.RawBytes 怎样避免复制查询结果
- 112浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go slices.Values 怎样把切片转换为迭代器
- 249浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go bytes.Lines 怎样按行读取字节序列
- 274浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 828次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 825次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 909次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 883次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 705次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览


