先说结论:text/scanner.Scanner.IsIdentRune 是一个按位置判断字符的回调。用它可以把默认 Go 标识符规则改成适合配置文件或轻量 DSL 的规则,例如允许 % 作为首字符,再让后续位置接受字母和数字。关键是把 i == 0 和 i > 0 分开处理,并且不要让标识符字符与空白字符重叠。
官方文档:https://pkg.go.dev/text/scanner#Scanner.IsIdentRune
IsIdentRune 到底控制什么
IsIdentRune 的签名是 func(ch rune, i int) bool。ch 是扫描器当前看到的 rune,i 是它在当前标识符中的位置,从零开始。返回 true,当前字符才会继续并入这个标识符;返回 false,当前标识符在这里结束,扫描器再按其它 token 规则处理当前字符。
当回调为 nil 时,text/scanner 使用常规 Go 标识符规则。自定义回调只负责词法层面的“这个字符能不能属于当前标识符”,它不知道完整表达式、字段类型或括号配对,因此不能替代语法解析器。
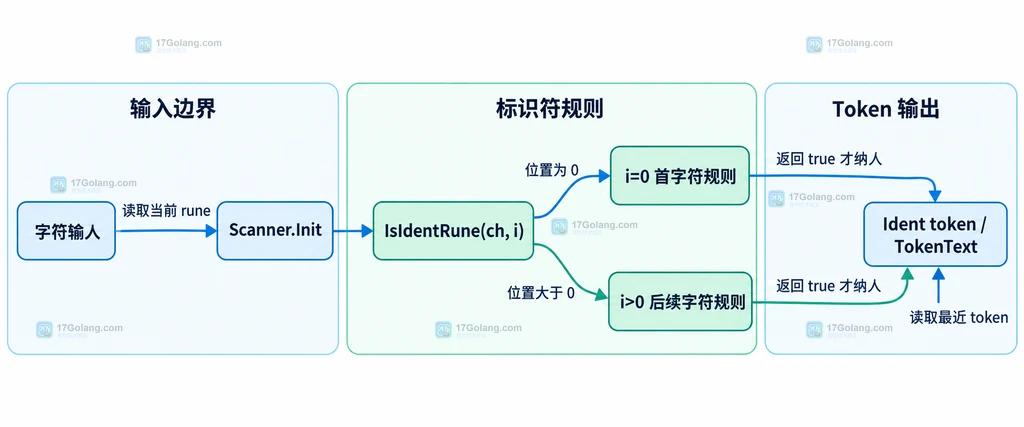
先看默认规则为什么会拆开特殊前缀
假设配置语言把变量写成 %var1。默认规则通常不会把百分号当作 Go 标识符的首字符,于是扫描结果会把它和后面的 var1 分开。此时可以只扩展标识符首字符,不改变后续字符规则:
package main

import (
	"fmt"
	"strings"
	"text/scanner"
	"unicode"
)

func main() {
	const source = "%var1 var2"
	var s scanner.Scanner
	s.Init(strings.NewReader(source))
	s.IsIdentRune = func(ch rune, i int) bool {
		if i == 0 {
			// 首字符允许百分号或 Unicode 字母。
			return ch == '%' || unicode.IsLetter(ch)
		}
		// 后续位置不再接受新的百分号,但接受字母和数字。
		return unicode.IsLetter(ch) || unicode.IsDigit(ch)
	}

	for tok := s.Scan(); tok != scanner.EOF; tok = s.Scan() {
		// TokenText 返回最近一次 Scan 得到的原始 token 文本。
		fmt.Printf("%s: %q\n", scanner.TokenString(tok), s.TokenText())
	}
}
这段代码的重点不是把所有语言规则都塞进回调,而是把边界说清楚:百分号只能出现在位置 0,后面的字符按另一套集合判断。这样 %var1 会作为一个标识符读取,而空格仍然是 token 之间的分隔。
用 i == 0 区分首字符和后续字符
很多 DSL 的标识符规则都可以拆成两部分:首字符决定“能不能开始”,后续字符决定“能不能继续”。例如允许 _、% 或字母开头,后续再允许数字和连字符:
func isDSLIdentRune(ch rune, i int) bool {
	if i == 0 {
		// 首字符负责建立一个新的标识符。
		return ch == '_' || ch == '%' || unicode.IsLetter(ch)
	}
	// 后续字符可以扩展名称,但不再接受新的百分号。
	return ch == '-' || ch == '_' || unicode.IsLetter(ch) || unicode.IsDigit(ch)
}
这里的 i 是标识符内的 rune 位置,不是字节偏移。中文字符、带重音字符等 UTF-8 内容都可能占用多个字节,但在回调里仍然按 rune 计数。若业务需要字节位置,应查看扫描器的位置信息,而不是把 i 当成字节下标。
回调也不会提前知道整个词的内容。它只拿到当前字符和当前位置,所以“首字符可以是百分号,但第二个字符不能是百分号”这种规则适合放在这里;“名称必须以某个后缀结尾”则应该留给后续业务校验。
空白集合不能和标识符字符重叠
Scanner 还会根据 Whitespace 判断哪些字符可以跳过。标识符规则与空白规则必须保持互斥:如果把空格、制表符或换行同时当作标识符字符,扫描边界就会变得不可预测。
func newScanner(src io.Reader) *scanner.Scanner {
	s := new(scanner.Scanner)
	s.Init(src)
	s.IsIdentRune = func(ch rune, i int) bool {
		if unicode.IsSpace(ch) {
			// 空白交给 Whitespace,不能吞进标识符。
			return false
		}
		if i == 0 {
			// 首字符允许下划线和 Unicode 字母。
			return ch == '_' || unicode.IsLetter(ch)
		}
		// 后续位置增加数字,但仍保持空白边界。
		return ch == '_' || unicode.IsLetter(ch) || unicode.IsDigit(ch)
	}
	return s
}
如果使用这段完整函数,需要补上 io、text/scanner 和 unicode 的导入。默认的 Whitespace 已经覆盖常见 Go 空白;只有配置语言确实需要不同的空白集合时,才在 Init 之后显式调整它。
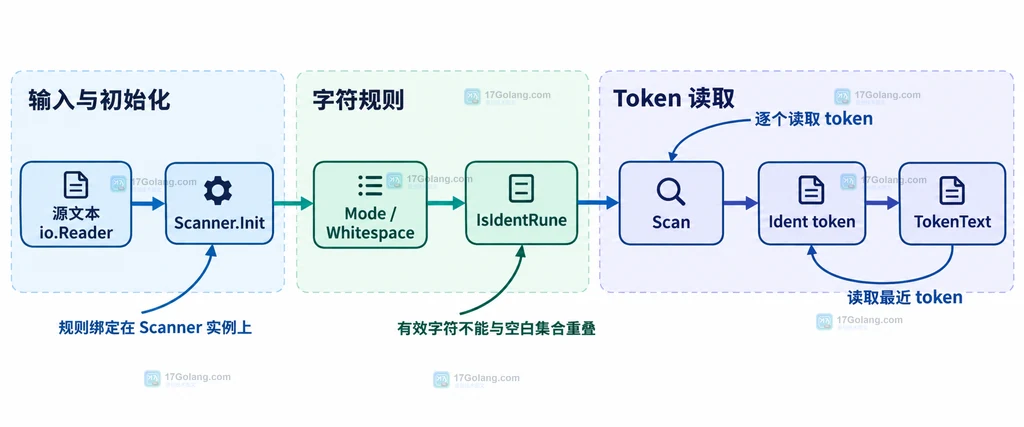
Init、Scan 和 TokenText 的使用边界
一个稳定的扫描流程通常是:创建或复用 Scanner,调用 Init,配置字符规则,然后反复调用 Scan。每次 Scan 返回后,TokenText 只对应最近一个 token;如果要保存文本,应在下一次 Scan 之前复制或处理它。
func scanWords(src io.Reader) []string {
	var s scanner.Scanner
	s.Init(src)
	s.IsIdentRune = isDSLIdentRune
	var words []string
	for tok := s.Scan(); tok != scanner.EOF; tok = s.Scan() {
		if tok == scanner.Ident {
			// 立即复制最近 token,避免下一次 Scan 改变观察对象。
			words = append(words, s.TokenText())
		}
	}
	return words
}
如果只想读取标识符,可以检查返回的 token 类型;如果还要判断赋值、括号或运算符,就需要在扫描结果之上建立语法层。把所有判断继续堆进 IsIdentRune,会让词法回调承担超出它边界的职责。
几个容易混淆的边界
| 问题 | 应该检查什么 | 建议 |
|---|---|---|
| 首字符和后续字符不同 | i == 0 与 i > 0 | 分成两个清晰的字符集合 |
| 数字是否能开头 | DSL 的词法约定 | 若数字会被识别为数字 token,就不要随意把它放进首字符集合 |
| 空格是否被吞掉 | Whitespace 与回调的交集 | 让空白只由空白规则处理 |
Init 后规则失效 | 配置顺序 | 先 Init,再设置 IsIdentRune 和其它字段 |
| 需要校验完整表达式 | 是否涉及结构、类型和运算关系 | 保留 Scanner 做词法层,另写 parser |
适合落地的封装方式
如果多个入口都要使用同一套标识符规则,可以集中封装 Scanner 的创建过程。这样调用方不会忘记设置回调,也能在一个地方记录规则变更:
func NewDSLScanner(src io.Reader) *scanner.Scanner {
	s := new(scanner.Scanner)
	s.Init(src)
	s.Filename = "dsl-input"
	s.IsIdentRune = isDSLIdentRune
	return s
}
封装函数只负责初始化和词法规则,不负责读取全部输入或解释业务语义。测试时可以用 strings.NewReader 构造小输入,分别覆盖首字符、后续字符、空白、非 ASCII 字母和结束 token。
常见问题
IsIdentRune 的 i 是字节下标吗?
不是。它表示当前 rune 在标识符中的位置,从 0 开始。UTF-8 字节偏移属于扫描位置的另一类信息。
回调返回 false 会丢掉当前字符吗?
不会简单地丢弃。它表示当前标识符在这里结束,扫描器会根据其它 token 规则继续处理当前字符。真正的结果取决于这个字符是否能形成其它 token。
可以把空格也放进标识符吗?
不建议。空白字符由 Whitespace 控制,和标识符字符重叠会破坏 token 边界。需要带空格的业务名称时,通常应设计成字符串 token。
IsIdentRune 能替代完整 parser 吗?
不能。它适合回答“当前字符能否属于这个标识符”,不负责表达式结构、字段类型、括号配对或语义校验。
总结
IsIdentRune 的实用价值在于把标识符边界从默认 Go 规则扩展到自己的 DSL。记住三个动作即可:用 i == 0 处理首字符,用 i > 0 处理后续字符,让它与 Whitespace 保持互斥。完成词法切分后,再把完整语法和业务校验交给更高一层。
 Go json.MarshalerError.Unwrap 保留底层编码错误的处理方案