
Go bitset 怎样对两组标记计算对称差
两组标记要找“只属于其中一组”的编号时,不需要自己逐字做异或。github.com/bits-and-blooms/bitset 已经提供了 SymmetricDifference:它返回一个新 BitSet,结果中只保留 A 或 B 设置、但没有同时设置的位。如果允许修改其中一组,则可用 InPlaceSymmetricDifference 直接复用接收者。
官方地址:https://pkg.go.dev/github.com/bits-and-blooms/bitset
- 对称差等价于“并集减去交集”,相同编号在两组中都出现时会被排除。
SymmetricDifference生成新集合;InPlaceSymmetricDifference会改写接收者。- 编号越大,BitSet 的长度上界越大;如果数据极其稀疏,应重新评估普通 bitset 是否合适。
先把“对称差”与普通差集分开
假设 A 表示本次活动用户,B 表示上次活动用户。A 是 1、3、5、8,B 是 3、4、8、10。普通差集 A-B 只会得到 1、5;对称差则要把两边独有的编号都留下,因此结果是 1、4、5、10。编号 3 和 8 同时存在于两组,必须被排除。
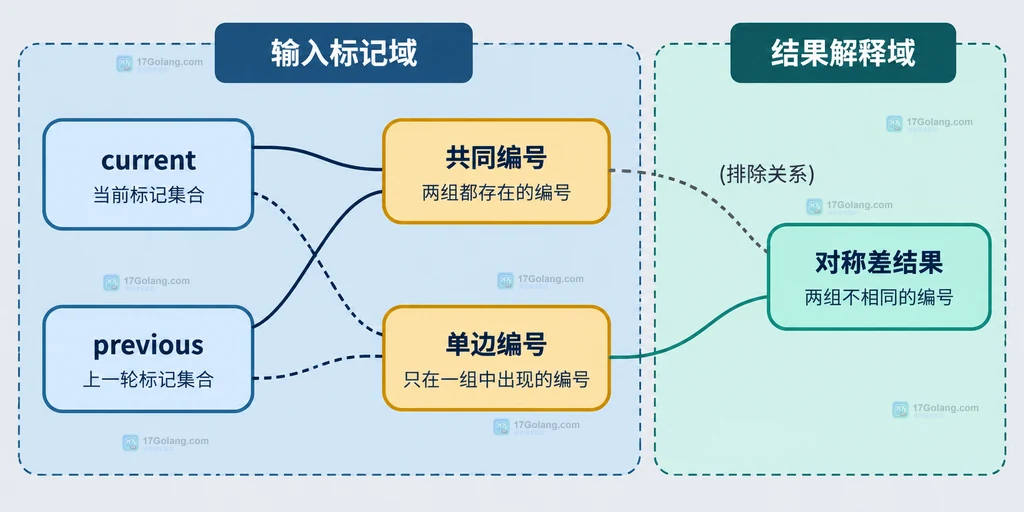
用 SymmetricDifference 保留两组输入
默认推荐非原地方法,因为它把“计算结果”和“原始数据”分开。这个选择适合后面还要分别统计活动用户与历史用户的场景,也能避免把共享的 *BitSet 意外改掉。
package main

import (
    "fmt"

    "github.com/bits-and-blooms/bitset"
)

func main() {
    current := bitset.New(16)
    current.Set(1).Set(3).Set(5).Set(8) // 本次活动的用户编号

    previous := bitset.New(16)
    previous.Set(3).Set(4).Set(8).Set(10) // 上次活动的用户编号

    changed := current.SymmetricDifference(previous) // 返回只在一边出现的新集合
    fmt.Println("差异数量:", changed.Count())             // 结果应包含 1、4、5、10

    for i, ok := changed.NextSet(0); ok; i, ok = changed.NextSet(i + 1) {
        fmt.Println("差异编号:", i) // 只遍历结果集合中的置位编号
    }
}
这里的重点不是把两组位图逐位对齐,而是让库按集合语义计算。Count 表示结果中的置位数量,NextSet 从给定位置寻找下一个已设置的位;如果项目已经使用 Go 1.23,也可以考虑文档中的 EachSet 迭代方式。
需要节省分配时再用原地版本
当 current 只是临时工作集、计算后不再需要原值时,可以直接在它上面做原地对称差。这样写更短,也明确表达“current 将被消费”。
func symmetricDifferenceInPlace() []uint {
    current := bitset.New(16)
    current.Set(1).Set(3).Set(5).Set(8) // 这个集合允许被改写

    previous := bitset.New(16)
    previous.Set(3).Set(4).Set(8).Set(10) // 对照集合保持不变

    current.InPlaceSymmetricDifference(previous) // 结果直接写回 current
    result := make([]uint, 0, current.Count())
    for i, ok := current.NextSet(0); ok; i, ok = current.NextSet(i + 1) {
        result = append(result, i) // 把差异编号交给后续业务层
    }
    return result
}
原地版本最容易出错的地方是别名:如果其他结构仍持有 current 指针,它们看到的内容也会一起变化。要保留快照时,先对集合调用 Clone,再在副本上调用原地方法。
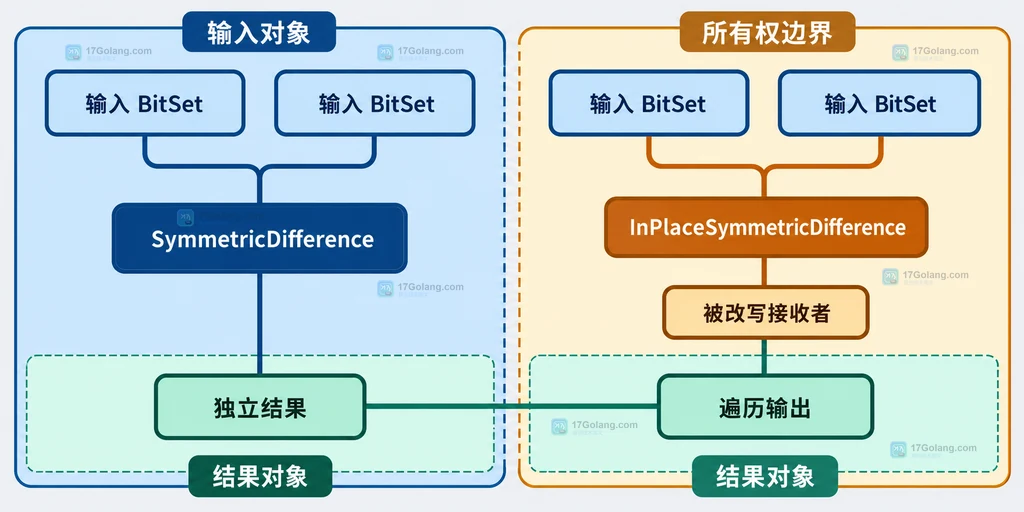
高编号和稀疏数据是实际边界
BitSet 的内存占用与最大访问位编号相关,而不是只与当前置位数量相关。例如只设置编号 10 和 10_000_000,中间的大范围仍会影响位图长度。官方文档还说明 BitSet 不会自动缩小,可按生命周期选择 Shrink 或 Compact。
| 情况 | 推荐写法 | 原因 |
|---|---|---|
| 还要保留 A、B | A.SymmetricDifference(B) | 结果是独立集合,输入语义清晰 |
| A 只是临时工作集 | A.InPlaceSymmetricDifference(B) | 复用 A,减少额外结果对象 |
| 编号很大且很稀疏 | 评估压缩位图或其他集合结构 | 普通 bitset 可能为大量空位付出内存 |
最后可以用三条检查固定实现:相同编号同时出现在两边时结果必须为假;只在一边出现的编号必须保留;原地版本调用后,必须确认接收者是否仍被其他代码共享。这样就能把“计算错了”和“集合被意外改写”区分开。
常见问题
对称差与并集有什么区别?
并集保留两边所有编号;对称差会排除两边共同出现的编号。
怎样只统计变化数量而不遍历结果?
可以先生成对称差后调用 Count;如果只需要基数,写入结果集合再遍历不是必要的。
调用 SymmetricDifference 会修改原集合吗?
按 API 语义应把它当作返回新结果的方法;需要明确修改接收者时,使用名称中带 InPlace 的版本,并在代码审查中标注所有权。
 Go bitset 怎样把位集合编码为二进制数据
- 上一篇
- Go bitset 怎样把位集合编码为二进制数据
- 下一篇
- Python pprint 怎样控制嵌套对象的展开深度
-
- Golang · Go教程 | 16分钟前 |
- Go llrb 怎样删除有序树中的最小元素
- 483浏览 收藏
-
- Golang · Go教程 | 1小时前 | 序列化 · Go教程 · bloomfilter ReadFrom WriteTo Go bloom 过滤器持久化
- Go bloom 怎样把过滤器状态导出后恢复
- 172浏览 收藏
-
- Golang · Go教程 | 1小时前 | 布隆过滤器 · Go教程 · BLOOM Go bloomfilter AddString TestString
- Go bloom 怎样把字符串加入过滤器并查询
- 303浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go bloom 怎样按预估元素数量创建Bloom过滤器
- 227浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go bitset 怎样把位集合编码为二进制数据
- 421浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go roaring 怎样把Roaring位图序列化到字节流
- 401浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 808次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 798次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 888次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 860次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 686次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览


