Python tomllib 怎样处理重复键解析错误
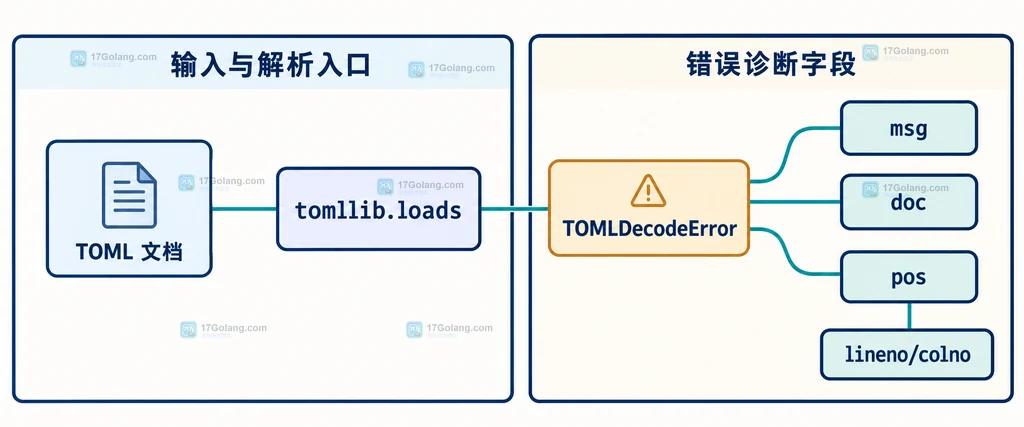
用 Python 的 tomllib 读取 TOML 时,同一个文档作用域内重复定义同一个键,不会自动覆盖旧值,而会被视为无效 TOML,抛出 tomllib.TOMLDecodeError。处理思路不是给解析器增加“最后一个值生效”的开关,而是从异常中取出冲突位置,回到输入文档删除或合并重复定义。
官方地址:https://docs.python.org/3/library/tomllib.html
先记住一句话:重复键是 TOML 输入结构的问题;tomllib 负责拒绝无效文档,修复应发生在配置源或生成配置的模板上。
先区分重复键和普通类型错误
配置排错时,看到“解析失败”并不等于所有错误都一样。字符串没有闭合、数组语法错误、表路径冲突和重复键都会进入 TOMLDecodeError,但修复动作不同。重复键的典型输入如下:
[server]
host = "127.0.0.1"
port = 8080
port = 9090  # 同一个 [server] 表中再次定义 port
这里的两个 port 属于同一个 server 表。解析器不能替业务决定 8080 和 9090 哪个正确,因此不会像普通 Python 字典赋值那样静默覆盖。若只是不同表下的同名键,则要按完整表路径判断,不能只看到键名相同就判定为冲突。
用异常字段找到重复键位置
TOMLDecodeError 是 ValueError 的子类。当前 Python 文档列出了 msg、doc、pos,以及可直接使用的 lineno 和 colno。这几个字段适合分别承担“告诉用户发生了什么”“保留原文”“确定偏移”“显示行列”的职责。
import tomllib

toml_text = """
[server]
port = 8080
port = 9090
"""

try:
    # loads 接收字符串;重复键属于无效 TOML,不要假设后值会覆盖前值。
    config = tomllib.loads(toml_text)
except tomllib.TOMLDecodeError as exc:
    # msg 适合展示原因,lineno/colno 适合把编辑器定位到冲突附近。
    print(f"解析失败:{exc.msg}")
    print(f"位置:第 {exc.lineno} 行,第 {exc.colno} 列,偏移 {exc.pos}")
    # doc 保留原始输入;生产环境可截取上下文,避免把整份敏感配置写入日志。
如果项目需要兼容 Python 3.11 到 3.13,应注意异常对象的定位属性并不应被无条件假设为完整可用。可以把 getattr 作为兼容层,主流程仍然捕获 TOMLDecodeError。在 Python 3.14 及以后,文档明确列出了这些消息和位置参数。
def parse_toml_text(text: str) -> dict:
    try:
        # 统一入口便于文件读取、环境变量和测试字符串复用同一套错误处理。
        return tomllib.loads(text)
    except tomllib.TOMLDecodeError as exc:
        # 兼容旧版本:定位字段不存在时仍返回可读的解析原因。
        line = getattr(exc, "lineno", None)
        column = getattr(exc, "colno", None)
        detail = f"{exc.msg}"
        if line is not None and column is not None:
            detail += f"(第 {line} 行,第 {column} 列)"
        raise ValueError(f"TOML 配置无效:{detail}") from exc
修复同一张表里的重复定义
最稳妥的修复方式是回到生成 TOML 的源头,只保留一个键定义。如果两个值都来自不同环境或模板片段,不要直接拼接成两个同名键;应在生成前先合并成一个明确的最终值。
# 修复后:server 表中每个键只定义一次
[server]
host = "127.0.0.1"
port = 9090
timeout_seconds = 15
若配置来自多个文件,建议先把环境覆盖规则落实到 Python 字典或模板变量,再序列化为 TOML。这样“谁覆盖谁”是应用层的明确决策,不会把不确定性留给 TOML 解析器。若必须保留两个候选端口,应使用不同的键名,例如 internal_port 和 public_port,不要依赖重复键表达候选关系。
嵌套表和数组表要按完整路径判断
键名相同不一定冲突,关键是它们属于哪个表。下面的 host 分别在 server 和 database 表中,完整路径不同,因此表达的是两个配置字段。
[server]
host = "127.0.0.1"

[database]
host = "db.internal"

[[worker]]
name = "indexer"
enabled = true

[[worker]]
name = "notifier"
enabled = false
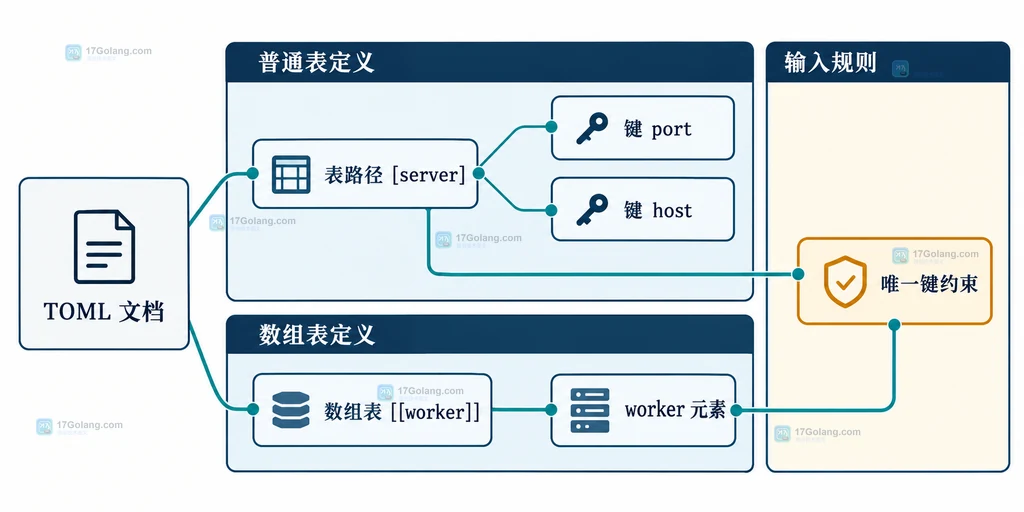
[[worker]] 是数组表,每次声明表示一个新的元素;每个元素内部仍然不能把同一个键定义两次。排错时建议把配置键写成完整路径,例如 server.host、database.host、worker[0].enabled,比只记录 host 或 enabled 更不容易误判。
文件读取和字符串读取统一处理
tomllib.load 面向可读取的二进制文件对象,tomllib.loads 面向字符串。二者对非法文档都抛出同类异常,所以可以让文件读取层只负责打开资源,把解析和错误转换交给同一个函数。
from pathlib import Path
import tomllib

def load_config(path: Path) -> dict:
    try:
        # tomllib.load 需要二进制模式;with 会在解析失败时也关闭文件。
        with path.open("rb") as file_obj:
            return tomllib.load(file_obj)
    except tomllib.TOMLDecodeError as exc:
        # 不把完整配置直接写入日志,只保留文件名、原因和定位字段。
        line = getattr(exc, "lineno", "?")
        column = getattr(exc, "colno", "?")
        raise ValueError(
            f"{path} 的 TOML 在第 {line} 行第 {column} 列无效:{exc.msg}"
        ) from exc
这层封装不负责“自动修复”重复键。自动选择第一个或最后一个值,会让配置结果依赖文本顺序,尤其容易掩盖发布模板、环境变量合并或人工编辑中的真正问题。更好的做法是让部署前的配置生成步骤报出完整路径,并让修改回到源模板。
排错速查
| 现象 | 优先检查 | 处理方式 |
|---|---|---|
| 同一表中键出现两次 | 完整表路径与重复行 | 删除或合并其中一个定义 |
| 同名键位于不同表 | 表头是否不同 | 按完整路径判断,通常不必改名 |
| 异常没有行列字段 | Python 版本 | 用 getattr 兼容旧版本,同时保留 msg |
| 配置由多个片段拼接 | 生成前的合并逻辑 | 先确定覆盖规则,再输出单一 TOML 键 |
结论
处理 Python tomllib 的重复键错误,可以按四个动作完成:捕获 TOMLDecodeError,读取 msg 与行列位置,按完整表路径确认冲突,最后修复 TOML 生成源。tomllib 的价值正在于拒绝含糊输入;把重复键变成“最后一个值覆盖前一个值”虽然看似方便,却会让配置错误变得更难追踪。
相关问题
- tomllib 会自动覆盖重复键吗?不会。重复键属于无效 TOML,应修复输入。
- 同名键在不同表中也算重复吗?不一定,要按完整表路径判断。
- 为什么要保留异常的 doc 字段?它能帮助诊断位置,但生产日志应避免直接输出敏感配置全文。
- tomllib 能把修复后的配置写回 TOML 吗?不能;它是标准库中的读取解析器,不提供 TOML 写入接口。
 Python sqlite3 事务控制怎样避免隐式提交