
Java Virtual Threads 怎样避免线程本地变量滥用
Java Virtual Threads 让大量阻塞 I/O 任务可以用“一个任务一个虚拟线程”的方式表达,但这不等于每个线程都适合挂一份状态。避免线程本地变量滥用的核心是先分清:请求元数据可以短时传播,连接、缓冲区、客户端和可变业务状态必须回到任务或资源管理器的生命周期。
官方资料:https://docs.oracle.com/en/java/javase/21/core/virtual-threads.html
迁移时保留少量、只读、请求级的上下文;把资源创建与关闭放在任务边界,把连接数和外部并发交给连接池或限流器。ThreadLocal 不是资源池,也不是虚拟线程的共享缓存。
目标和边界:先给 ThreadLocal 字段分类
Virtual Thread 不是固定绑定某个操作系统线程的轻量版平台线程。阻塞 I/O 时,运行时可以挂起虚拟线程并释放承载线程,因此一个 JVM 可能同时拥有非常多的虚拟线程。Oracle 文档也特别提醒:虽然虚拟线程支持 thread-local variables 和 inheritable thread-local variables,但使用前要谨慎。
可以把现有字段分成三类:
| 字段类型 | 推荐承载方式 | 边界 |
|---|---|---|
| traceId、租户、只读认证摘要 | 方法参数或 ScopedValue | 只覆盖一次请求或一次调用链 |
| 事务对象、数据库连接、HTTP 客户端 | 任务内显式管理、连接池 | 必须有明确 close、超时和容量 |
| 可变缓存、批处理累加器 | 任务对象、消息或并发容器 | 不能依赖当前线程身份定位状态 |
为什么每个虚拟线程都放一份状态容易失控
ThreadLocal 的值属于访问它的线程副本。线程存活期间,这份副本会继续存在;虚拟线程数量上升时,哪怕单个值不大,累计对象、引用链和初始化成本也会放大。更危险的是把连接、会话客户端或大缓冲区放进去:它们看似“线程隔离”,实际却绕过了资源池的容量和回收策略。
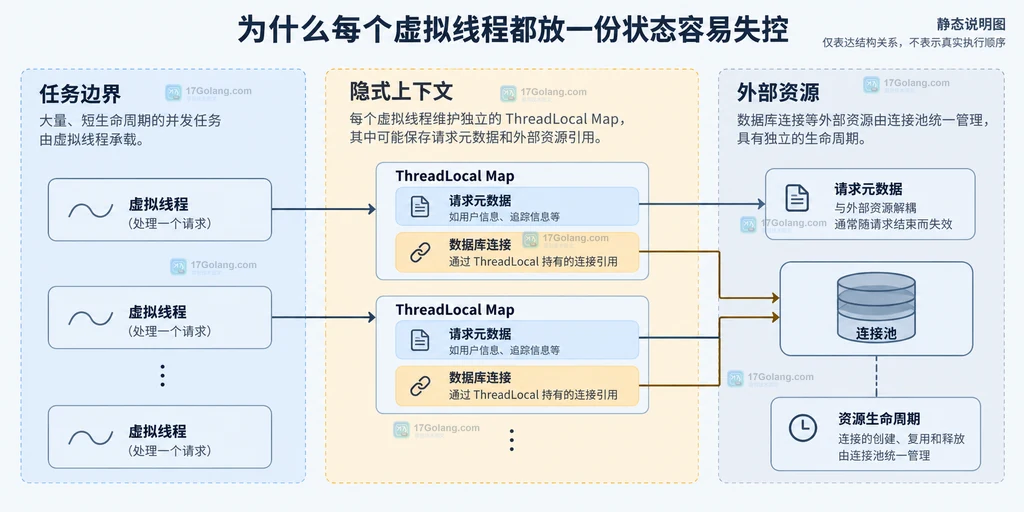
常见误区是把 ThreadLocal.remove() 当成万能修复。它只能清掉当前线程当前变量的值,不能解决值本身过大、继承成本、任务取消时未执行清理,或把资源池误当作线程缓存的问题。在线程池场景还要担心上一个任务的值泄漏到下一个任务;虚拟线程通常按任务创建,泄漏形态不同,但不代表可以无限绑定对象。
只读上下文:显式参数优先,ScopedValue 谨慎使用
如果下游方法真的需要 traceId,最容易审查的是显式参数。它让调用关系可见,也不会因为某个静态字段被悄悄读取而增加隐式依赖。只有当调用链很深、且数据确实是“调用者绑定、被调用者只读”时,才考虑 ScopedValue。
Java 21 中的 ScopedValue 仍是 preview API,需要启用预览特性。它按动态作用域绑定值,外层调用完成后绑定自动解除;Oracle API 文档还指出,相比 ThreadLocal,它更适合单向传输,因为远端被调用者不能直接设置调用者的值。
import java.lang.ScopedValue;

public final class RequestContext {
    // 只绑定不可变的请求元数据,不放连接或可变缓存。
    private static final ScopedValue META = ScopedValue.newInstance();

    public static void serve(RequestMeta meta) {
        // 绑定只覆盖本次调用,退出 lambda 后自动解除。
        ScopedValue.runWhere(META, meta, RequestContext::handle);
    }

    private static void handle() {
        // 下游只能读取当前作用域中的元数据,未绑定时立即暴露调用错误。
        RequestMeta meta = META.orElseThrow(() -> new IllegalStateException("缺少请求上下文"));
        audit(meta.traceId());
    }

    private static void audit(String traceId) {
        // 只记录短字符串,不借此缓存数据库连接或客户端实例。
        System.out.println("trace=" + traceId);
    }

    public record RequestMeta(String traceId, String tenant) {}
}
上面的选择仍有边界:ScopedValue 适合少量、短生命周期、只读的上下文;可变对象即使被放进 ScopedValue,也可能被下游修改。若参数只有一两层,直接传参通常更清楚。若需要跨线程结构化共享,还要保证对象不可变或自行同步。
资源生命周期:不要用 ThreadLocal 代替连接池
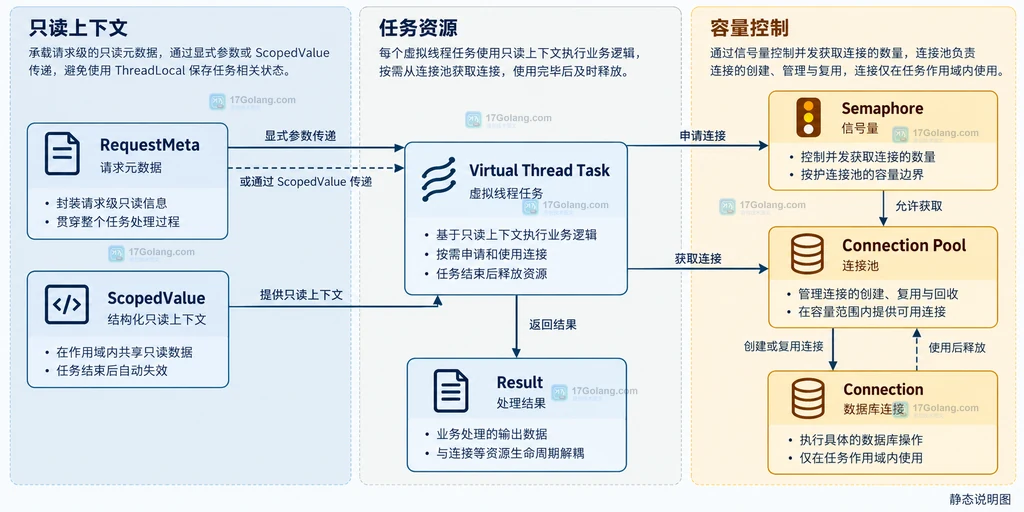
虚拟线程数量可以远大于数据库连接数、下游 HTTP 并发额度或文件描述符上限。资源控制应由连接池、客户端配置和明确的 Semaphore 完成,而不是给每个虚拟线程懒加载一份资源。
import java.sql.Connection;
import java.util.concurrent.Semaphore;

public final class QueryTask {
    // 许可数代表外部数据库允许的并发,不等于虚拟线程数量。
    private static final Semaphore DB_LIMIT = new Semaphore(32);

    public static Result query(DataSource dataSource, String sql) throws Exception {
        DB_LIMIT.acquire();
        try (Connection connection = dataSource.getConnection()) {
            // 连接由任务显式取得并关闭,避免藏在 ThreadLocal 中跨任务存活。
            try (var statement = connection.prepareStatement(sql)) {
                return read(statement.executeQuery());
            }
        } finally {
            // 无论查询成功、失败还是取消,都归还并发许可。
            DB_LIMIT.release();
        }
    }

    private static Result read(java.sql.ResultSet rows) throws Exception {
        // 示例只表示结果映射边界,不把 ResultSet 放进线程本地变量。
        return Result.from(rows);
    }

    public interface DataSource {
        Connection getConnection() throws Exception;
    }
    public record Result(String value) {
        static Result from(java.sql.ResultSet rows) { return new Result("按业务映射结果"); }
    }
}
这里的重点不是把许可数写死为 32,而是让它由数据库、连接池和下游服务容量共同决定。Virtual Threads 负责承载等待,不负责扩大外部资源上限。
推荐迁移流程和检查点
- 列清单:记录每个 ThreadLocal 的类型、初始化方式、值大小、所有者和清理点;看见连接、客户端、大数组或可变缓存就先移出。
- 缩短上下文:traceId、租户等只读元数据优先改为方法参数;调用链很深时再评估 Java 21 preview 的 ScopedValue。
- 固定资源边界:在虚拟线程任务内取得资源,用 try-with-resources 关闭;连接池、Semaphore 和超时控制外部容量。
- 验证异常路径:检查取消、超时、异常和早返回是否仍会释放资源;ThreadLocal 只在确有必要时配对 remove。
迁移后的判断标准不是“ThreadLocal 数量变成零”,而是每个字段都能回答三件事:谁拥有它、它最多存活多久、它在并发升高时会不会按虚拟线程数量复制。回答不清楚的字段,就不应继续放在隐式线程状态里。
常见问题
Virtual Threads 能不能完全禁止 ThreadLocal?
不必一刀切。少量、短生命周期的请求元数据仍可能适合 ThreadLocal,但要明确清理和继承边界;资源对象、可变缓存和需要容量控制的外部客户端不应借此保存。
ScopedValue 是否已经可以无条件替代 ThreadLocal?
不能。Java 21 的 ScopedValue 是 preview API,部署链需要允许预览特性;它解决的是只读、单向、动态作用域传递,不是通用的可变状态容器或资源池。
速查表
| 问题 | 优先方案 | 不要做什么 |
|---|---|---|
| 深层调用链读取 traceId | 显式参数或 ScopedValue | 让任意下游修改隐式状态 |
| 数据库连接和 HTTP 客户端 | 连接池、任务边界、超时 | 按虚拟线程懒加载并长期持有 |
| 批处理中的可变结果 | 任务对象或并发容器 | 用当前线程身份寻找结果 |
 Java switch 表达式怎样处理枚举穷尽性
- 上一篇
- Java switch 表达式怎样处理枚举穷尽性
- 下一篇
- Java Files.probeContentType 怎样判断文件的 MIME 类型
-
- 文章 · java教程 | 26分钟前 |
- Java DateTimeFormatterBuilder 怎样兼容多种日期格式
- 266浏览 收藏
-
- 文章 · java教程 | 28分钟前 |
- Java LineNumberReader 设置行号后为什么不会跳行
- 366浏览 收藏
-
- 文章 · java教程 | 47分钟前 |
- Java CompletableFuture.orTimeout 怎样设置异步超时
- 443浏览 收藏
-
- 文章 · java教程 | 50分钟前 | 网络编程 · Java · HTTP · Stream · java httpclient Stream BodyHandlers.ofLines HTTPResponse
- Java HttpClient BodyHandlers.ofLines 怎样流式读取响应
- 151浏览 收藏
-
- 文章 · java教程 | 52分钟前 |
- Java PushbackReader 怎样回退多读的一个字符
- 206浏览 收藏
-
- 文章 · java教程 | 1小时前 | Java · java 字符串拼接 StringJoiner setEmptyValue
- Java StringJoiner 怎样设置空集合的默认输出
- 259浏览 收藏
-
- 文章 · java教程 | 17小时前 |
- Java Pattern quoteReplacement 怎样处理字面量替换文本
- 191浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 765次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 762次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 844次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 814次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 641次使用
-
- Go map 并发写 panic 怎么办:从共享 map 到可控写入路径
- 2026-06-30 123浏览
-
- Go保证并发安全底层实现详解
- 2023-02-24 417浏览
-
- Go语言开发保证并发安全实例详解
- 2023-01-07 328浏览
-
- Golang 手写一个简单的并发任务 manager
- 2022-12-23 367浏览
-
- Go Java 算法之字符串解码示例详解
- 2023-01-07 479浏览


