
Linux ip 命令查看策略路由命中顺序
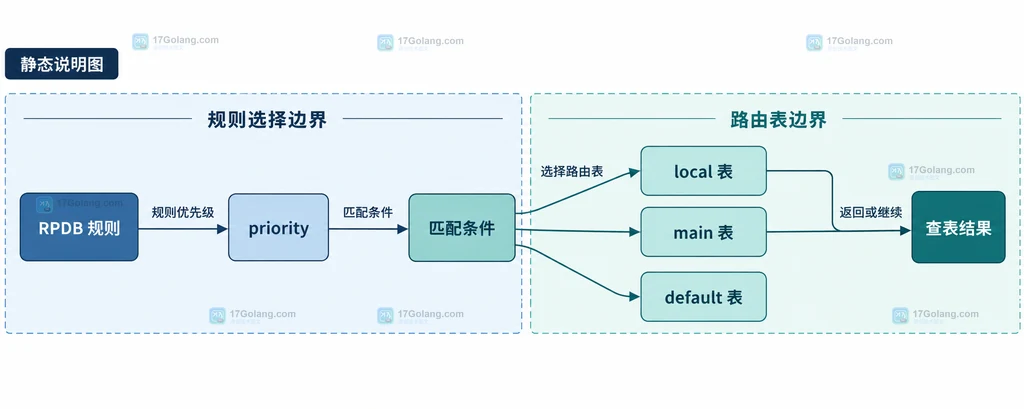
排查 Linux 策略路由时,先看 ip rule show 得到 RPDB 的检查顺序,再用与目标流量相同的目的地址、源地址、入口接口和 fwmark 调用 ip route get。规则的 priority 数字越小越先检查;某条规则匹配后,如果关联路由表没有给出可用结果,内核才会继续看后面的规则。
想知道“哪条规则先被检查”,看ip rule的 priority;想知道“这组条件最后选到哪条路由”,看ip route get。两者是规则顺序和路由解析的两份互补信息,不要把ip route get当成逐条规则命中日志。
Linux 内核网络文档地址:https://www.kernel.org/doc/html/latest/networking/
下面把问题收敛成一个只读的小项目:给定一个目的地址,分别模拟普通本机流量、指定源地址的流量和带 mark 的流量,整理出“规则条件—路由表—最终结果”的判断链。示例使用文档保留地址,不代表当前机器的真实配置。
项目目标:做一张策略路由命中诊断卡
假设待排查的目的地址是 203.0.113.8,可能的源地址是 192.0.2.10,入口接口是 eth1,防火墙标记是 0x2。这四个条件并不是每次都必须填写,但它们决定了规则选择器是否相同。
| 信息 | 对应排查问题 | 常用 ip 参数 |
|---|---|---|
| 目的地址 | 最终要去哪里 | route get 的位置参数 |
| 源地址 | 源地址策略是否改变路由表 | from |
| 入口接口 | 转发流量是否命中 iif 规则 | iif |
| fwmark | 打标流量是否命中 mark 规则 | mark |
先把这些值写进诊断记录,再开始看规则。这样可以避免第一次查询带了源地址,第二次查询却只给目的地址,最后把两个不同的决策结果误认为“规则顺序不稳定”。
准备环境:只读查看当前 RPDB
ip rule 操作的是路由策略数据库(RPDB),而 ip route 操作的是具体路由表。第一轮只读取版本和规则,不需要为了查看顺序修改任何配置。
# 查看 iproute2 是否可用;这里只读取版本信息。
ip -V

# 按 priority 列出策略规则,先看规则顺序和 lookup 目标。
ip rule show

# 显示更完整的规则属性,便于发现 fwmark、iif、suppress 等条件。
ip -details rule show
常见的默认 RPDB 包含三条规则:priority 为 0 的 local 表、priority 为 32766 的 main 表,以及 priority 为 32767 的 default 表。实际主机可能由 NetworkManager、容器运行时、VRF 或其他网络管理组件添加额外规则,所以以当前命令输出为准。
按 priority 读取 RPDB 的检查顺序
策略规则按 priority 数字递增检查。数字越小,越早进入选择器判断;它和路由表内部的最长前缀、metric 或 preference 不是同一个排序维度。
下面是格式化后的示例输出,仅用于说明如何阅读字段:
0:      from all lookup local
100:    from 192.0.2.0/24 lookup 100
110:    fwmark 0x2/0xff lookup 200
32766:  from all lookup main
32767:  from all lookup default
阅读这份列表时可以按三列拆开:
- priority:决定这条规则在 RPDB 中的检查位置,
100先于110,两者都先于32766。 - selector:例如
from、fwmark、iif,决定当前流量是否符合规则。 - action:例如
lookup 100,表示匹配后尝试查询编号为 100 的路由表。
“命中”不能只理解为选择器匹配。规则匹配后,查表动作还可能没有找到可用路由,或者被 suppress_prefixlength 之类的抑制条件排除;这时 RPDB 才会继续处理后面的规则。最终判断要把规则输出和一次实际查询放在一起看。
用 ip route get 复现一次路由查询
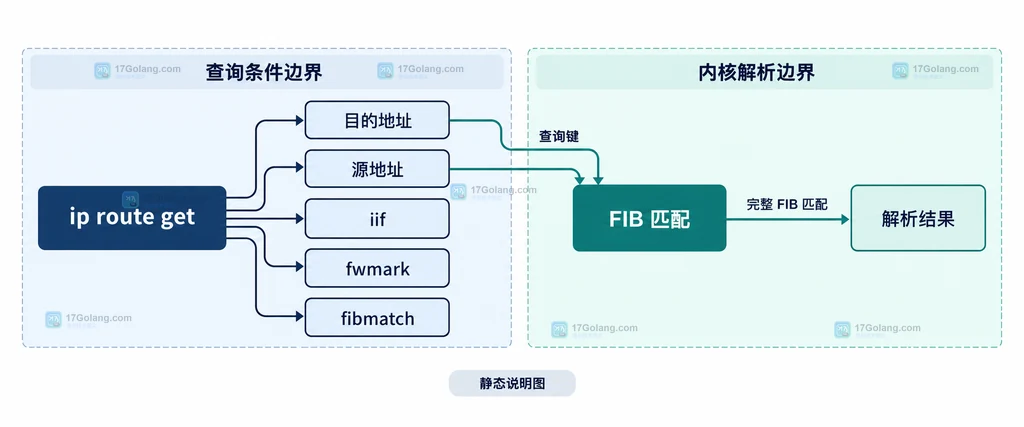
ip route get 不是把路由表静态打印出来,而是请求内核解析一条到目标地址的路由。它可以带上 from、iif、mark 等条件;fibmatch 用于查看完整的 FIB 匹配路由。查询不会真的发送数据包。
# 先只按目的地址查询,作为没有额外选择器的基线。
ip route get 203.0.113.8

# 加入源地址,模拟源地址策略可能影响的本机流量。
ip route get 203.0.113.8 from 192.0.2.10

# 加入入口接口,模拟从 eth1 进入后需要转发的流量。
ip route get 203.0.113.8 from 192.0.2.10 iif eth1

# 加入 mark,并请求完整的 FIB 匹配信息;0x2 只是本例的示意标记。
ip route get fibmatch 203.0.113.8 from 192.0.2.10 mark 0x2
这几条命令的关键不是记住某一行示例输出,而是每次只改变一个决策输入:如果加上 from 后出口改变,优先回到含 from 的规则;如果加上 mark 后出口改变,优先回到含 fwmark 的规则。ip route get 给出的是解析结果,规则优先级仍要从 ip rule show 中读取。
把规则条件与查询结果逐项对照
为了把这个小项目做成可复用的诊断卡,可以固定四组查询。它们不写入配置,只收集同一目的地址在不同选择器下的结果。
# 用统一变量避免四组查询使用不同的目标地址。
DST="203.0.113.8"
SRC="192.0.2.10"
IIF="eth1"
MARK="0x2"

# 基线:只提供目的地址,观察普通输出路径。
ip route get "$DST"

# 源地址维度:对应 ip rule 中的 from 选择器。
ip route get "$DST" from "$SRC"

# 入口接口维度:对应转发规则中的 iif 选择器。
ip route get "$DST" from "$SRC" iif "$IIF"

# 标记维度:对应 fwmark 选择器;fibmatch 用于展开 FIB 匹配路由。
ip route get fibmatch "$DST" from "$SRC" mark "$MARK"
对照时可使用下面的判断表:
| 现象 | 优先检查 | 不要直接下的结论 |
|---|---|---|
| 只加源地址就换出口 | 含 from 的规则及其 lookup 表 | 不能说 priority 最大的规则生效 |
| 只加 mark 就换出口 | mark 值、掩码和 fwmark 规则 | 不能把 mark 当成路由表编号 |
| 规则匹配但没有可用路由 | 对应表的前缀、类型和 suppress 条件 | 不能说 RPDB 在此处永久停止 |
| 查询结果与预期不同 | 查询是否缺少 from、iif 或 mark | 不能先假设内核忽略了 priority |
特别要注意 ip route get 与 ip route show 的差别:后者是在列出现有条目,前者是在给定查询键下请求解析结果。排障时只看某张表的静态条目,无法替代带完整条件的 route get。
验收:怎样确认自己真的看懂了命中顺序
一张合格的诊断卡至少应当能回答五个问题:
- 当前规则按什么 priority 顺序排列,是否存在数字更小的自定义规则?
- 目标流量的源地址、入口接口和 mark 是否与查询命令一致?
- 匹配到的规则指向哪一张路由表,表内是否存在能返回结果的条目?
- 是否存在
suppress_prefixlength、黑洞、不可达或禁止类型等会改变结果的动作? - 最后的
ip route get输出是否与规则和路由表的解释一致?
如果这五项都能从命令输出中指出对应字段,基本就能解释“为什么这条规则先检查、为什么没有停在那里、最后为什么落到 main 或其他表”。如果只能看到一个出口接口,却说不出使用了哪些查询条件,说明诊断输入还不完整。
ip rule 的数字越大是不是越先命中?
不是。RPDB 按 priority 数字递增检查,数字越小越先。32766 的 main 规则通常会晚于 priority 为 100 的自定义规则。
ip route get 能直接显示第几条 ip rule 命中吗?
它主要返回一次路由解析结果,不能简单当成逐条 RPDB 规则的命中日志。要判断顺序,需要把同一查询条件与 ip rule show 的 priority、selector 和 lookup 目标对照。
为什么只执行 ip route show 看不出策略路由结果?
ip route show 展示的是路由表条目,未必带上源地址、入口接口和 mark 这些策略键。需要使用带完整条件的 ip route get 复现一次查询。
fibmatch 和普通 ip route get 有什么区别?
普通查询返回解析后的路由结果,fibmatch 更偏向展示完整的 FIB 匹配路由。它仍然不是一份逐条策略规则执行日志,规则顺序仍需从 RPDB 输出中确认。
 Linux systemd RestrictAddressFamilies 怎样限制服务使用的网络协议族
- 上一篇
- Linux systemd RestrictAddressFamilies 怎样限制服务使用的网络协议族
- 下一篇
- Linux find 按时间与大小组合筛选文件
-
- 文章 · linux | 40分钟前 | Linux · Linux tmpfiles.d systemd-tmpfiles 临时目录清理
- Linux tmpfiles.d 临时目录清理规则的部署
- 223浏览 收藏
-
- 文章 · linux | 42分钟前 |
- Linux vmstat 指标与 I/O 等待的判断
- 225浏览 收藏
-
- 文章 · linux | 44分钟前 |
- Linux perf record 采样权限与调用栈配置
- 301浏览 收藏
-
- 文章 · linux | 46分钟前 |
- Linux systemd.socket ListenDatagram 怎样监听 UDP 套接字
- 216浏览 收藏
-
- 文章 · linux | 50分钟前 | linux运维 · Linux Rsync 断点续传 partial-dir append-verify
- Linux rsync 部分传输后的断点续传参数
- 108浏览 收藏
-
- 文章 · linux | 50分钟前 |
- Linux tar 排除规则与目录层级的打包
- 434浏览 收藏
-
- 文章 · linux | 53分钟前 | Linux ·
- Linux nftables 集合规则的批量维护
- 112浏览 收藏
-
- 文章 · linux | 53分钟前 |
- Linux find 按时间与大小组合筛选文件
- 404浏览 收藏
-
- 文章 · linux | 57分钟前 |
- Linux systemd RestrictAddressFamilies 怎样限制服务使用的网络协议族
- 117浏览 收藏
-
- 文章 · linux | 1小时前 |
- Linux systemd-escape 怎样把路径转换成实例化 unit 名称
- 382浏览 收藏
-
- 文章 · linux | 1小时前 | 定时器 · Linux · 运维 · 服务管理 · Linux 定时任务 OnCalendar 单调时间 systemd.timer OnBootSec
- Linux systemd.timer 日历与单调时间的选择
- 430浏览 收藏
-
- 文章 · linux | 1小时前 |
- Linux systemd.path 监听文件变化的触发配置
- 123浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 755次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 753次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 834次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 800次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 634次使用
-
- Linux vmstat 如何分辨内存抖动与磁盘等待:si、so、wa 与复测顺序
- 2026-08-30 501浏览
-
- Linux搭建vsftpdFTP服务器教程
- 2026-04-30 501浏览
-
- Shell脚本安装教程:.sh一键安装指南
- 2026-03-16 501浏览
-
- Linux清空文件内容的几种方法
- 2025-12-01 501浏览
-
- Linux命令行下载文件技巧
- 2025-11-23 501浏览


