
Whisper 音频分段与时间戳对齐的工程方案
Whisper 做短音频转写时很容易得到一份看似正常的结果;一旦音频超过单次上下文,真正难的是把每个窗口里的局部时间戳接回同一条全局时间轴。工程上应先固定音频坐标,再用 30 秒上下文窗口和少量重叠保留边界语境,最后把局部 segment 或 word 时间加上窗口偏移,并对重叠区域做一次确定性的去重。
官方资料:https://github.com/openai/whisper Transformers 文档:https://huggingface.co/docs/transformers/model_doc/whisper
字幕级交付优先使用 segment 时间戳;需要逐词高亮、检索或点击回放时再使用 word 时间戳。重叠窗口只是上下文缓冲,不是可以直接拼接的两份正文。
先统一采样与全局时间坐标
先约定一条“原始音频时间轴”,所有窗口的起点、模型返回的局部时间和最终字幕都只映射到这条轴上。常见做法是把输入统一为单声道、16 kHz 浮点音频;如果业务必须保留原采样率,也要在分段器里记录重采样比例,不能在不同阶段各自换算。
Whisper 的原始实现围绕约 30 秒的输入上下文处理长音频。窗口不必刚好按自然句子切开,因为模型并不知道你的字幕行规则;重要的是为每个窗口保存 start、end、overlap 和有效区间,之后所有局部时间都用 global = window_start + local 转换。
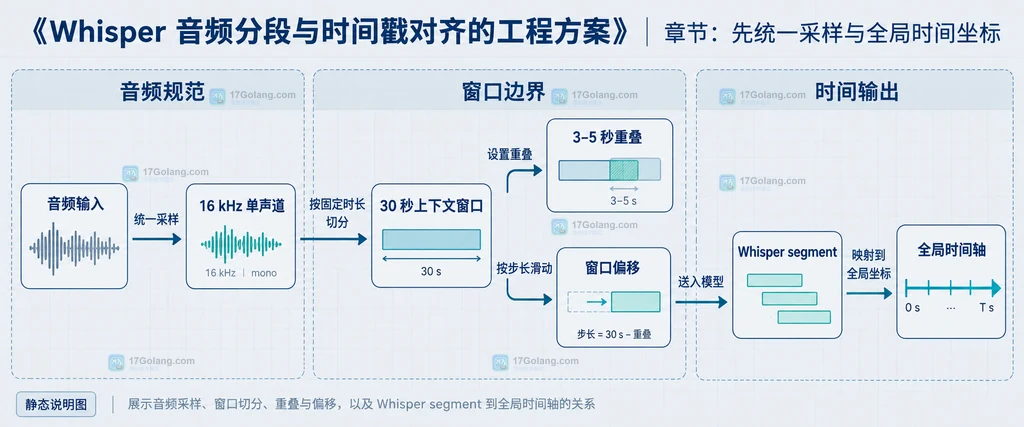
窗口长度固定,重叠只负责保留边界语境
如果采用 Transformers 的 pipeline,可以把 chunk_length_s 设为 30,并按语音连续性选择小幅 stride_length_s。重叠一般取几秒作为工程起点,再结合说话速度、背景噪声和字幕需求调整;它解决的是句子跨窗口时缺少上下文的问题,不代表两边输出都要保留。
长音频方案至少需要三个边界字段:
| 字段 | 含义 | 合并时的作用 |
|---|---|---|
| window_start | 窗口在原音频中的起点 | 把局部时间换算为全局时间 |
| overlap_start/end | 与相邻窗口相交的范围 | 只在此范围寻找重复候选 |
| valid_start/end | 本窗口最终负责交付的范围 | 避免整段结果重复写入 |
不要把 stride 误当成“需要截掉的固定字符数”。边界可能落在一个词的中间,正确做法是先把词或 segment 映射到全局时间,再依据时间区间和文本重合度判断是否重复。若使用 Hugging Face pipeline 的 chunking,要留意官方文档对 seq2seq 长音频分段的说明;对需要更强控制的场景,直接使用模型的长音频生成参数并保存分段信息更容易追溯。
按交付目标选择 segment 或 word 时间戳
return_timestamps=True 适合拿到可读的片段级边界,通常用于 SRT、VTT、章节列表或检索卡片;return_timestamps="word" 适合逐词高亮和点击回放,但结果更细,边界抖动也更容易暴露。OpenAI 原始实现的 word_timestamps 会根据对齐过程给词分配起止时间,不能把它理解成强制对齐工具。
from transformers import pipeline

# 30 秒上下文覆盖长音频;stride 只保留窗口边界的少量语境。
pipe = pipeline(
    "automatic-speech-recognition",
    model="openai/whisper-base",
    chunk_length_s=30,
    stride_length_s=(4, 2),
)

# 片段级适合字幕;逐词需求再把 return_timestamps 改为 "word"。
result = pipe("meeting.wav", return_timestamps=True)
for chunk in result.get("chunks", []):
    start, end = chunk["timestamp"]
    text = chunk["text"].strip()
    if start is not None and end is not None and text:
        print(start, end, text)
这里的参数示例用于说明数据关系,不代表本文在本机执行过模型。生产代码还应保存模型名、语言、任务类型和音频摘要,保证同一批字幕可以追溯到同一组推理配置。
把局部时间映射成全局条目并处理重叠
合并时先做时间映射,再做去重。对每个局部条目加上窗口起点;如果条目完全落在相邻窗口的重叠区,就把它标记为候选,而不是立即删除。随后按时间相交、文本规范化后的相似度和边界归属决定保留哪一条。通常优先保留覆盖更完整、起止更稳定且不跨越有效区间的条目。
def to_global(chunk, window_start):
    """把窗口内时间转换为原音频时间;缺失端点不参与字幕合并。"""
    local_start, local_end = chunk["timestamp"]
    text = chunk["text"].strip()
    if local_start is None or local_end is None or not text:
        return None
    # 保留浮点秒,最后输出字幕时再统一舍入,避免多次取整累积误差。
    return {
        "start": window_start + local_start,
        "end": window_start + local_end,
        "text": text,
    }

def keep_boundary_item(item, valid_start, valid_end):
    # 只让本窗口负责的有效区间进入最终结果,重叠区仍可用于比较。
    return item["end"] > valid_start and item["start"]
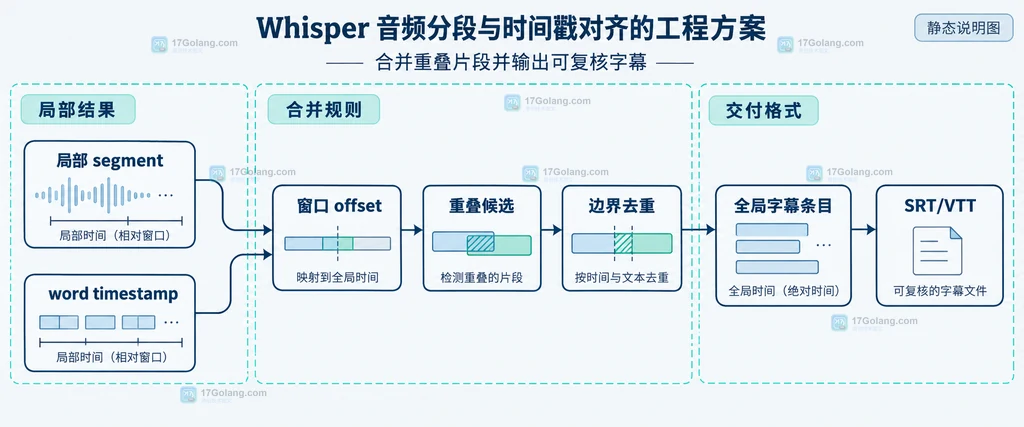
对于逐词结果,可以把重叠候选按时间排序,再用“相邻词时间相交 + 规范化文本相同或高度相似”作为去重条件;对于 segment 结果,则更适合比较片段的时间交集和文本前后缀。不要仅按数组下标删除,因为一个窗口可能多出一个短语,另一个窗口却少识别一个词。
用边界指标复核字幕,而不是只看整段文本
最终复核至少看四类问题:窗口边界是否出现重复词,字幕条目是否单调递增,是否有过长的无声空洞,以及同一句话是否被切成不可读的短条目。把抽样复核放在合并后的全局结果上,而不是只看某个窗口的原始返回。
| 现象 | 优先检查 | 调整方向 |
|---|---|---|
| 边界重复整句 | 重叠候选未去重或有效区间过宽 | 收紧 valid 区间并比较文本/时间交集 |
| 每段都提前或滞后 | window_start 或重采样换算 | 统一时间基准,禁止重复加偏移 |
| 逐词时间跳动 | 词级对齐本身与噪声 | 字幕交付降级到 segment,保留词级供检索 |
| 长句在边界断裂 | 窗口语境不足 | 增加少量 overlap,不能无限扩大窗口 |
相关问题
为什么不能直接拼接所有窗口的 chunks?
因为重叠区会重复产生同一段语音,而且相邻窗口的局部时间起点不同。必须先加窗口偏移,再按有效区间和重叠规则合并。
字幕一定要使用 word 时间戳吗?
不一定。字幕更看重可读性和稳定的片段边界;逐词时间适合高亮、检索和点击回放,工程成本与边界抖动也更高。
重叠秒数越大越好吗?
不是。重叠增加会扩大计算量和重复候选,先用较小范围覆盖跨句边界,再依据抽样结果调整,并保持去重规则不变。
参考资料:OpenAI Whisper 官方仓库、Hugging Face Whisper 文档。本文的窗口字段、有效区间与去重规则是面向字幕工程的实现建议,不是模型默认输出的额外保证。
 MCP 资源订阅变更通知的客户端处理
- 上一篇
- MCP 资源订阅变更通知的客户端处理
- 下一篇
- GitHub Actions 可复用工作流的输入边界变化
-
- 科技周边 · 人工智能 | 1小时前 |
- Label Studio webhook 任务完成回调的签名处理
- 459浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 | mcp · MCP 资源订阅 notifications/resources/updated subscriptions/listen
- MCP 资源订阅变更通知的客户端处理
- 369浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 | mcp · AI工程 · MCP 长任务 progress token 进度通知 智能体协议
- MCP progress token 长任务进度回报的实现
- 367浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- Gemini API 预估 token 与使用量元数据的区分
- 254浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- MLflow signature required 字段的输入收窄
- 202浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- Ray Serve DeploymentHandle 的异步批处理
- 307浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 | 人工智能 · ONNX Runtime IOBinding 设备内存复用
- ONNX Runtime IOBinding 的设备内存复用
- 412浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 | JAX PyTree register_pytree_node register_dataclass jax.jit
- JAX PyTree 自定义数据结构的注册方法
- 156浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- PyTorch DistributedSampler 每轮 shuffle 的复现配置
- 241浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 | 文本对齐 Transformers tokenizer offset_mapping Fast tokenizer
- Transformers tokenizer offset mapping 的原文区间对齐
- 423浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- Hugging Face Datasets unique 怎样列出字段的不同取值
- 469浏览 收藏
-
- 科技周边 · 人工智能 | 19小时前 |
- ONNX Runtime SessionOptions 怎样控制推理会话线程数
- 351浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 754次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 752次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 833次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 798次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 633次使用
-
- golang时间及时间戳的获取转换
- 2022-12-27 243浏览
-
- golang 实现时间戳和时间的转化
- 2023-01-25 145浏览
-
- golang时间字符串和时间戳转换的案例
- 2022-12-27 234浏览
-
- golang的time包:秒、毫秒、纳秒时间戳输出方式
- 2023-02-16 121浏览
-
- golang 使用time包获取时间戳与日期格式化操作
- 2022-12-23 310浏览


