
Go io.Pipe 的生产者消费者错误传播
用 io.Pipe 把一个生产者接到一个消费者时,最容易误判的是“写入成功”与“业务处理成功”之间的关系。它没有内部缓冲队列:Write 会等待读端把本次数据接走。因此,生产失败应该由写端调用 CloseWithError 传给读端;读端提前放弃时,也应关闭自己的半边,让生产者从阻塞的 Write 中返回。
官方地址:https://pkg.go.dev/io#Pipe
正常结束用Close产生io.EOF;异常结束用对应半边的CloseWithError传递真实错误。不要只关闭管道后丢掉错误,也不要让一端退出而另一端继续等待。
io.Pipe 为什么会让生产者等待
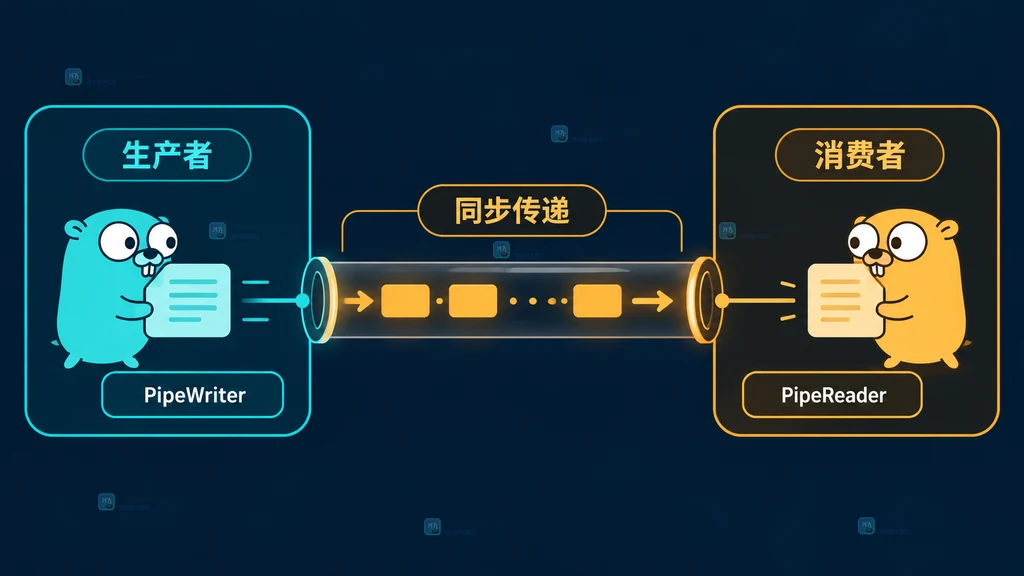
io.Pipe() 返回一对同步连接的 *io.PipeReader 和 *io.PipeWriter。写入端的数据要被读端消费后,Write 才能完成;如果读端尚未开始读取,生产者可能停在写入调用上。这种特性适合把编码器、压缩器或分块生成器直接接给上传逻辑,但它不是用来积压突发数据的缓存。
package main

import (
	"fmt"
	"io"
)

func main() {
	reader, writer := io.Pipe()

	go func() {
		// Write 会等待读端消费本次数据后才返回。
		_, err := writer.Write([]byte("order-42"))
		if err != nil {
			fmt.Println("producer:", err)
			return
		}
		// 正常结束由写端关闭,读端随后会收到 io.EOF。
		_ = writer.Close()
	}()

	buf := make([]byte, 32)
	n, err := reader.Read(buf)
	fmt.Printf("data=%q err=%v\n", buf[:n], err)
}
这里的关键不是把数据写进去,而是让两端都拥有明确的结束路径。写端正常关闭后,读端会在剩余数据读完时看到 io.EOF;如果读端提前关闭,写端的 Write 会收到关闭相关错误。
由写端把生产错误传给消费者
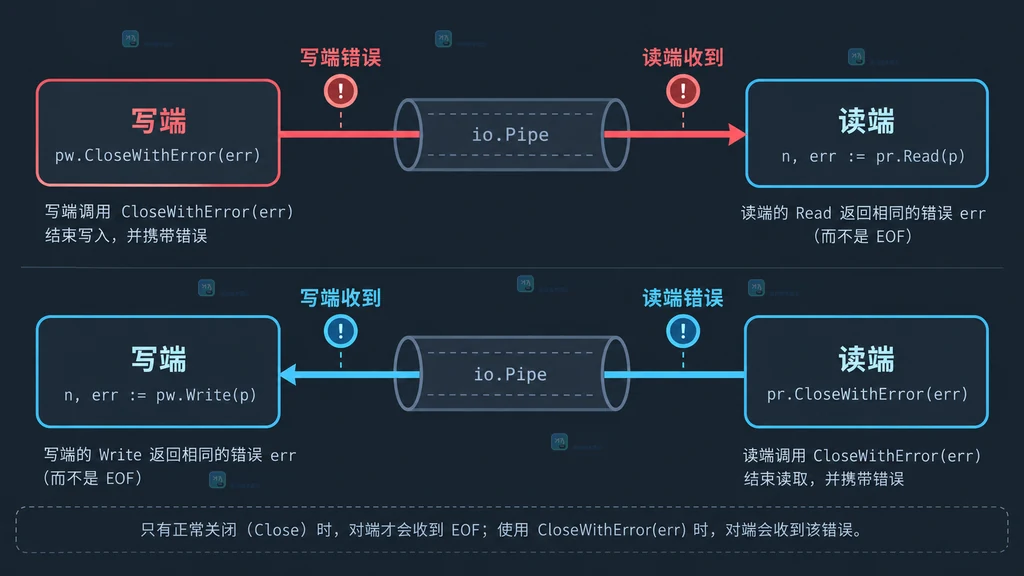
生产者通常负责读取文件、生成压缩流或转换记录。只要中途发生错误,就不要直接返回让读端永远等下去,而是调用 writer.CloseWithError(err)。官方文档定义了这个方向:之后的 Read 会返回该错误,而不是把它伪装成 EOF。
func produce(writer *io.PipeWriter) {
	defer writer.Close()

	for i := 0; i
同一个半边的关闭状态只保留第一次有效的关闭错误,后续关闭不会覆盖已经记录的错误。因此,调用方应尽量在最接近根因的位置传入原始错误;不要先用一个泛化错误关闭,再期待后面补写细节。
读端提前退出时,怎样让生产者停下来
消费者可能只需要前几条记录,或者发现响应已经取消。此时如果只从函数返回而不关闭 PipeReader,生产者下一次 Write 仍可能等待。读端可以用 CloseWithError 把“停止消费”的原因传回写端。
func consumeFirst(reader *io.PipeReader) error {
	defer reader.Close()

	buf := make([]byte, 64)
	if _, err := reader.Read(buf); err != nil {
		return err
	}
	// 业务只需要一块数据,明确通知生产者停止写入。
	stopErr := errors.New("消费者已完成所需数据")
	_ = reader.CloseWithError(stopErr)
	return nil
}

func produceUntilStopped(writer *io.PipeWriter) error {
	defer writer.Close()
	for {
		if _, err := writer.Write(nextChunk()); err != nil {
			// 这里能收到读端的停止原因,及时结束生产循环。
			return fmt.Errorf("producer stopped: %w", err)
		}
	}
}
这条路径的判断重点是:写端拿到的错误代表“读端已经关闭或拒绝继续接收”,不一定是生产数据本身损坏。日志中应把两类错误区分开,避免把正常的消费取消误报成上游故障。
用一个协调函数收口两端生命周期
实际代码里,最稳妥的做法是让一个协调层同时负责启动生产协程、消费数据、关闭读端以及等待生产协程结束。下面的示例把生产错误和读端退出都收敛到一个结果中;代码中的 nextChunk 代表真实业务的分块生成函数。
func pipeJob() error {
	reader, writer := io.Pipe()
	producerDone := make(chan error, 1)

	go func() {
		// 生产协程只负责写入,并把最终结果送回协调层。
		producerDone
示例的核心是“谁发现问题,谁负责解除等待”:生产者发现上游错误就通过写端传播;消费者发现自己不能继续就关闭读端;协调层等待生产协程回收,避免后台 goroutine 脱离生命周期。
几个容易混淆的边界
| 场景 | 推荐动作 | 另一端观察到的结果 |
|---|---|---|
| 生产者正常写完 | PipeWriter.Close() | 读完剩余数据后得到 io.EOF |
| 生产者生成失败 | PipeWriter.CloseWithError(err) | Read 返回该错误 |
| 消费者提前退出 | PipeReader.CloseWithError(err) | 后续 Write 返回该错误 |
| 一端已经关闭 | 停止继续读写并回收 goroutine | 可能得到关闭错误,不应继续重试同一管道 |
另外,io.Pipe 的同步特性意味着写端没有缓冲来吸收速度差。需要排队或解耦时,应在架构层选择带容量的通道或专用队列;不要靠启动更多生产 goroutine 来掩盖没有消费者的问题。
采用前的速查结论
- 把
Close留给正常结束,把CloseWithError留给需要传递的异常或取消原因。 - 读端只消费部分数据时,必须关闭
PipeReader,否则写端可能永久卡在下一次Write。 - 不要把读到的非 EOF 错误当成普通结束;它通常是生产端显式传来的根因。
- 用 channel 或其他协调方式等待生产协程结束,保证错误不会只停留在后台日志里。
相关问题
io.Pipe 有缓存吗?没有,它把读写直接同步配对,写入不会像带缓冲队列那样立即返回。
为什么读端收到的是 EOF?通常表示写端用普通 Close 正常结束,且剩余数据已经读完。
CloseWithError(nil) 会怎样?对写端来说等价于关闭后让读端得到 EOF;它不适合表达一个真实失败原因。
 Go net/http MaxBytesReader 的请求体上限控制
- 上一篇
- Go net/http MaxBytesReader 的请求体上限控制
- 下一篇
- Go bufio.Reader.Discard 的部分跳过与 EOF 处理方案
-
- Golang · Go教程 | 1小时前 |
- Go parser.ParseComments 怎样让 AST 保留源码注释
- 413浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go os.ReadFile 与 Open 的大文件选择
- 114浏览 收藏
-
- Golang · Go教程 | 1小时前 | go · bufio ·
- Go bufio.Reader.Discard 的部分跳过与 EOF 处理方案
- 199浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go net/http MaxBytesReader 的请求体上限控制
- 474浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go AppendQuoteRuneToASCII 怎样向切片追加字符转义文本
- 372浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- Go cipher.NewGCMWithRandomNonce 怎样让 Seal 自动携带随机 nonce
- 304浏览 收藏
-
- Golang · Go教程 | 2小时前 |
- Go image/draw 的偏移画布绘制方案
- 294浏览 收藏
-
- Golang · Go教程 | 2小时前 | go · 连接池 · database/sql ·
- Go sql.DB.SetConnMaxLifetime 的连接轮换配置方法
- 332浏览 收藏
-
- Golang · Go教程 | 2小时前 |
- Go cipher.StreamReader 怎样把流式解密接到 io.Reader
- 270浏览 收藏
-
- Golang · Go教程 | 3小时前 |
- Go TurkishCase 怎样转换带点和不带点的字母I
- 247浏览 收藏
-
- Golang · Go教程 | 3小时前 |
- Go gosym.PCToFunc 怎样查询地址所属的函数
- 390浏览 收藏
-
- Golang · Go教程 | 4小时前 | go · go tool trace Go trace -d=parsed
- Go trace -d=parsed 的事件解析输出方案
- 459浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 747次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 741次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 825次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 793次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 621次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览


