
Go x/text/collate Buffer.Reset 后排序键为什么不能继续保存
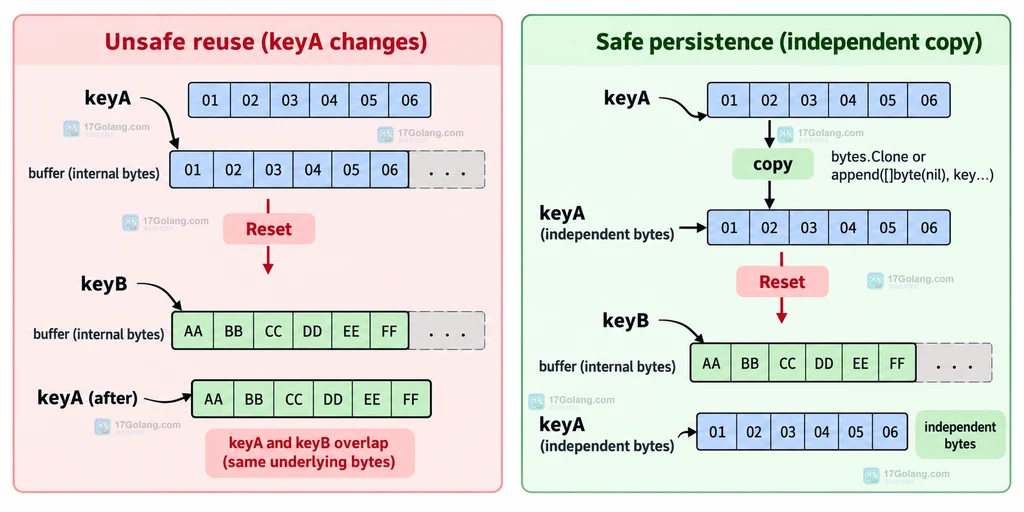
如果你用 golang.org/x/text/collate 生成排序键,再调用 Buffer.Reset() 后继续保存旧的 []byte,问题不在排序规则,而在切片的生命周期:官方文档明确说明,Key 和 KeyFromString 返回的切片只保证在下一次 Reset 之前有效。Reset 会清空可复用缓冲区,之后同一个 Buffer 可以覆盖原来的字节。
官方地址:https://pkg.go.dev/golang.org/x/text/collate
只在当前批次内使用排序键,可以让它们共享一个未重置的 Buffer;需要跨批次、异步任务或缓存长期保存时,应在 Reset 前复制 key,或者直接使用 Collator 的比较方法。
KeyFromString 返回的不是独立副本
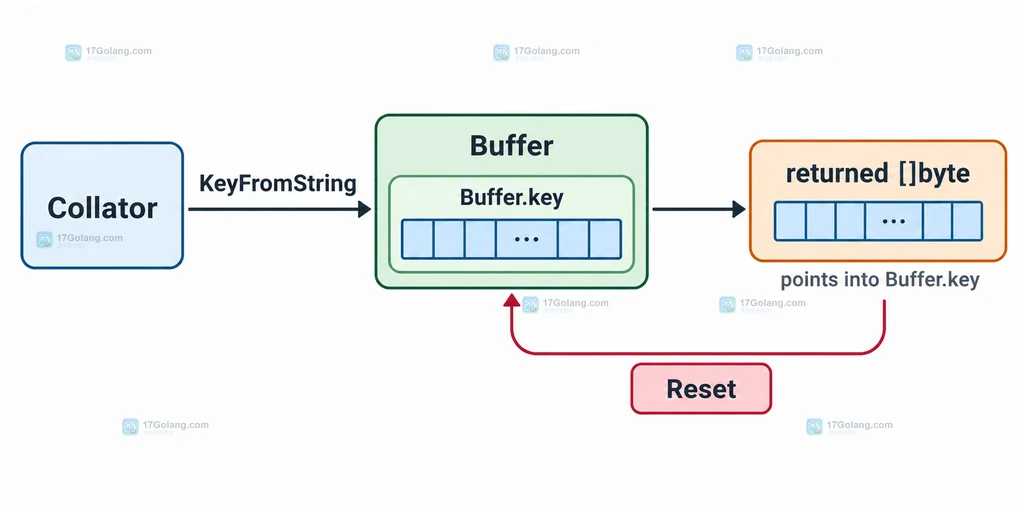
collate.Collator 负责按照语言环境比较 Unicode 字符串。调用 KeyFromString 时,传入的 Buffer 用来承接生成后的排序权重,返回值只是 Buffer 中那一段字节的切片视图。
这样设计的好处是可以减少大量短字符串排序时的分配,但代价是返回值的所有权仍然属于 Buffer。把返回值放进结构体、map 或缓存,并不会自动把底层数组复制出来。
Reset 为什么会让旧排序键失效
从使用者角度看,Reset 并不是把每个字节都擦成零,而是让 Buffer 的下一次写入从头复用已有存储。因此,旧切片仍可能保留原来的长度,却不再享有“内容保持不变”的保证。
下面的示例故意把第一个 key 放过 Reset 再观察它。注释中的“可能变化”是生命周期契约,不应依赖某一次运行恰好打印出的字节:
package main

import (
	"fmt"

	"golang.org/x/text/collate"
	"golang.org/x/text/language"
)

func main() {
	c := collate.New(language.English)
	var buf collate.Buffer

	keyA := c.KeyFromString(&buf, "angstrom")
	// Reset 让下一次生成从可复用缓冲区的起点开始。
	buf.Reset()
	keyB := c.KeyFromString(&buf, "zebra")

	fmt.Printf("keyA=%x keyB=%x\n", keyA, keyB)
	// keyA 已越过文档承诺的有效期,不能再据此判断排序结果。
}
这里最容易误判的是:keyA 这个变量本身没有自动变成 nil,所以程序通常还能打印它。但切片只保存指针、长度和容量,底层数组已经重新交给 Buffer 使用;一旦后续写入覆盖那段空间,keyA 的内容就可能跟着变化。
批量排序时怎样安全复用 Buffer
如果所有排序键只在一次排序过程中使用,可以让它们连续写入同一个 Buffer,并把 Reset 放在整个批次完成之后。不要在每一条记录之间 Reset,否则前面已经保存的 key 会进入失效边界。
package main

import (
	"bytes"
	"fmt"
	"sort"

	"golang.org/x/text/collate"
	"golang.org/x/text/language"
)

type item struct {
	name string
	key  []byte
}

func main() {
	c := collate.New(language.English)
	items := []item{{name: "zebra"}, {name: "angstrom"}, {name: "apple"}}
	var buf collate.Buffer

	for i := range items {
		// 同一批次不 Reset,所有 key 都留在 Buffer 的不同区间内。
		items[i].key = c.KeyFromString(&buf, items[i].name)
	}
	sort.SliceStable(items, func(i, j int) bool {
		// key 只在本次排序中读取,比较结束前 Buffer 仍未 Reset。
		return bytes.Compare(items[i].key, items[j].key)
这个模式的关键不是“永远不能 Reset”,而是把 Reset 当成一个明确的所有权边界:排序闭包、比较函数和任何延迟读取都必须在边界之前完成。
需要长期保存时先复制排序键
如果排序键要放到跨请求缓存、索引结构或异步任务中,就不能依赖共享 Buffer。复制动作应该紧跟在生成动作之后,使保存的切片拥有自己的底层数组。
package main

import (
	"bytes"
	"fmt"

	"golang.org/x/text/collate"
	"golang.org/x/text/language"
)

type savedKey struct {
	text string
	key  []byte
}

func makeSavedKey(c *collate.Collator, buf *collate.Buffer, text string) savedKey {
	key := c.KeyFromString(buf, text)
	// append 到 nil 切片会分配独立存储,切断与 Buffer 的共享关系。
	owned := append([]byte(nil), key...)
	return savedKey{text: text, key: owned}
}

func main() {
	c := collate.New(language.English)
	var buf collate.Buffer

	first := makeSavedKey(c, &buf, "angstrom")
	buf.Reset()
	second := makeSavedKey(c, &buf, "zebra")
	buf.Reset()

	// 两份 key 已经独立保存,后续 Reset 不会改变它们。
	fmt.Println(bytes.Compare(first.key, second.key)
复制会增加一次内存和拷贝成本,因此它适合“必须把排序键留到 Buffer 生命周期之外”的场景。若只是比较两个字符串,没有缓存 key 的需要,直接调用 CompareString 通常更简单:
// 只需要比较,不保存排序键时直接让 Collator 完成比较。
if c.CompareString(left, right)
四个常见误区
| 误区 | 实际边界 | 建议 |
|---|---|---|
| Reset 只影响 Buffer,不影响旧 key | 旧 key 指向 Buffer 的存储,Reset 后有效性不再保证 | 跨 Reset 保存就复制 |
| 每条记录生成后都 Reset | 前面记录的 key 可能被后续生成覆盖 | 批量排序结束后再 Reset |
| 把 key 放进 map 就获得了所有权 | map 只保存切片描述符,不会深拷贝底层数组 | 写入 map 前复制字节 |
| 异步 goroutine 可以稍后读取 | 异步读取可能发生在 Reset 或下一轮写入之后 | 交给 goroutine 前复制或等待同步完成 |
排查时按这条生命周期检查
- 先确认返回值来自
Key还是KeyFromString,并找到它使用的Buffer。 - 向后查找第一次
Reset、下一次生成 key、对象归还池或异步发送的位置。 - 如果旧 key 会越过这些边界,检查是否使用了
append([]byte(nil), key...)之类的深拷贝。 - 如果程序只是比较字符串,删除不必要的 key 缓存,改用
Compare或CompareString。
最终可以把规则压缩成一句话:Buffer 负责复用,返回的排序键负责当前生命周期内读取;一旦要跨过 Reset,就必须由调用方复制所有需要继续保存的字节。
相关问题
Buffer.Reset 会把排序键切片长度变成零吗?
不会自动修改调用方手里的切片头,但它会清空 Buffer 的内部写入长度,并结束官方对旧返回切片内容的有效性承诺。不要用“还能打印”推断“仍然有效”。
同一个 Buffer 可以保存多个排序键吗?
可以,只要这些 key 都在同一次 Reset 之前使用,并且后续写入没有越过它们的容量范围;更稳妥的做法是把它们当作当前批次的临时视图。
复制排序键后还需要保留 Buffer 吗?
不需要。复制完成后,保存的字节已经独立于 Buffer;Buffer 可以在当前调用结束时 Reset 并继续复用。
 Go x/text/encoding/charmap DecodeByte 为什么不需要处理多字节边界
- 上一篇
- Go x/text/encoding/charmap DecodeByte 为什么不需要处理多字节边界
- 下一篇
- Go x/net/idna.ToASCII 为什么与直接转小写不同
-
- Golang · Go问答 | 12分钟前 |
- Go x/text/encoding/charmap 编码器为什么无法表示某些 Unicode 字符
- 465浏览 收藏
-
- Golang · Go问答 | 13分钟前 |
- Go x/text/currency 现金舍入位数为什么可能不同于记账位数
- 316浏览 收藏
-
- Golang · Go问答 | 14分钟前 |
- Go debug/dwarf Entry.Children 为什么不是子节点数量
- 388浏览 收藏
-
- Golang · Go问答 | 16分钟前 |
- Go x/text/cases NoLower 为什么保留单词后续字母
- 499浏览 收藏
-
- Golang · Go问答 | 16分钟前 | Go x/text/collate IgnoreCase
- Go x/text/collate IgnoreCase 为什么不等于忽略所有差异
- 322浏览 收藏
-
- Golang · Go问答 | 20分钟前 |
- Go x/image/font/opentype Hinting 设置为什么影响小字号形状
- 142浏览 收藏
-
- Golang · Go问答 | 21分钟前 |
- Go x/image/riff Next 后旧块 Reader 为什么不能继续使用
- 490浏览 收藏
-
- Golang · Go问答 | 24分钟前 |
- Go x/image/font/sfnt UnitsPerEm 为什么不是输出图片字号
- 242浏览 收藏
-
- Golang · Go问答 | 27分钟前 |
- Go x/text/width Fold 为什么不等于 Unicode NFC
- 181浏览 收藏
-
- Golang · Go问答 | 28分钟前 |
- Go x/text/unicode/norm 规范化后的字节长度为什么可能变大
- 232浏览 收藏
-
- Golang · Go问答 | 30分钟前 |
- Go x/net/ipv4.PacketConn 为什么区分控制信息与数据载荷
- 420浏览 收藏
-
- Golang · Go问答 | 30分钟前 |
- Go x/text/unicode/bidi 右向文本为什么不能简单调用字符串反转
- 438浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 724次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 733次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 808次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 769次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 609次使用
-
- 用Nginx反向代理部署go写的网站。
- 2023-01-17 502浏览
-
- GoLand调式动态执行代码
- 2023-01-13 502浏览
-
- Go os.File.ReadAt 为什么到文件末尾仍返回部分数据
- 2026-10-26 501浏览
-
- Go JSONJSON null 解码到指针后状态不符合预期怎么办
- 2026-10-18 501浏览
-
- Go crypto/rand.Text 的长度为什么不是固定字符数
- 2026-10-04 501浏览


