
Go x/text/encoding/unicode UTF16 怎样配置字节序与 BOM 策略
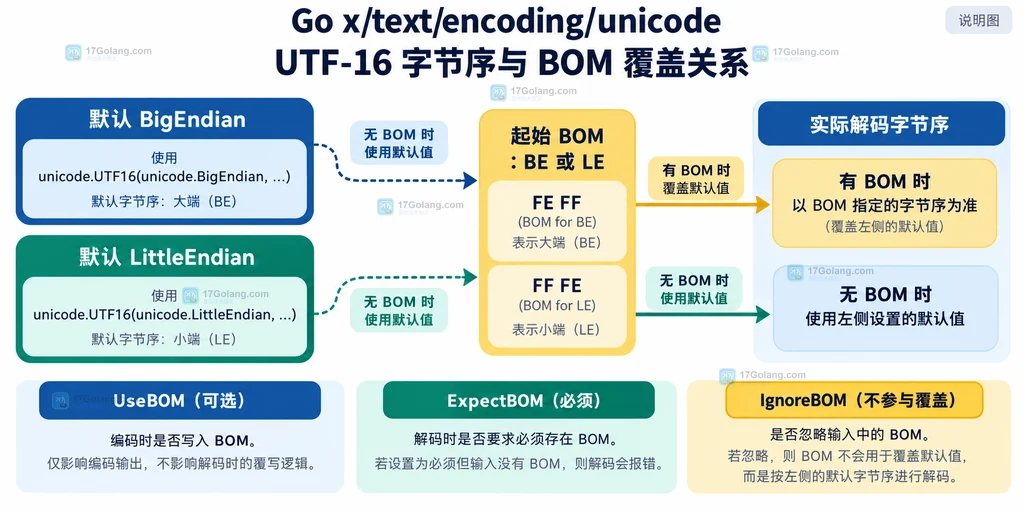
Go 处理 UTF-16 时,先确定两个问题:数据协议默认采用大端还是小端,以及文件开头是否允许或要求 BOM。golang.org/x/text/encoding/unicode 把这两个决定拆成 UTF16(e, b) 的两个参数:e 是默认字节序,b 是 BOM 策略。写出协议文件通常选 UseBOM 或 ExpectBOM;协议已经明确字节序且不使用 BOM 时选 IgnoreBOM。
最容易记住的规则是:没有外部协议保证时,让 BOM 参与识别并统一写出;协议已经明确 UTF-16BE 或 UTF-16LE 时,忽略 BOM,避免把数据中的 U+FEFF 当成字节序信号。
官方文档:https://pkg.go.dev/golang.org/x/text/encoding/unicode
先把字节序和 BOM 拆成两个决定
字节序决定一个 UTF-16 码元的两个字节如何排列。BigEndian 表示 UTF-16BE,LittleEndian 表示 UTF-16LE。它只是“没有被 BOM 覆盖时”的默认值,不代表系统本机字节序;官方包没有所谓 native endian。
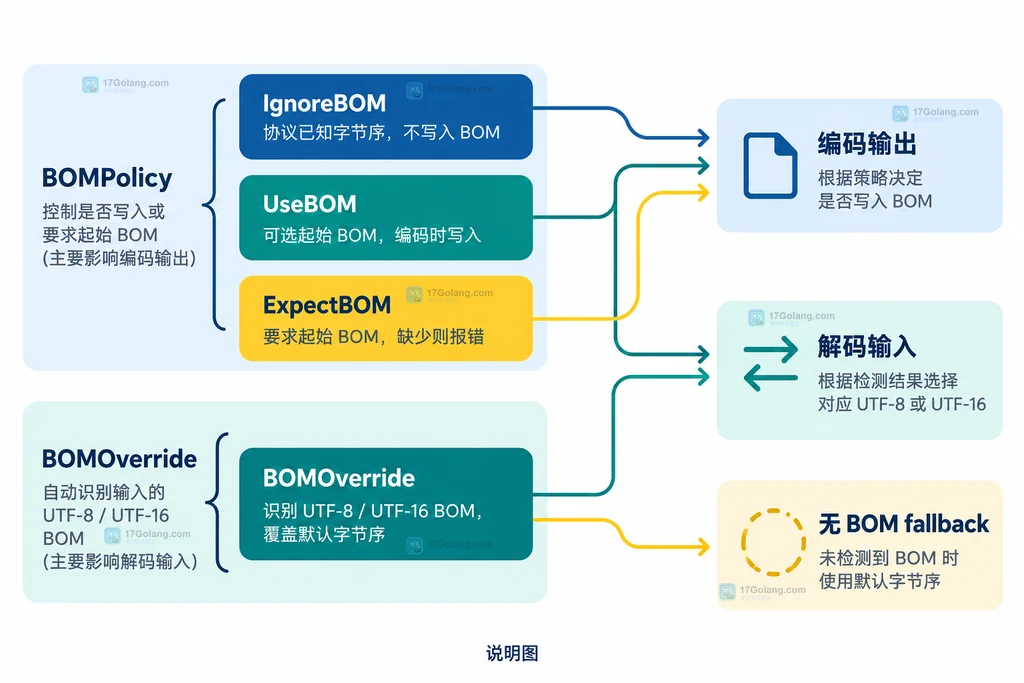
BOMPolicy 则决定输入开头的 BOM 怎么处理,以及编码输出时要不要写 BOM:
| 策略 | 解码行为 | 编码行为 | 适合场景 |
|---|---|---|---|
IgnoreBOM | 不让 BOM 改变字节序,BOM 会按普通字符输出 | 不写 BOM | 协议已明确 BE/LE |
UseBOM | 有起始 BOM 就覆盖默认字节序,没有则用默认值 | 写入 BOM | 兼容可选 BOM 的文件 |
ExpectBOM | 必须有起始 BOM,否则返回 ErrMissingBOM | 写入 BOM | 协议强制 BOM |
三种 BOMPolicy 解决的是不同协议
IgnoreBOM 不是“自动判断没有 BOM 的 UTF-16”,而是明确告诉解码器:输入类型已经由外部协议确定,任何 BOM 都不要拿来切换字节序。此时输入中的 U+FEFF 和 U+FFFE 会按普通 UTF-8 字节序列输出。
UseBOM 比较适合兼容性优先的文件交换:编码端主动写 BOM,解码端如果看到起始 BOM 就使用它指示的字节序,否则回退到传入的默认值。ExpectBOM 更严格,缺少 BOM 就停止转换并给出 ErrMissingBOM,适合协议把 BOM 作为必选头部的场景。
下面的构造函数只是配置,不依赖本机大小端,也不会替你判断业务协议:
package main

import "golang.org/x/text/encoding/unicode"

func main() {
	// 文件协议明确要求 UTF-16LE,且不使用 BOM 时,固定小端并忽略 BOM。
	withoutBOM := unicode.UTF16(unicode.LittleEndian, unicode.IgnoreBOM)

	// 允许文件用 BOM 指示实际字节序;没有 BOM 时回退到大端。
	optionalBOM := unicode.UTF16(unicode.BigEndian, unicode.UseBOM)

	// 协议要求必须有 BOM,缺少时解码会返回 unicode.ErrMissingBOM。
	requiredBOM := unicode.UTF16(unicode.BigEndian, unicode.ExpectBOM)

	_, _, _ = withoutBOM, optionalBOM, requiredBOM
}
用 Encoder 和 Decoder 读写 UTF-16
编码对象实现了 encoding.Encoding。实际转换时可以取它的 NewEncoder 或 NewDecoder,再配合 transform.Bytes 一次性处理内存字节。下面示例把 UTF-8 字符串编码成带 BOM 的 UTF-16LE,再按同一规则解码回来。
package main

import (
	"fmt"

	"golang.org/x/text/encoding/unicode"
	"golang.org/x/text/transform"
)

func main() {
	enc := unicode.UTF16(unicode.LittleEndian, unicode.UseBOM)

	// 编码端从 UTF-8 字符串生成 UTF-16LE;UseBOM 会在输出开头写 BOM。
	raw, _, err := transform.Bytes(enc.NewEncoder(), []byte("配置文件:默认小端"))
	if err != nil {
		// 转换失败时立即停止,避免把不完整字节流当成成功结果保存。
		panic(err)
	}

	// 解码端会识别起始 BOM,并让它覆盖默认字节序。
	text, _, err := transform.Bytes(enc.NewDecoder(), raw)
	if err != nil {
		// 读取外部文件时应把错误返回给调用方,而不是静默替换乱码。
		panic(err)
	}
	fmt.Println(string(text))
}
如果数据量很大,不要一次性把整份文件放进内存,可以把 NewDecoder() 或 NewEncoder() 接到 transform.NewReader、transform.NewWriter,让转换随着读取或写入进行。
混合输入用 BOMOverride 处理
有些入口接收的是未知编码文本:常见输入可能是 UTF-8、UTF-16BE 或 UTF-16LE,且开头的 BOM 比外部配置更可靠。此时可以用 BOMOverride 包住一个 fallback transformer。它只检查输入开头的 BOM,识别到 UTF-8、UTF-16BE 或 UTF-16LE 后切换到对应 Unicode 解码;没有 BOM 时继续使用 fallback。
package main

import (
	"fmt"

	"golang.org/x/text/encoding"
	"golang.org/x/text/encoding/unicode"
	"golang.org/x/text/transform"
)

func decodeText(data []byte) ([]byte, error) {
	// 无 BOM 时按 UTF-8 处理;已知输入首字符不会伪装成 BOM 时才适合这样回退。
	fallback := encoding.Nop.NewDecoder()
	decoder := unicode.BOMOverride(fallback)

	// BOMOverride 负责选择解码器,transform.Bytes 负责完成字节转换。
	decoded, _, err := transform.Bytes(decoder, data)
	if err != nil {
		// 保留原始错误,让上层决定是否拒绝这份输入。
		return nil, err
	}
	return decoded, nil
}

func main() {
	text, err := decodeText([]byte("普通 UTF-8 输入"))
	if err != nil {
		panic(err)
	}
	fmt.Println(string(text))
}
兼容注意:不要把乱码都归因于 BOM
第一,确认数据真的是 UTF-16。UTF-8 文件中的 BOM 是三字节序列,不能直接按 UTF-16 解码。第二,确认 BOM 出现在整个输入的开头;如果前面已有包装协议、空白或自定义头部,BOMOverride 不会在任意偏移处扫描。第三,ExpectBOM 的 ErrMissingBOM 是协议不满足的信号,不应该用替换字符掩盖。
如果业务已经从文件头、HTTP 头或协议字段拿到了明确的 UTF-16BE/LE 类型,优先使用 IgnoreBOM,并把字节序写进接口契约。相反,如果文件可能来自不同工具且 BOM 是约定入口,就使用 UseBOM;只有在 BOM 缺失必须拒绝时才使用 ExpectBOM。
- 明确协议:
UTF16(unicode.BigEndian, unicode.IgnoreBOM)或小端对应配置。 - 可选 BOM:用
UseBOM,默认字节序只负责无 BOM 的回退。 - 强制 BOM:用
ExpectBOM,把ErrMissingBOM当成输入错误处理。 - 多种 Unicode 输入:用
BOMOverride,并为无 BOM 输入明确 fallback。
常见问题
LittleEndian 是不是当前机器的本机字节序?
不是。它只是 UTF-16 没有被 BOM 覆盖时使用的默认字节序,代码应按数据协议选择。
UseBOM 和 ExpectBOM 的主要区别是什么?
两者编码时都会写 BOM;解码时 UseBOM 缺少 BOM 会回退到默认字节序,ExpectBOM 缺少 BOM 会返回 ErrMissingBOM。
IgnoreBOM 会自动丢弃文件开头的 BOM 吗?
不会。它不让 BOM 影响字节序,输入中的相关码元会按普通字符参与输出;只有 UseBOM 或 ExpectBOM 才把起始 BOM 当作字节序信号并从 UTF-8 输出中排除。
什么时候应该使用 BOMOverride?
当输入可能是带 BOM 的 UTF-8、UTF-16BE 或 UTF-16LE,并且无 BOM 时有一个可信的 fallback 编码时使用。它适合兼容多种 Unicode 文件,不适合把未知的任意编码都交给 BOM 猜测。
 Go x/text/encoding/simplifiedchinese GB18030 怎样转换四字节字符
- 上一篇
- Go x/text/encoding/simplifiedchinese GB18030 怎样转换四字节字符
- 下一篇
- Go x/text/encoding/unicode/utf32 UTF32 怎样解码小端字节流
-
- Golang · Go教程 | 19分钟前 |
- Go x/text/secure/precis OpaqueString 怎样准备区分大小写的口令文本
- 367浏览 收藏
-
- Golang · Go教程 | 22分钟前 |
- Go x/text/secure/bidirule New 怎样接入双向规则转换器
- 440浏览 收藏
-
- Golang · Go教程 | 25分钟前 |
- Go x/text/search IgnoreDiacritics 怎样匹配带重音文本
- 121浏览 收藏
-
- Golang · Go教程 | 25分钟前 |
- Go x/text/number Percent 怎样格式化比例数值
- 330浏览 收藏
-
- Golang · Go教程 | 25分钟前 |
- Go x/text/runes Map 怎样替换指定 Unicode 字符
- 317浏览 收藏
-
- Golang · Go教程 | 27分钟前 |
- Go x/text/message SetString 怎样登记翻译消息
- 221浏览 收藏
-
- Golang · Go教程 | 31分钟前 |
- Go x/text/language Matcher 怎样协商站点支持的语言
- 425浏览 收藏
-
- Golang · Go教程 | 33分钟前 |
- Go imports.Process 怎样补全源码片段的导入
- 148浏览 收藏
-
- Golang · Go教程 | 33分钟前 |
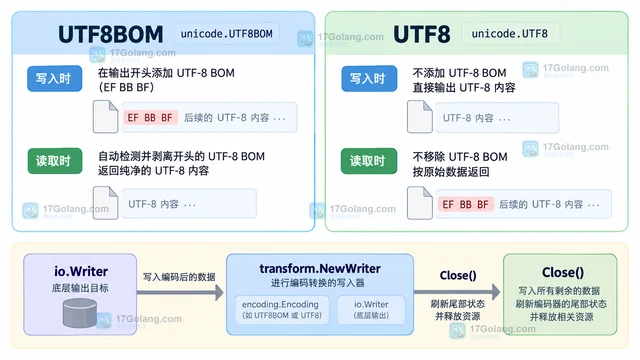
- Go x/text/encoding/unicode UTF8BOM 怎样输出带签名字节
- 384浏览 收藏
-
- Golang · Go教程 | 36分钟前 |
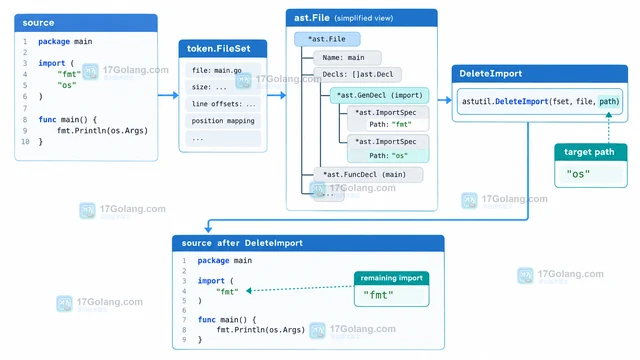
- Go astutil.DeleteImport 怎样移除指定导入路径
- 142浏览 收藏
-
- Golang · Go教程 | 40分钟前 |
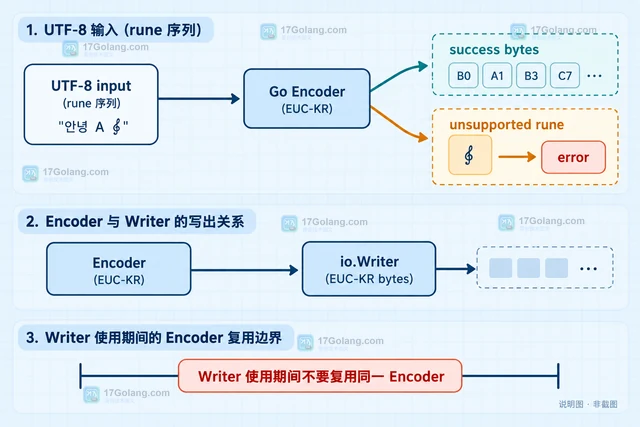
- Go x/text/encoding/korean NewEncoder 怎样生成韩文编码输出
- 352浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 722次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 731次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 805次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 768次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 606次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览


