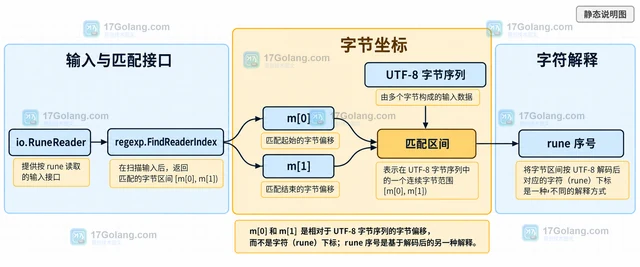
在 Go 里用 json.Decoder 连续读取多个 JSON 值时,InputOffset 返回的是“最近一次成功返回的 token 结束位置,也是下一个 token 的起点”。它是输入流的字节偏移,不是字符下标,也不等于底层 Reader 已经从数据源读取的字节数。
官方地址:https://pkg.go.dev/encoding/json#Decoder.InputOffset
如果要记录流式 JSON 的当前位置,先在Decode或Token成功之后读取InputOffset;如果要定位语法错误,再结合原始字节和json.SyntaxError.Offset转换行列。
InputOffset 到底指向哪个位置
官方定义把位置锚定在最近一次返回的 token 之后。例如输入中连续放着两个 JSON 值,第一次 Decode 成功后,偏移落在第一个值的末尾;下一次成功后,偏移才移动到第二个值的末尾。开头的空白、逗号和换行也会占用字节,但不会被当成 token 返回。
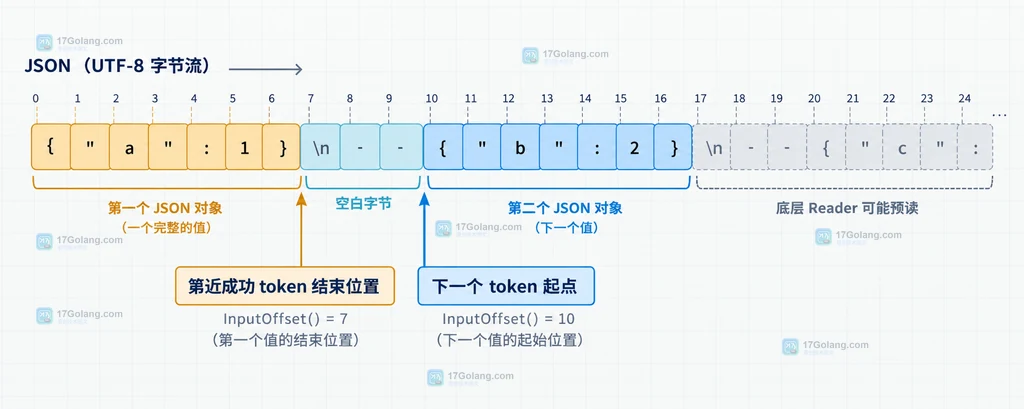
这一区别很重要:如果日志写成“底层 Reader 已经读到 offset”,读者会误以为 Decoder 没有预读。实际上 Decoder 会自行缓冲,底层读取量可能比当前位置更大。
连续 Decode 时怎样记录每个值的结束位置
对多值 JSON 流,最简单的做法是每次成功解码后马上读取偏移,并把它和业务序号一起写入日志。下面的示例把每个对象的结束字节位置保存下来:
package main

import (
    "encoding/json"
    "fmt"
    "io"
    "strings"
)

type Event struct {
    Name string `json:"name"`
}

func main() {
    input := `{"name":"start"}
{"name":"finish"}`
    dec := json.NewDecoder(strings.NewReader(input))

    for index := 1; ; index++ {
        var event Event
        // 每次只消费一个 JSON 值,便于把业务序号和结束偏移绑定。
        err := dec.Decode(&event)
        if err == io.EOF {
            // 输入正常结束,不把 EOF 当作一条坏记录。
            break
        }
        if err != nil {
            // 解码失败时保留当前序号,后续可结合原始输入定位。
            fmt.Printf("record=%d decode_error=%v offset=%d\n", index, err, dec.InputOffset())
            break
        }

        // InputOffset 是最近成功值结束后的输入字节偏移。
        fmt.Printf("record=%d name=%s end_offset=%d\n", index, event.Name, dec.InputOffset())
    }
}
这里的 end_offset 适合做进度记录或故障日志。它描述的是 Decoder 的语义位置,不应该拿来判断底层网络连接已经收到了多少字节。
需要行号和列号时,先按字节扫描原文
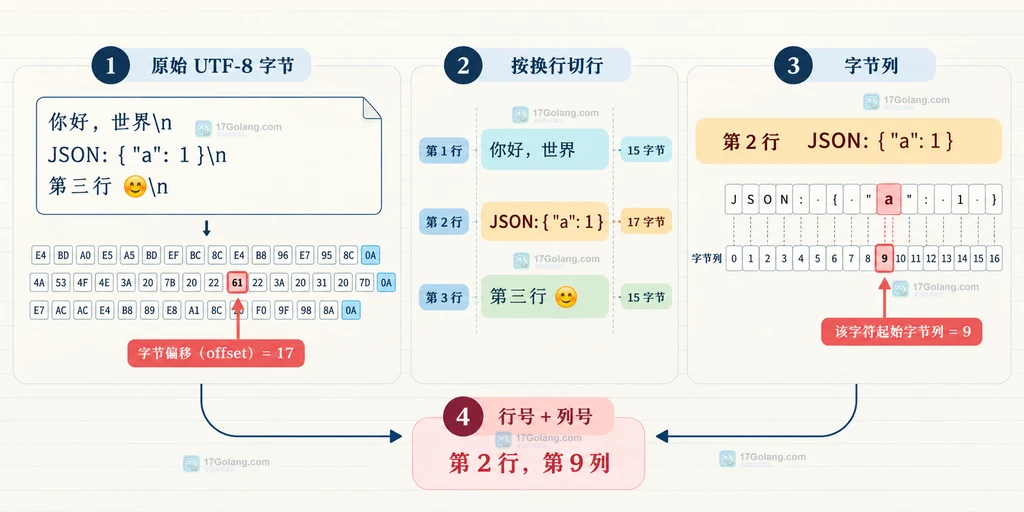
InputOffset 返回字节数,而中文或表情符号在 UTF-8 中可能占用多个字节。若日志要显示行号和列号,建议保留原始输入,再用同样的字节偏移扫描换行;不要直接把偏移转换成 Go 字符串的 rune 下标。
func lineColumn(data []byte, offset int64) (line, column int) {
    line, column = 1, 1
    // 偏移是字节位置,先限制到输入范围,避免异常输入导致越界。
    if offset < 0 {
        offset = 0
    }
    if offset > int64(len(data)) {
        offset = int64(len(data))
    }
    for _, b := range data[:offset] {
        // JSON 的行分隔通常按换行字节计算,列也保持字节列语义。
        if b == '\n' {
            line++
            column = 1
            continue
        }
        column++
    }
    return line, column
}
如果产品界面必须显示“第几个汉字”,还要在当前行的字节片段上继续做 UTF-8 解码;那是展示层转换,不要改变底层定位使用的字节偏移。
解析失败时不要把三个位置混在一起
遇到坏 JSON 时,常见的三个位置各有职责:
| 位置或接口 | 表示什么 | 适合做什么 |
|---|---|---|
Decoder.InputOffset() | 最近成功返回 token 或值之后的位置 | 记录流式解码进度、标记下一个 token 起点 |
json.SyntaxError.Offset | 语法错误附近的输入字节偏移 | 把错误转换成行列和上下文片段 |
Decoder.Buffered() | Decoder 已读入但尚未消费的内部缓冲 | 处理一个 Reader 中连续协议数据的剩余部分 |
因此,错误日志可以同时记录错误类型、语法错误偏移和最近成功的 InputOffset。若只记录其中一个,排查连续 JSON 或协议拼接问题时很容易误判。
哪些边界最容易误用
- 在
Decode返回错误前读取的偏移,不能当成“错误字符位置”;语法错误应优先检查SyntaxError.Offset。 - 把偏移当成字符数,会在中文、表情符号或其它多字节 UTF-8 输入上产生列号偏差。
- 把
InputOffset当成底层 Reader 的读取进度,会忽略 Decoder 的预读和内部缓冲。 - 修改或复用原始输入后再用旧偏移做诊断,位置就失去了对应关系;应让输入快照和偏移一起留存。
结论
InputOffset 最适合回答“Decoder 最近成功处理到哪里”。流式读取时在成功的 Decode 或 Token 后采样它;语法错误时使用 SyntaxError.Offset;需要行列时基于原始 UTF-8 字节计算。把这三个职责分开,日志既能保留稳定的字节位置,也能给人类提供可读的错误上下文。
相关问题
InputOffset 是字符下标吗?
不是。它是输入流字节偏移,UTF-8 多字节字符会让字节数和字符数不同。
Decoder 会不会一次读过下一个 JSON 值?
会。Decoder 可能从底层 Reader 预读数据,所以底层 Reader 的读取量不等于 InputOffset。
解析错误应该看 InputOffset 还是 SyntaxError.Offset?
定位语法错误优先看 SyntaxError.Offset;InputOffset 用来表示最近一次成功解码的进度。
 Go maphash.Hash.SetSeed 怎样让多个哈希器使用同一随机种子