
ReadableStream.getReader 怎样逐块读取上传数据
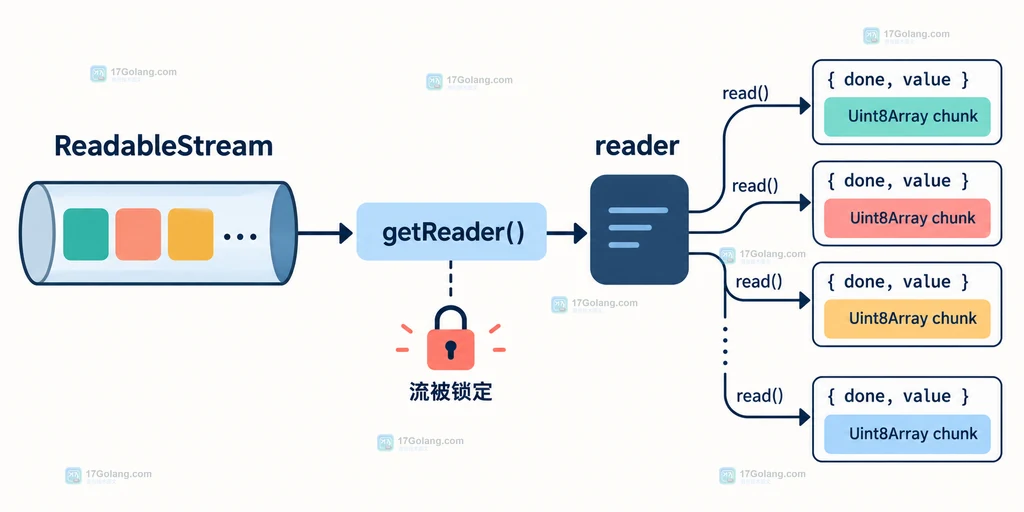
如果上传文件时不想先把整个文件拼成一个大对象,可以让读取过程保持“拿到一块、处理一块”的节奏。ReadableStream.getReader() 会为流创建一个 reader,并把流锁定给它;随后反复调用 reader.read(),每次得到一个包含 done 和 value 的结果对象。对普通文件流来说,value 通常是 Uint8Array,直到 done 变成 true。
本文使用的是浏览器原生 Streams API,官方资料入口如下:
官方资料:https://developer.mozilla.org/en-US/docs/Web/API/ReadableStream/getReader
最小可用做法是:先用const reader = stream.getReader()取得读取权,再在循环中等待reader.read();遇到done就结束。不要对同一个仍被锁定的流再次调用getReader(),也不要把一次read()当成完整文件。
先明确接口目标:每次只消费一个数据块
在上传场景里,调用方通常需要三个结果:当前已经读了多少字节、是否还有下一块数据,以及发生异常时能否停止读取。getReader() 解决的是“谁拥有这条流的读取权”,read() 解决的是“下一块什么时候可用”。它们并不替你完成服务端分片协议、重试或断点续传。
默认调用 getReader() 会得到 ReadableStreamDefaultReader。它适合直接消费普通流,每次返回一个数据块;如果显式传入 { mode: "byob" },返回的则是 BYOB reader,这要求底层是可读字节流。两种 reader 都会让流进入 locked 状态,在释放前不能被第二个 reader 接管。
从文件流逐块读取并累计进度
下面的函数只负责读取,不直接上传。把职责拆开后,读取循环可以清楚地处理三种状态:done: false 表示还有数据,done: true 表示流结束,Promise 拒绝则表示读取失败。
async function readInChunks(stream, onChunk) {
  // getReader() 会锁定流,当前函数负责在 finally 中释放读取权。
  const reader = stream.getReader();
  let totalBytes = 0;

  try {
    while (true) {
      // 每次只等待下一块数据,不假设它等于完整文件。
      const { done, value } = await reader.read();
      if (done) {
        return totalBytes;
      }

      // 普通字节流的 value 通常是 Uint8Array;空块不参与进度累计。
      if (value && value.byteLength > 0) {
        totalBytes += value.byteLength;
        await onChunk(value, totalBytes);
      }
    }
  } finally {
    // 正常结束或异常离开时都释放锁,便于后续决定是否重新取得 reader。
    reader.releaseLock();
  }
}
onChunk 可以更新进度、把数据交给业务层,或写入另一个可写流。它不应修改下一次 read() 的调用顺序;如果回调需要异步处理,使用 await 可以让内存压力和业务处理速度保持同一节奏。
把读取结果接入上传请求
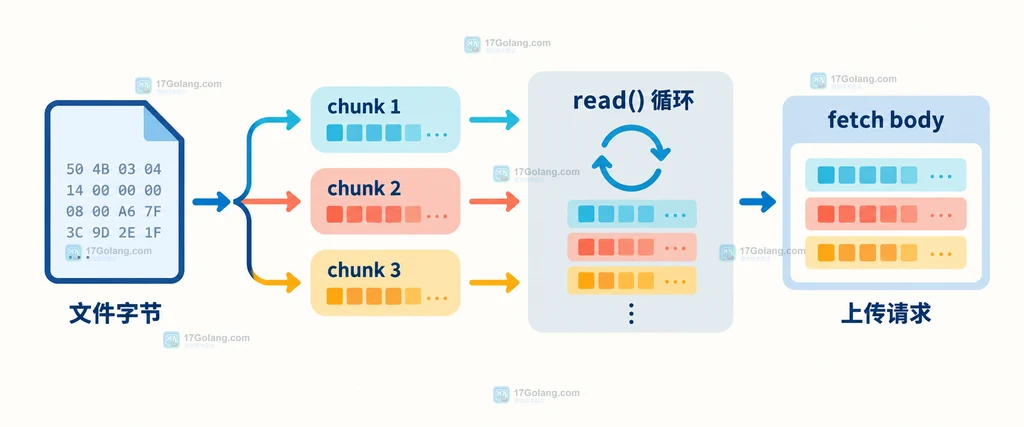
如果目标是把文件流直接作为请求体,可以把 file.stream() 交给 fetch。此时不需要手工把所有块拼成 Blob 或大数组;请求体会从流中持续读取。对于浏览器的流式请求体,常见实现需要显式写出 duplex: "half",但这属于 fetch 请求配置边界,最终仍要以目标浏览器和服务端支持矩阵为准。
async function uploadFile(file, uploadUrl) {
  // 文件流按需产生数据,避免先把整个文件复制到内存。
  const body = file.stream();

  const response = await fetch(uploadUrl, {
    method: "POST",
    headers: {
      // 服务端应按实际接口约定处理二进制请求体。
      "Content-Type": file.type || "application/octet-stream"
    },
    body,
    // 流式请求体在支持的浏览器中需要声明半双工模式。
    duplex: "half"
  });

  if (!response.ok) {
    // HTTP 失败不是读取循环的 done 状态,需要单独抛出并交给调用方处理。
    throw new Error(`上传失败:${response.status}`);
  }

  return response;
}
如果你必须在上传前显示精确的已读字节数,可以先用 reader 消费并把每块交给自定义上传管线;如果只需要把文件交给支持流式 body 的接口,直接传 file.stream() 更简单。两者不要混在同一个流上同时读取,否则会遇到锁定或数据所有权冲突。
参数设计:默认 reader 和 BYOB reader 怎么选
默认 reader 的调用最直接:
const reader = stream.getReader();
// 默认 reader 面向普通流,value 由流在每次读取时提供。
const firstResult = await reader.read();
reader.releaseLock();
BYOB 的调用需要字节流和调用方提供的缓冲区:
async function readWithBuffer(byteStream, buffer) {
  // 只有底层按 type: "bytes" 构造时,mode: "byob" 才适用。
  const reader = byteStream.getReader({ mode: "byob" });

  try {
    // 缓冲区交给 reader 填充,返回值里的 view 代表本次实际读取范围。
    const { done, value } = await reader.read(buffer);
    return { done, bytesRead: value ? value.byteLength : 0 };
  } finally {
    // 释放 BYOB reader 的锁,不把流永久占用在当前调用方。
    reader.releaseLock();
  }
}
如果只是上传用户选择的文件,默认 reader 或直接传递 file.stream() 通常已经足够。只有在底层明确提供字节流、并且你确实需要控制接收缓冲区时,才考虑 BYOB;对普通流强行传 mode: "byob" 会触发 TypeError。
错误处理:区分结束、取消和释放锁
done 是正常结束信号,不代表请求一定成功;HTTP 状态仍要由 fetch 的响应单独判断。读取过程中如果 Promise 拒绝,应让异常进入调用方的错误处理。若用户点击取消,调用 reader.cancel() 表示不再需要剩余数据;releaseLock() 只是释放当前 reader 对流的所有权,两者作用不同。
async function readUntilCancelled(stream, signal) {
  const reader = stream.getReader();

  // 取消信号触发时终止底层流,避免只释放锁却继续产生数据。
  const abort = () => reader.cancel("用户取消上传");
  signal.addEventListener("abort", abort, { once: true });

  try {
    while (true) {
      const { done, value } = await reader.read();
      if (done) {
        break;
      }
      // 这里处理当前块;示例只保留读取职责,不伪造服务端进度。
      console.log("收到字节数:", value.byteLength);
    }
  } finally {
    signal.removeEventListener("abort", abort);
    reader.releaseLock();
  }
}
不要在同一条仍被 reader 锁定的流上再次调用 getReader()。若确实要交给另一个消费者,先结束当前读取,按需要取消或等待完成,再释放锁;否则会得到“流已经锁定”的 TypeError。
兼容策略:先确认请求体和浏览器支持矩阵
MDN 将 ReadableStream.getReader() 标记为广泛可用,并说明它也可在 Web Worker 中使用。但“能读取流”和“能把流作为 fetch 请求体上传”是两个能力面,项目应分别检查目标浏览器、请求模式以及服务端是否接受分块请求体。
在不支持流式请求体的环境中,可以保留普通的 File 或 Blob 上传降级;不要因为 getReader() 可用,就假设 fetch 的 body 配置完全一致。
function uploadBody(file, supportsStreamingBody) {
  // 能力判断由应用自己的兼容矩阵提供,不能只看 API 名称是否存在。
  if (supportsStreamingBody && typeof file.stream === "function") {
    return { body: file.stream(), duplex: "half" };
  }

  // 降级到 File 本身,交给服务端按普通请求体处理。
  return { body: file };
}
一张表记住 getReader 的几个边界
| 问题 | 结论 | 调用方动作 |
|---|---|---|
| 谁取得流的读取权 | getReader() 创建 reader 并锁定流 | 结束后按需调用 releaseLock() |
| 怎样拿下一块 | read() 返回 Promise,结果含 done 与 value | 等待 Promise,不假设块大小或次数 |
| 什么时候结束 | done === true 表示流已经没有更多数据 | 结束读取循环,再单独判断 HTTP 响应 |
| 什么时候取消 | cancel() 表示不再需要剩余数据 | 响应用户取消,避免继续消费底层流 |
| 什么时候用 BYOB | 底层必须是支持字节读取的流 | 需要缓冲区控制时再传 mode: "byob" |
因此,标题中的“逐块读取上传数据”可以压缩成一个稳定的决策:普通文件流先取得默认 reader,再用 read() 处理每个块;需要把流直接作为请求体时,确认 fetch 的流式 body 支持;用户取消或读取异常时分别处理 cancel() 与异常,最后释放锁。
相关问题
为什么第二次调用 getReader() 会报错?
因为第一次调用已经把流锁定给当前 reader。先结束或取消读取,再调用 releaseLock(),才能让其他消费者重新取得读取权。
read() 一次会返回完整文件吗?
不会。value 只是当前可用的数据块,块大小和次数由底层流决定;要得到完整内容,需要持续读取直到 done 为 true。
普通 File 流能直接使用 BYOB 吗?
不要默认这样做。BYOB 要求底层是可读字节流;普通流应使用默认 reader,或先确认流的构造方式和支持矩阵。
releaseLock() 会取消上传吗?
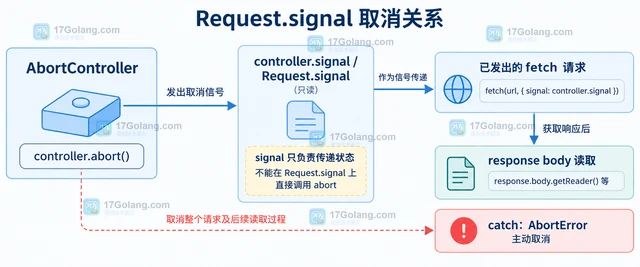
不会。它只释放 reader 对流的锁;取消剩余数据应调用 cancel(),上传请求本身还需要结合 AbortController 或服务端协议处理。
 Fetch Request.signal 怎样取消已经发出的请求
- 上一篇
- Fetch Request.signal 怎样取消已经发出的请求
- 下一篇
- WebSocket close 事件怎样区分主动与异常断开
-
- 文章 · 前端 | 58分钟前 |
- Vite import.meta.env 怎样区分构建期和运行期变量
- 260浏览 收藏
-
- 文章 · 前端 | 1小时前 |
- URLSearchParams 怎样删除指定键的全部参数值
- 118浏览 收藏
-
- 文章 · 前端 | 1小时前 | websocket close CloseEvent 异常断开
- WebSocket close 事件怎样区分主动与异常断开
- 410浏览 收藏
-
- 文章 · 前端 | 1小时前 | Fetch AbortController AbortSignal fetch取消请求 Request.signal
- Fetch Request.signal 怎样取消已经发出的请求
- 300浏览 收藏
-
- 文章 · 前端 | 1小时前 |
- JavaScript queueMicrotask 怎样安排微任务执行顺序
- 209浏览 收藏
-
- 文章 · 前端 | 1小时前 |
- JavaScript Promise.any 怎样获取第一个成功结果
- 437浏览 收藏
-
- 文章 · 前端 | 1小时前 |
- CSS prefers-reduced-motion 怎样关闭非必要动画
- 211浏览 收藏
-
- 文章 · 前端 | 1小时前 |
- CSS :has 怎样根据子元素状态选择父元素
- 446浏览 收藏
-
- 文章 · 前端 | 1小时前 | 前端开发 · CSS 响应式布局 object-fit aspect-ratio 媒体卡片
- CSS aspect-ratio 怎样稳定媒体卡片比例
- 498浏览 收藏
-
- 文章 · 前端 | 13小时前 | CSS animation transform 前端动画 animation-composition
- CSS animation-composition 怎样叠加多个动画效果
- 221浏览 收藏
-
- 文章 · 前端 | 20小时前 |
- Vite import.meta.glob 怎样批量加载模块
- 157浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 720次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 727次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 804次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 764次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 602次使用
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览


