
OpenAI Responses API 怎样为图片生成请求绑定输入图
如果应用要让模型参考一张商品图、草图或上一轮生成结果,关键不是把图片地址拼到提示词里,而是把它作为 Responses API 的 input_image 内容项传入。请求通常由一段 input_text 说明任务,再配一项或多项 input_image 组成;图片可以使用完整 URL、Base64 data URL 或 Files API 返回的 file_id。
官方参考:https://developers.openai.com/api/docs/guides/image-generation
最稳定的判断方式是:先把文字和图片放进同一个 user content 数组,再根据图片来源选择 URL、data URL 或 file_id;如果是修改已有图片,可显式设置action: "edit",返回时从image_generation_call读取图像结果。
- 公开图片:使用完整的
https://图片地址。 - 本地或内存图片:转为
data:image/...;base64,...。 - 已通过 Files API 上传的图片:使用文件 ID,不要把 ID 填到
image_url。
先把 Responses API 的输入层次摆对
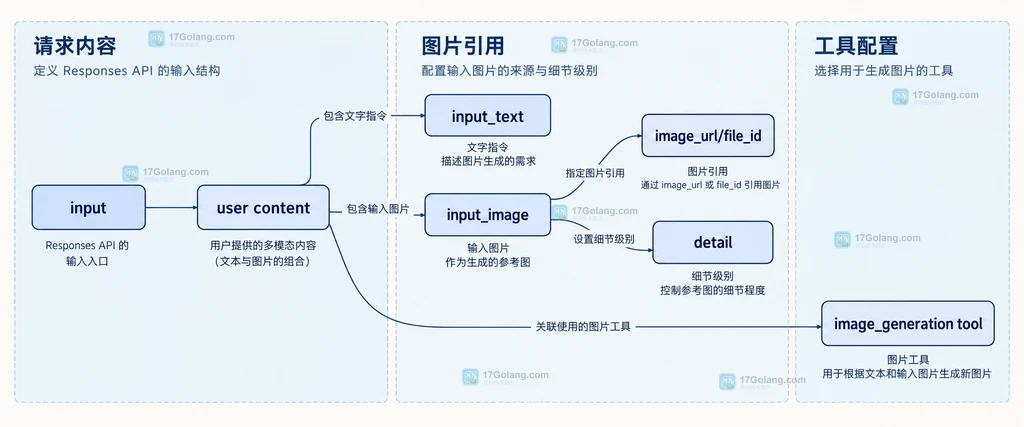
这类请求最容易出错的地方是层次。input 可以是文本,也可以是消息数组;当需要同时传文字和图片时,应使用消息数组,并在 content 中放入一个 input_text 和至少一个 input_image。图片不是普通字符串,也不是工具配置里的提示词字段。
下面的结构图只表达请求对象、消息内容和图片工具之间的静态关系,不代表一次真实运行截图。
三种方式怎样绑定输入图
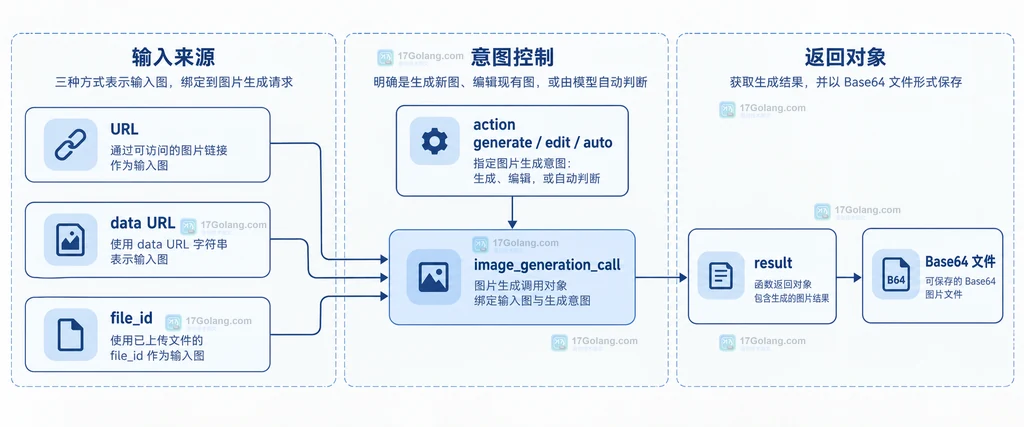
官方资料给出的输入图入口可以归为三类。公开且可访问的图片适合使用 URL;程序已经拿到图片字节时适合使用 Base64 data URL;图片先通过 Files API 上传并获得文件 ID 后,使用 file_id 更适合复用和多轮处理。
from openai import OpenAI
import base64

client = OpenAI()

# 方式一:图片已经放在可访问的 HTTPS 地址
remote_image = {
    "type": "input_image",
    "image_url": "https://example.com/reference.png",
    "detail": "auto",
}

# 方式二:程序已有图片字节,拼成完整的 data URL
with open("reference.png", "rb") as image_file:
    encoded = base64.b64encode(image_file.read()).decode("ascii")
local_image = {
    "type": "input_image",
    "image_url": f"data:image/png;base64,{encoded}",
    "detail": "auto",
}

# 方式三:已通过 Files API 得到的文件 ID
file_image = {
    "type": "input_image",
    "file_id": "file_abc123",
    "detail": "auto",
}

response = client.responses.create(
    model="gpt-6-astra",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "参考输入图,生成一张风格统一的产品场景图。"},
            # 三选一;生产代码不要同时传入同一张图的三种表示
            file_image,
        ],
    }],
    tools=[{
        "type": "image_generation",
        "model": "gpt-image-2.5-sunburst",
        "action": "edit",
    }],
)
示例中的 file_abc123 只是字段形状示意,不能当作真实文件 ID。实际项目要把 remote_image、local_image 或 file_image 中的一种放入 content。如果来源是 JPEG 或 WebP,data URL 的 MIME 类型也要与真实文件匹配。
生成与编辑:什么时候设置 action
已有输入图时,任务通常是“参考后生成”或“在原图上修改”。把 action 设为 edit 可以明确告诉工具围绕已有图片处理;设为 generate 则表示始终创建新图;不填写时使用 auto,由支持的主模型根据上下文选择。这个字段控制的是图片工具的意图,不会替代 input_image。
import OpenAI from "openai";
import fs from "fs";

const openai = new OpenAI();
const response = await openai.responses.create({
  model: "gpt-6-astra",
  input: [{
    role: "user",
    content: [
      { type: "input_text", text: "保留主体轮廓,把背景改成柔和的浅色工作室环境。" },
      { type: "input_image", file_id: "file_abc123", detail: "auto" },
    ],
  }],
  tools: [{
    type: "image_generation",
    model: "gpt-image-2.5-sunburst",
    // 已有输入图并要求修改时,显式表达编辑意图
    action: "edit",
  }],
});

const imageCall = response.output.find(
  (item) => item.type === "image_generation_call",
);

if (!imageCall?.result) {
  // 没有图像调用或结果为空时,不要写出一个假文件
  throw new Error("响应中没有可保存的图像结果");
}

// result 是 Base64 图像数据,按实际输出格式保存到文件
fs.writeFileSync("edited.png", Buffer.from(imageCall.result, "base64"));
输出处理要围绕 response.output 中的 image_generation_call。不要把 response.output_text 当作图片,也不要假设每次响应都一定包含图像调用;没有结果时应记录原始响应状态并走错误处理。
常见绑定错误与排查顺序
| 现象 | 常见原因 | 处理方式 |
|---|---|---|
| 模型只收到文字 | 把图片地址拼进了普通文本 | 改为 type: "input_image" 内容项 |
| 请求字段冲突 | 同一项同时填了 image_url 和 file_id | 二选一,保持输入来源明确 |
| 文件 ID 无效 | 把本地路径或占位字符串当成 Files API ID | 先完成文件上传,再使用真实返回的 ID |
| 改图意图不稳定 | 已有输入图但依赖默认的 auto | 明确设置 action: "edit",并在文字中写清保留与修改范围 |
| 保存出空文件 | 没有检查 image_generation_call.result | 先查找调用对象和结果,再做 Base64 解码 |
排查时按“输入对象类型 → content 层次 → 图片表示方式 → action → 输出对象”顺序看,通常比反复改提示词更快。输入图只负责提供视觉上下文,不能替应用替换掉必要的任务描述、权限配置或结果处理。
落地前的最小清单
- 确认请求使用的是 Responses API,并把文字和图片放在同一个 user content 数组。
- 根据图片来源选择 URL、data URL 或 file_id;不要混用字段。
- 已有图片要修改时,优先显式写
action: "edit",同时说明保留区域和修改目标。 - 从
image_generation_call.result读取 Base64 结果,空结果进入错误处理。
常见问题
可以一次传多张输入图吗?
可以。把多项 input_image 放进同一个 content 数组,并在文字中说明每张图的角色,避免模型无法区分参考对象。
为什么有 file_id 还要保留 input_text?
file_id 只标识输入图,不能完整表达你想生成、修改或保留什么。文字指令仍应放在 input_text 中。
输入图传进去后一定会返回图片吗?
不应这样假设。应用仍需检查返回输出是否包含 image_generation_call 及其 result,并把缺失结果当作一次需要处理的响应异常。
 Kubernetes 发布说明怎样判断一个特性是否稳定
- 上一篇
- Kubernetes 发布说明怎样判断一个特性是否稳定
- 下一篇
- CNCF 怎样查看一个项目的成熟度和治理状态
-
- 科技周边 · 人工智能 | 41分钟前 |
- OpenAI Batch API 怎样安排离线批量请求
- 114浏览 收藏
-
- 科技周边 · 人工智能 | 42分钟前 |
- 模型输出为什么会被截断以及怎样读取完成原因
- 277浏览 收藏
-
- 科技周边 · 人工智能 | 49分钟前 |
- OpenAI API 怎样为结构化输出定义 JSON Schema
- 101浏览 收藏
-
- 科技周边 · 人工智能 | 52分钟前 |
- OpenAI Embeddings 怎样按批量输入组织请求
- 124浏览 收藏
-
- 科技周边 · 人工智能 | 54分钟前 |
- Hugging Face Hub 怎样固定模型修订版本
- 123浏览 收藏
-
- 科技周边 · 人工智能 | 57分钟前 |
- OpenAI API 怎样读取请求 ID 进行故障定位
- 231浏览 收藏
-
- 科技周边 · 人工智能 | 58分钟前 |
- OpenAI API 怎样把图片输入和文本问题放在同一请求
- 417浏览 收藏
-
- 科技周边 · 人工智能 | 59分钟前 |
- OpenAI API 怎样区分流式输出中的文本事件
- 352浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- OpenAI Responses API 怎样保留多轮对话上下文
- 348浏览 收藏
-
- 科技周边 · 人工智能 | 15小时前 |
- model card 怎样读取输入约束
- 439浏览 收藏
-
- 科技周边 · 人工智能 | 15小时前 |
- JSON schema 怎样约束模型返回结构
- 241浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 694次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 706次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 775次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 734次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 568次使用
-
- 量化模型本地推理的显存估算方法
- 2026-10-17 501浏览
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览


