
Go bufio.Writer 为什么写入后文件仍然是空的
我第一次遇到这个问题时,文件创建成功、WriteString 也返回了长度,最后打开文件却是空的。真正容易混淆的地方在于:bufio.Writer 的“写入成功”通常只代表数据进入了它自己的内存缓冲区,并不等于底层的 *os.File 已经收到全部内容。
bufio.Writer.Write、Flush、os.File.Close分属不同层次,写入后必须显式 Flush。- 正确的资源顺序是先把 Writer 刷到底层文件,再关闭文件;不能把
File.Sync当成 Flush 的替代品。 - 排查时先看
Buffered()和每一步错误,避免只检查文件是否创建成功。
空文件通常是数据还停在 Writer 缓冲区
bufio.NewWriter(file) 在文件和业务代码之间增加了一层内存缓冲。调用 WriteString 时,数据先交给 Writer;只有缓冲区装满、主动调用 Flush,或者某些实现自行触发刷新时,底层文件才会收到这部分数据。程序如果直接结束,缓冲区里的尾部数据就可能没有机会发出去。
下面这种写法看起来每一步都成功,但它没有完成“提交到文件”的动作:
package main

import (
    "bufio"
    "os"
)

func main() {
    // Create 只负责打开或创建文件,不会替 bufio.Writer 刷新缓冲区。
    file, err := os.Create("report.txt")
    if err != nil {
        panic(err)
    }
    defer file.Close()

    writer := bufio.NewWriter(file)
    // 这次调用可能只把内容放进 Writer 的内存缓冲区。
    _, _ = writer.WriteString("第一行\n")
    // 直接返回时没有 Flush,文件可能仍然是空的或缺少尾部内容。
}
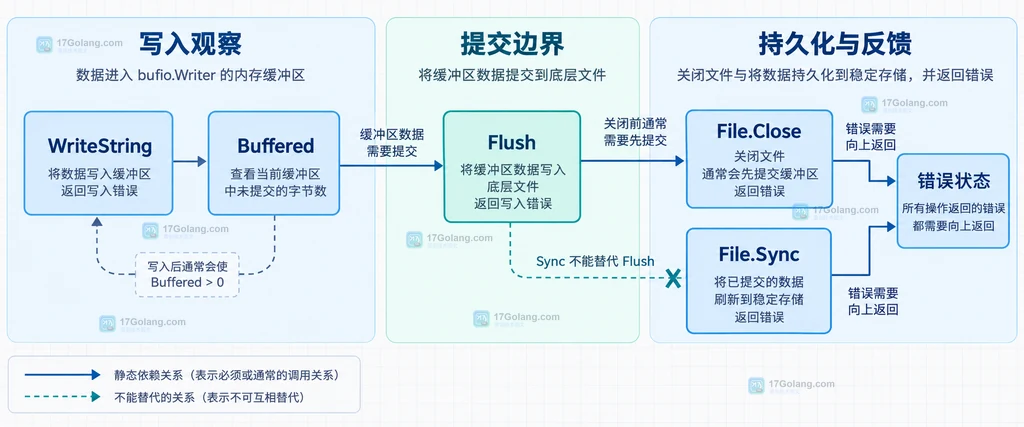
这里的关键不是“文件有没有创建”,而是“缓冲 Writer 有没有把剩余字节交给底层文件”。我会把这几个对象的关系画成静态结构图,读代码时先看清楚每个方法属于哪一层。
把 Flush 当成写入文件前的明确提交动作
官方对 Writer.Flush 的定义很直接:它会把当前缓冲数据写到底层 io.Writer。因此,写文件时我更愿意把 Flush 当成一个明确的提交点,而不是赌本次字符串足够大、缓冲区刚好自动刷新。
package main

import (
    "bufio"
    "fmt"
    "os"
)

func writeReport(path string) (err error) {
    // Create 成功只说明文件句柄可用,后续写入仍可能失败。
    file, err := os.Create(path)
    if err != nil {
        return err
    }
    defer func() {
        // 只有前面的步骤没有报错时,才把 Close 的错误作为返回值。
        if closeErr := file.Close(); err == nil && closeErr != nil {
            err = closeErr
        }
    }()

    writer := bufio.NewWriter(file)
    if _, err = fmt.Fprintln(writer, "第一行"); err != nil {
        return err
    }
    if _, err = fmt.Fprintln(writer, "第二行"); err != nil {
        return err
    }
    // Flush 把 Writer 尚未发送的尾部数据交给 *os.File。
    if err = writer.Flush(); err != nil {
        return err
    }
    return nil
}
这段代码把三种责任拆开了:格式化函数负责向 Writer 写,Flush 负责把缓冲交给文件,Close 负责结束文件句柄。对我来说,这样排错比把所有动作塞进多个 defer 更容易,因为每个失败点都有名字。
Flush、Close 和 Sync 不能互相替代
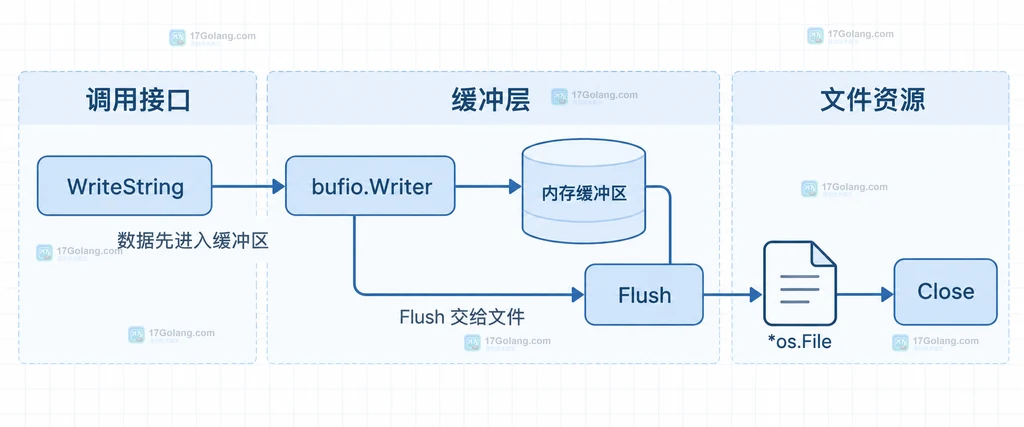
最常见的误判是“我已经调用 file.Close() 了,所以缓冲应该自动写完”。os.File.Close 关闭的是文件句柄;它不是 bufio.Writer.Flush 的通用替代品。把 Writer 包在 File 外面后,应用代码仍然应该显式 Flush,再 Close File。
File.Sync 又是另一层语义。它用于把文件当前内容提交到稳定存储,适合需要更强持久化保证的场景;但如果数据仍在 bufio.Writer 的内存里,先 Sync 文件也看不到那部分数据。顺序关系可以这样记:
| 动作 | 负责什么 | 不能替代什么 |
|---|---|---|
WriteString | 把数据交给 Writer 的缓冲逻辑 | 不能保证文件已收到尾部数据 |
Flush | 把 Writer 缓冲写入底层 File | 不等于稳定存储 |
File.Close | 关闭文件句柄并结束 I/O | 不应代替显式 Flush |
File.Sync | 请求文件内容提交到稳定存储 | 不能代替 Flush |
错误要从 Write、Flush 一直传到 Close
排障时我还会特别看错误处理。Writer 一旦在底层写入时遇到错误,后续写入和 Flush 可能继续返回同一个错误;如果代码把返回值全部丢掉,最后看到的“空文件”只是表象,真正原因可能是权限、磁盘空间或底层 I/O 失败。
func writeWithSync(path string, data string) (err error) {
    // 使用显式返回值,让 Flush、Sync、Close 的错误能汇总到同一出口。
    file, err := os.Create(path)
    if err != nil {
        return err
    }
    defer func() {
        // Close 只能补充尚未出现的错误,不能覆盖更早的真实失败。
        if closeErr := file.Close(); err == nil && closeErr != nil {
            err = closeErr
        }
    }()

    writer := bufio.NewWriter(file)
    if _, err = writer.WriteString(data); err != nil {
        return err
    }
    // 先 Flush,确保 Sync 看到的是 Writer 已经交给 File 的内容。
    if err = writer.Flush(); err != nil {
        return err
    }
    // 只有需要稳定存储语义时才增加 Sync;它不是缓冲刷新动作。
    return file.Sync()
}
这段代码里的 Sync 不是每个普通配置文件都必须调用。它会增加额外 I/O 成本,是否需要取决于应用对断电、系统崩溃后的持久化要求;但无论是否 Sync,Flush 都是把 bufio 缓冲交给文件的那一步。
用 Buffered 和关闭顺序快速定位
如果文件仍然为空,我会按下面的顺序检查,而不是先换编码或重建目录:
- 写入后查看
writer.Buffered():大于 0 说明仍有字节停留在 Writer 缓冲区。 - 确认
writer.Flush()的错误没有被忽略;只检查WriteString返回值不够。 - 确认 Flush 在
file.Close()之前发生。若用多个defer,记住后注册的 defer 先执行。 - 若 Flush 已成功但文件仍异常,再检查 File 的写入错误、权限、路径和是否打开了另一个同名文件。
- 只有需要稳定存储保证时才检查
Sync,不要用它掩盖未 Flush 的问题。
如果确实想用 defer,至少要注意注册顺序:先注册 file.Close,再注册 writer.Flush,这样退出时后注册的 Flush 会先执行。不过,生产代码里我仍倾向于像上面的示例一样显式调用 Flush,并把错误留在可读的控制流中。
常见问题
为什么小字符串有时能写进去,大字符串却丢尾部?
因为写入量可能刚好触发了缓冲区自动向底层写入,剩余尾部仍留在内存里。能偶尔成功不代表关闭前可以省略 Flush。
只调用 writer.Flush,不调用 file.Sync 可以吗?
普通写文件通常可以,Flush 已经把数据交给文件系统;只有应用要求更强的稳定存储语义时,才在 Flush 成功后考虑 Sync。
把 writer.Flush 放进 defer 是否安全?
可以,但要保证它在 file.Close 之前执行,并处理 Flush 返回的错误。多个 defer 的注册顺序很容易读反,显式控制更不容易遗漏。
writer.Buffered() 大于 0 能说明文件写入失败吗?
它只能说明当前仍有数据在 Writer 缓冲区,不能单独证明底层写入失败。还要检查 Flush 的返回错误以及文件本身的状态。
 Go CSV Reader 为什么遇到不等长字段就失败
- 上一篇
- Go CSV Reader 为什么遇到不等长字段就失败
- 下一篇
- Go MkdirAll 为什么在受限目录下创建失败
-
- Golang · Go问答 | 24分钟前 |
- Go strings.Split 为什么得到意外的空元素
- 267浏览 收藏
-
- Golang · Go问答 | 27分钟前 |
- Go zip 文件为什么打开后找不到中文文件名
- 276浏览 收藏
-
- Golang · Go问答 | 27分钟前 | go · Go 硬链接 archive/tar 解包顺序
- Go tar 解包为什么遇到链接条目顺序问题
- 292浏览 收藏
-
- Golang · Go问答 | 31分钟前 | 标准库 · 数据校验 · 压缩 · Go问答 · Go compress/gzip io.ReadAll ErrChecksum gzip.Reader CRC-32
- Go gzip Reader 为什么读取后校验失败
- 428浏览 收藏
-
- Golang · Go问答 | 32分钟前 |
- Go 流式响应为什么被缓冲到最后才发送
- 195浏览 收藏
-
- Golang · Go问答 | 35分钟前 |
- Go http.Transport DialTLSContext 自定义 TLS 连接的配置方法与 HTTP/2 边界
- 225浏览 收藏
-
- Golang · Go问答 | 38分钟前 |
- Go ServeMux 路径模式为什么没有命中请求
- 391浏览 收藏
-
- Golang · Go问答 | 41分钟前 |
- Go 请求超时为什么无法取消底层连接
- 445浏览 收藏
-
- Golang · Go问答 | 41分钟前 |
- Go http.Cookie 的 SameSite 为什么影响跨站请求
- 266浏览 收藏
-
- Golang · Go问答 | 57分钟前 |
- Go HTTP 重定向为什么丢失 Authorization
- 413浏览 收藏
-
- Golang · Go问答 | 1小时前 | JSON · go · Go eof json.Decoder 连续JSON读取
- Go json.Decoder 为什么连续读取时遇到 EOF
- 422浏览 收藏
-
- Golang · Go问答 | 1小时前 |
- Go JSON 重复字段为什么得到不同结果
- 111浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 693次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 705次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 767次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 731次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 565次使用
-
- 用Nginx反向代理部署go写的网站。
- 2023-01-17 502浏览
-
- GoLand调式动态执行代码
- 2023-01-13 502浏览
-
- Go JSONJSON null 解码到指针后状态不符合预期怎么办
- 2026-10-18 501浏览
-
- Go crypto/rand.Text 的长度为什么不是固定字符数
- 2026-10-04 501浏览
-
- Go strings.ToValidUTF8 清洗日志内容的边界
- 2026-10-03 501浏览


