Go 读取 ZIP 里的指定文件,不必先把整个归档解压到目录。用 zip.OpenReader 打开归档,按完整的 File.Name 找到目标条目,再通过 File.Open 读取解压后的内容即可。外层归档和内层条目流都需要关闭,读取错误也不能只靠 Close 判断。
假设一个交付包包含说明文件、图片和 config/manifest.json,程序只需要读取这份清单。这里采用“完整名称精确匹配、同名拒绝、大小受限”的方案,不落盘、不批量展开其他内容,也不假设归档里只有一个 JSON 文件。
官方文档地址:https://pkg.go.dev/archive/zip。
归档内名称和磁盘路径不是一回事
delivery.zip 是本地文件系统上的归档路径,config/manifest.json 是 ZIP 目录记录里的名称。后者通常使用正斜杠,大小写按字符串精确比较;不能在 Windows 上用 filepath.Join 拼出反斜杠后,再期待它与归档里的名称相等。
只比较 BaseName 也容易误选:config/manifest.json 和 backup/manifest.json 的末尾文件名一样,却不是同一条目。固定协议应规定完整名称,不要以“找到第一个后缀为 .json 的文件”代替。
示例要求条目名符合斜杠路径格式,拒绝点目录、反斜杠等输入;这只是本函数的名称契约。程序没有把 ZIP 名称拼成输出路径,因此没有实现“解压目录”。以后若增加落盘功能,需要重新设计目标目录约束,不能直接复用这里的字符串匹配当作完整解压安全方案。
只读取一个条目可以不解压整个包
下面是原创的完整示例。上限固定为 1 MiB,适合小型清单,不适合把大视频直接读进内存。函数扫描完目录再打开唯一匹配项,因此不会在发现第一个同名项时提前接受。
package main

import (
    "archive/zip"
    "errors"
    "fmt"
    "io"
    "io/fs"
    "strings"
)

// 本例读取较小的清单文件,单条目解压后最多接受 1 MiB。
const maxEntryBytes int64 = 1 << 20

var (
    ErrDuplicate = errors.New("归档内存在重名条目")
    ErrTooLarge  = errors.New("条目超过读取上限")
)

// ReadZipEntry 只返回数据,不根据归档名创建磁盘文件。
func ReadZipEntry(archivePath, entryName string) (data []byte, err error) {
    // fs.ValidPath 约束斜杠路径;额外拒绝反斜杠和根目录名。
    if entryName == "." || !fs.ValidPath(entryName) ||
        strings.Contains(entryName, "\\") {
        return nil, fmt.Errorf("非法条目名 %q", entryName)
    }

    archive, openErr := zip.OpenReader(archivePath)
    // ErrInsecurePath 等情况可能同时返回非空 reader,仍须关闭。
    if archive != nil {
        defer func() {
            if closeErr := archive.Close(); closeErr != nil && err == nil {
                data = nil
                err = fmt.Errorf("关闭归档: %w", closeErr)
            }
        }()
    }
    if openErr != nil {
        return nil, fmt.Errorf("打开归档: %w", openErr)
    }

    // 扫描完整目录,按完整名称精确匹配,并拒绝同名歧义。
    var selected *zip.File
    for _, entry := range archive.File {
        if entry.Name != entryName {
            continue
        }
        if selected != nil {
            return nil, fmt.Errorf("%w: %q", ErrDuplicate, entryName)
        }
        selected = entry
    }
    if selected == nil {
        return nil, fmt.Errorf("%w: %q", fs.ErrNotExist, entryName)
    }
    if !selected.Mode().IsRegular() {
        return nil, fmt.Errorf("条目不是普通文件: %q", entryName)
    }
    if selected.UncompressedSize64 > uint64(maxEntryBytes) {
        return nil, fmt.Errorf("%w: %q", ErrTooLarge, entryName)
    }

    stream, streamErr := selected.Open()
    if streamErr != nil {
        return nil, fmt.Errorf("打开条目: %w", streamErr)
    }
    // 条目流先于外层归档关闭;关闭不能代替读到 EOF。
    defer func() {
        if closeErr := stream.Close(); closeErr != nil && err == nil {
            data = nil
            err = fmt.Errorf("关闭条目: %w", closeErr)
        }
    }()

    // 多读一个字节用于区分恰好达限与超限,不信任头部声明值。
    data, err = io.ReadAll(io.LimitReader(stream, maxEntryBytes+1))
    if err != nil {
        return nil, fmt.Errorf("读取条目: %w", err)
    }
    if int64(len(data)) > maxEntryBytes {
        return nil, fmt.Errorf("%w: %q", ErrTooLarge, entryName)
    }
    return data, nil
}

func main() {
    // 示例名称由调用方明确指定,不把归档内容打印到日志。
    data, err := ReadZipEntry("delivery.zip", "config/manifest.json")
    if err != nil {
        switch {
        case errors.Is(err, fs.ErrNotExist):
            fmt.Println("归档或指定条目不存在")
        case errors.Is(err, ErrDuplicate):
            fmt.Println("请提供不含重名条目的归档")
        default:
            fmt.Printf("读取失败: %v\n", err)
        }
        return
    }
    fmt.Printf("读取到 %d 字节\n", len(data))
}
将清单放在 ZIP 内的 config/manifest.json,并把磁盘归档命名为 delivery.zip,即可在自己的项目中调用此示例。成功时返回字节切片及 nil 错误;真实内容长度由自己的文件决定。本文未执行这段程序,也不把示例输出当作运行记录。
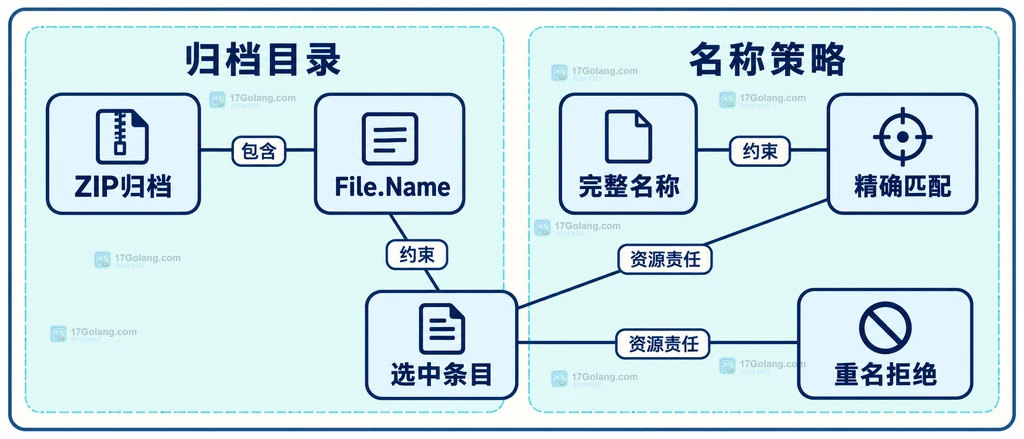
File.Open 文档说明返回的是文件内容读取器,而不是磁盘文件路径。未选中的条目在此方案中不会被逐一打开并读出,但归档目录本身仍需解析。
怎样限制大小并保留读取错误
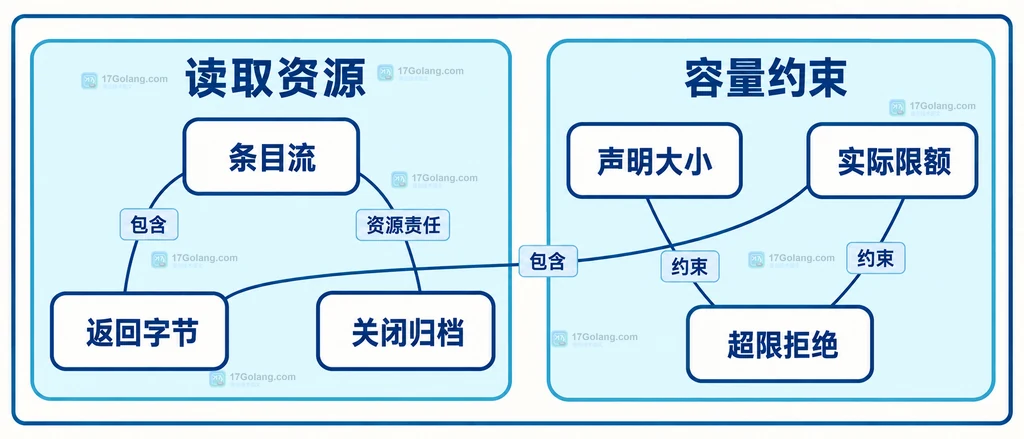
头部的 UncompressedSize64 可以用来提前拒绝明显过大的条目,但它属于归档数据,不能独自承担实际读取限额。代码同时用 io.LimitReader 包住条目流;上限多给一个字节,只有实际结果不超过 1 MiB 才接受。
为什么不只读 maxEntryBytes?LimitReader达到指定字节数就会返回 EOF,此时调用方无法仅凭 ReadAll 成功判断原内容恰好达限还是仍有剩余。多读一个字节使超限成为明确的业务拒绝,而不是默默截断清单。
这个上限约束的是返回前读取的解压后字节量,不是程序总内存的精确硬限额,也不是 CPU 时间上限。底层解压缓冲、ReadAll 的容量增长和归档目录都有额外开销。面对不可信上传,应在接收阶段限制归档本身的大小,并根据实际风险隔离处理;不能把这一个函数称为通用压缩包防护系统。
读取错误出现时,即使已经拿到部分数据也不返回给业务解析器。这样调用方不会把截断内容误当成完整配置。对未超限的正常文件,读取会继续探测到底层 EOF;超限时直接拒绝,不为追求完整性检查而继续消费整份内容。
找不到、重名和目录应该分别处理
找不到目标名称时返回包装后的 fs.ErrNotExist,用 errors.Is 识别;但打开归档本身不存在时,也可能包装同一个底层错误,所以 main 的提示同时涵盖二者。若界面必须精确区分,需要再定义“条目缺失”的专用业务错误,不要仅靠字符串匹配。
目录与普通文件不混用。本例要求普通文件,目录或带其他模式的条目不接受;很多目录记录以斜杠结尾,也不符合这里要求的文件名形态。ZIP 中同名条目则直接拒绝,避免“取第一个”与“取最后一个”在不同工具里产生歧义。
OpenReader 可能在返回 reader 的同时返回 ErrInsecurePath;处理这种组合时也要释放 reader。代码对任何打开错误都不继续读取,并先为非空归档注册关闭动作。读取条目后注册的 defer 后执行注册、先执行关闭,因此先关闭条目流,再关闭外层归档。
不支持的压缩方法、损坏的归档、底层读取问题都不等同于“文件不存在”,应保留原始错误链,交由调用方决定反馈方式。不要遇到任何错误都返回空字节切片,否则空文件和失败就无法区分。
换成内存归档或批量读取时怎样调整
已有完整 ZIP 字节时,可以通过 bytes.NewReader 提供 ReaderAt,再把准确字节长度传给 zip.NewReader。NewReader 本身不会替调用方关闭原始数据源;如果 ReaderAt 来自打开的磁盘文件,生命周期由创建它的调用方管理。
网络响应通常只有顺序读取能力,不能直接当成 ReaderAt 使用。应先在大小限制下接收完整内容到合适的内存或临时文件,再建立归档读取器;不要为了“只读一个文件”就无界地把整个网络包装进内存。
同一个归档要读取很多名称时,可以只打开一次,并为名称建立索引,同时在建立索引时拒绝重复项。每次打开的条目流应及时关闭,避免在长循环里堆积 defer。这个优化改变的是目录查找和资源组织,不会自动减少所有解压成本。
这几个 ZIP 读取疑问容易混淆
Close 成功,就说明条目没有损坏吗?
不是。完整性问题可能在读取到文件末尾时才暴露,关闭不是替代完整读取的手段。Go 的 ZIP 读取实现在 EOF 处理分支核对长度和校验信息,因此只读取前缀或在限额处主动停止时,不应声称已经完成整份条目的完整性检查。
读出的 JSON 能直接当作配置使用吗?
先处理读取错误,再按照业务结构解析 JSON,并检查必需字段和允许值。ZIP 的内容完整性不等于配置语义正确,CRC 也不等于可信来源或数字签名;这几层判断要分开。
只读取一个文件,会完全不接触其他条目吗?
仍会解析归档目录。本例还会扫描目录来检查同名项,但只对选中的文件打开解压流。不必把其他内容写入磁盘,是这个方案的直接收益;不能把它解释成归档条目数量再多也没有成本。
收束到这类任务,关键并非“先解压再找文件”,而是把名称选择、读取限额、错误链和两层关闭责任都写清楚。小清单可返回受限字节切片;大文件则需要另行设计流式消费与最终成功提交的契约。
 Go embed 怎样把模板放进二进制