
Go encoding/csv 怎样用 FieldPos 定位解析错误
我在处理 CSV 导入错误时遇到过一个很具体的问题:日志只写了“第 4 个字段格式不对”,但维护者还要回到原文件里猜它到底对应第几行、第几列。record 的下标只能说明字段在当前切片中的位置,不能直接当成输入文件的位置。Go 的 encoding/csv.Reader 可以用 FieldPos 把这个下标映射为字段起始行和列。
这篇只讨论字段位置和错误提示,不把它扩展成完整的 CSV 编码转换或数据清洗方案。官方文档地址:https://pkg.go.dev/encoding/csv。
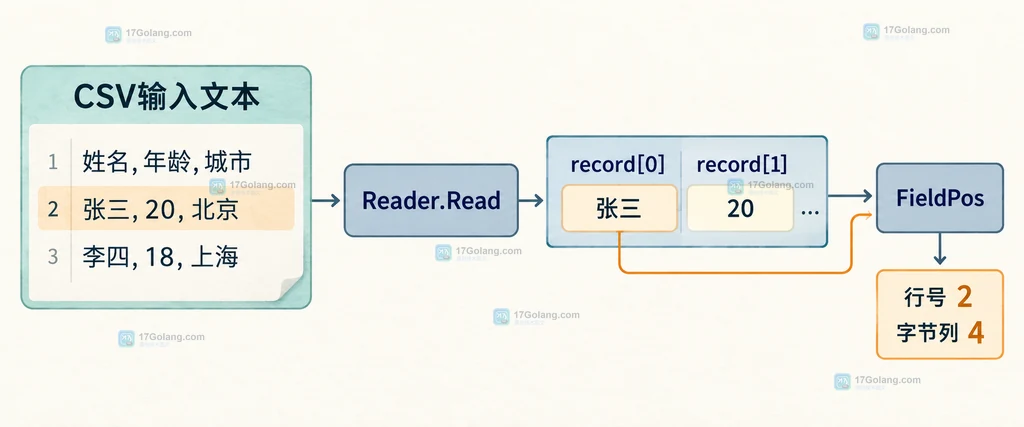
先用Read成功取得一条记录,再对这条记录中的合法字段下标调用FieldPos。它返回从 1 开始的行号和按字节计算的列号;语法错误交给ParseError,业务字段错误则由调用方补充字段名和原始值。
先把字段下标和原始位置分开
Read 返回的是一份 []string。例如一条记录有三个字段,那么 record[0]、record[1] 和 record[2] 只是当前记录里的三个位置。它们不等于文件的第 0、1、2 行,也不等于字符列号。
如果导入程序只记录下标,错误日志会缺少两个重要信息:输入中的行,以及字段值在这一行的起始位置。排查时更实用的记录应该至少包含字段名、原始值、行号和列号。
在 Read 成功后调用 FieldPos
FieldPos(field) 的参数是最近一次 Read 返回切片中的字段下标。返回值是该字段起始位置的行号和列号,二者从 1 开始;列号按字节计算,而不是按 Unicode 字符数计算。
因此调用顺序很重要:不能在第一次 Read 之前调用,也不能在下一次 Read 已经覆盖当前记录之后再拿旧下标定位。下面的函数把 CSV 记录和字段名组合成一条可读的提示。
package main

import (
    "encoding/csv"
    "fmt"
    "io"
    "strings"
)

func readAmount(reader *csv.Reader) error {
    for {
        record, err := reader.Read()
        if err == io.EOF {
            return nil
        }
        if err != nil {
            // CSV 语法错误交给上层处理,不把它伪装成业务字段错误。
            return fmt.Errorf("读取 CSV 记录失败: %w", err)
        }
        if len(record)
这里的 reader.FieldPos(1) 对应第二个字段,因为下标从 0 开始;返回的行列却从 1 开始。把这两个编号体系分开写进函数,是避免日志再次出现偏移的关键。
把定位结果放进错误信息
实际导入通常需要校验整数、日期或必填字段。可以把“字段名称”和“字段下标”放在一份结构里,校验失败时统一生成带位置的错误。这样业务代码不需要到处手写 FieldPos 调用。
type csvField struct {
    Name  string
    Index int
}

func requireText(reader *csv.Reader, record []string, field csvField) error {
    // FieldPos 的前提是 Index 属于刚刚 Read 返回的 record。
    if field.Index = len(record) {
        return fmt.Errorf("字段 %q 不在当前记录中", field.Name)
    }

    value := record[field.Index]
    if strings.TrimSpace(value) == "" {
        // 位置只用于解释错误,空值规则仍由业务层定义。
        line, column := reader.FieldPos(field.Index)
        return fmt.Errorf("字段 %q 为空,位置=%d:%d", field.Name, line, column)
    }
    return nil
}
这个边界让错误信息同时保留了三层含义:哪个业务字段出错、输入中的哪一个位置出错、以及为什么出错。对批量导入来说,调用方还可以把这些错误包装成记录级结果,而不是只返回一个模糊的“解析失败”。
需要注意的是,FieldPos 返回的是字段开始位置,不是字段结束位置,也不是错误文本在整份文件中的字节偏移。如果业务需要截取原始字节片段,应另外保存输入流或使用更底层的偏移策略。
处理 ParseError 与越界边界
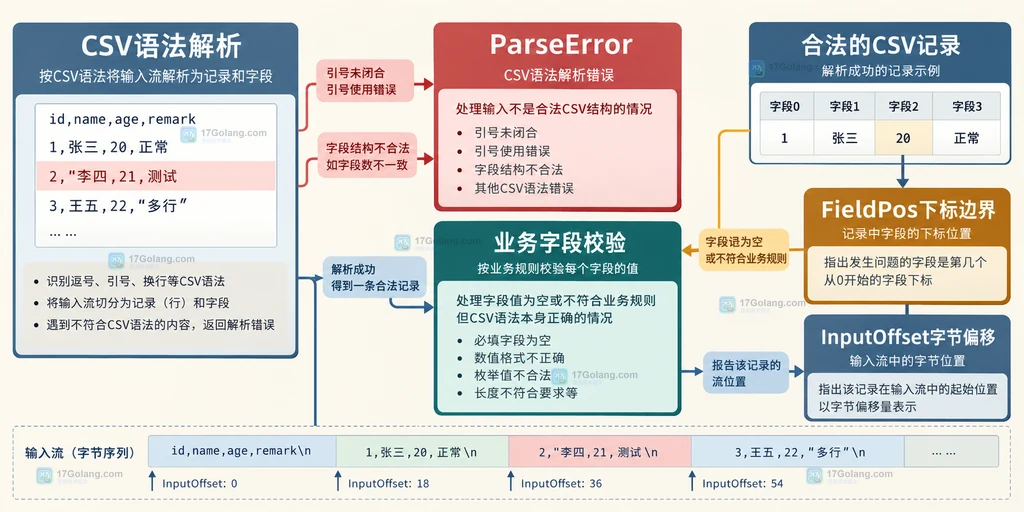
CSV 的引号、分隔符和字段数量错误属于解析阶段;空值、日期格式和业务范围错误属于校验阶段。两类错误不要混在一个判断里,否则日志会把输入语法问题误写成业务数据问题。
func readOne(reader *csv.Reader) ([]string, error) {
    record, err := reader.Read()
    if err == nil {
        return record, nil
    }
    if err == io.EOF {
        // EOF 表示输入结束,不应该被记录为坏数据。
        return nil, err
    }

    var parseErr *csv.ParseError
    if errors.As(err, &parseErr) {
        // ParseError 自带 1 基础的行列和底层错误原因。
        return nil, fmt.Errorf("CSV 语法错误,起始行=%d,错误位置=%d:%d: %w", parseErr.StartLine, parseErr.Line, parseErr.Column, parseErr.Err)
    }
    return nil, fmt.Errorf("读取 CSV 失败: %w", err)
}
FieldPos 的下标越界会触发 panic,所以不能为了打印错误而直接调用 FieldPos(len(record))。先做下标范围判断,再调用定位方法;如果错误发生在 Read 内部,则优先使用 ParseError 携带的位置。
另外,FieldPos 针对的是最近一次 Read 的结果。如果循环已经开始下一次读取,上一条记录的字段下标就不应继续交给它定位。
用 InputOffset 补充流式读取上下文
处理大文件时,逐条调用 Read 比一次性 ReadAll 更适合控制内存。此时可以用 InputOffset 记录当前读取器的位置,帮助日志判断处理到了输入流的哪个字节边界。
func scan(reader *csv.Reader) error {
    for {
        record, err := reader.Read()
        if err == io.EOF {
            return nil
        }
        if err != nil {
            // 发生语法错误时,保留当前流位置帮助定位大文件上下文。
            return fmt.Errorf("偏移 %d 处读取失败: %w", reader.InputOffset(), err)
        }
        if len(record) == 0 {
            // 空记录不应触发字段定位调用。
            continue
        }

        line, column := reader.FieldPos(0)
        fmt.Printf("记录开始于 %d:%d,读取后偏移=%d\n", line, column, reader.InputOffset())
    }
}
InputOffset 和 FieldPos 解决的是不同问题:前者是输入流的字节位置,后者是最近一条记录中某个字段的起始行列。它们可以同时出现在日志中,但不能互相替代。
最后检查四个容易混淆的点
| 问题 | 应该使用 | 关键边界 |
|---|---|---|
| 字段从哪一行哪一列开始 | FieldPos | 只适用于最近一次 Read 返回的合法下标 |
| 引号或字段结构不合法 | ParseError | 优先读取其自带的起始行、错误行和列 |
| 流式读取到哪里 | InputOffset | 返回输入字节偏移,不是字段列号 |
| 字段为空或格式错误 | 业务校验函数 | 先确认下标安全,再补充位置和字段名 |
我现在会把 CSV 导入的错误分成两层:Reader 负责告诉我“这份文本能不能按 CSV 规则解析”,业务代码负责告诉我“解析出来的字段是否能被业务接受”。只有在第二层校验时,才把字段名、原始值和 FieldPos 放在一起。
相关问题
FieldPos返回的列号为什么按字节计算,而不是按中文字符数计算?- CSV 解析失败时,应该记录
ParseError.Line还是ParseError.StartLine? - 大文件逐条读取时,怎样同时保留行列位置和输入字节偏移?
 Go filepath.ToSlash 怎样统一跨平台路径分隔符
- 上一篇
- Go filepath.ToSlash 怎样统一跨平台路径分隔符
- 下一篇
- Go json.Decoder 怎样逐个解析对象流
-
- Golang · Go教程 | 22分钟前 | HTTP · Go教程 · net/http · Go HTTP请求头 Header.Get http.Header.Values 重复请求头
- Go http.Header.Values 怎样读取重复请求头而不丢值
- 295浏览 收藏
-
- Golang · Go教程 | 24分钟前 |
- Go context 怎样合并多个取消来源
- 264浏览 收藏
-
- Golang · Go教程 | 26分钟前 |
- Go context 怎样传递只读请求元数据
- 355浏览 收藏
-
- Golang · Go教程 | 26分钟前 |
- Go context 怎样给后台任务设置独立生命周期
- 493浏览 收藏
-
- Golang · Go教程 | 29分钟前 |
- Go ServeMux 怎样按方法注册路由
- 347浏览 收藏
-
- Golang · Go教程 | 31分钟前 |
- Go RoundTripper 怎样注入追踪请求头
- 291浏览 收藏
-
- Golang · Go教程 | 33分钟前 |
- Go http.Server 怎样优雅关闭空闲连接
- 483浏览 收藏
-
- Golang · Go教程 | 35分钟前 |
- Go httptrace 怎样判断 DNS 查询是否发生
- 298浏览 收藏
-
- Golang · Go教程 | 42分钟前 |
- Go json.RawMessage 怎样保留未知字段并二次编码
- 200浏览 收藏
-
- Golang · Go教程 | 47分钟前 |
- Go json.Marshaler 怎样避免递归调用
- 214浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 527次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 584次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 612次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 563次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 384次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览


