
LLM 推理怎样估算 KV cache 显存占用
我在给大模型推理估算显存时,最容易先算错的不是模型权重,而是 KV cache:上下文长度一上去,权重没有变化,缓存却会随着 token 数继续增长。估算它不需要先启动模型,先把配置里的层数、KV 头数、每头维度、batch 和缓存精度代入公式,就能得到一个足以做容量规划的数量级。
官方资料入口:https://huggingface.co/docs/transformers/main/cache_explanation
缓存策略说明:https://huggingface.co/docs/transformers/main/kv_cache
一句话结论:标准全注意力模型的 KV cache 理论显存约等于 2 × batch_size × layers × seq_len × num_key_value_heads × head_dim × 每元素字节数。其中 2 代表 K 和 V 两份缓存;如果模型使用 GQA,应该使用 KV 头数,而不是全部 query 头数。
先判断:显存问题是不是 KV cache 引起的
触发信号通常有三个:模型权重能够加载,但一加长上下文就显存不足;单条请求可以运行,batch 增大后很快失败;或者生成初期正常,继续输出后显存持续上涨。它们都指向“缓存长度或并发数量”这一维度,但不等于一定是 KV cache。权重、临时激活、CUDA allocator 碎片和服务框架的预留空间也要留在预算里。
Hugging Face Transformers 的缓存文档把每层的 key/value 张量描述为类似 [batch_size, num_heads, seq_len, head_dim] 的结构,并说明动态缓存会随着生成增长;滑动窗口或混合注意力层则可能把增长限制在窗口长度内。估算时先判断模型是完整注意力、GQA/MQA,还是带窗口的混合结构。
先确定缓存真正保存的维度
我第一次按模型配置手算时,直接拿了 num_attention_heads,结果把一款 GQA 模型的缓存高估了好几倍。原因是 query 头可以很多,但 key/value 通常由更少的 KV 头共享。
- batch_size:同时保留多少条请求的缓存。并发翻倍,理论缓存也翻倍。
- layers:参与自注意力的层数。缓存按层保存,因此层数直接进入乘法。
- seq_len:当前要保留的 token 数,包括输入上下文和已经生成、仍在窗口内的 token。
- num_key_value_heads:每层真正保存 K/V 的头数。MHA 中它通常等于 attention heads,GQA/MQA 中会更少。
- head_dim:每个 KV 头的向量维度;不要把整个 hidden size 再乘一次。
- 每元素字节数:FP32 是 4,FP16 或 BF16 通常是 2,FP8 是 1;量化缓存还要把 scale、残差段等实现细节单独看待。
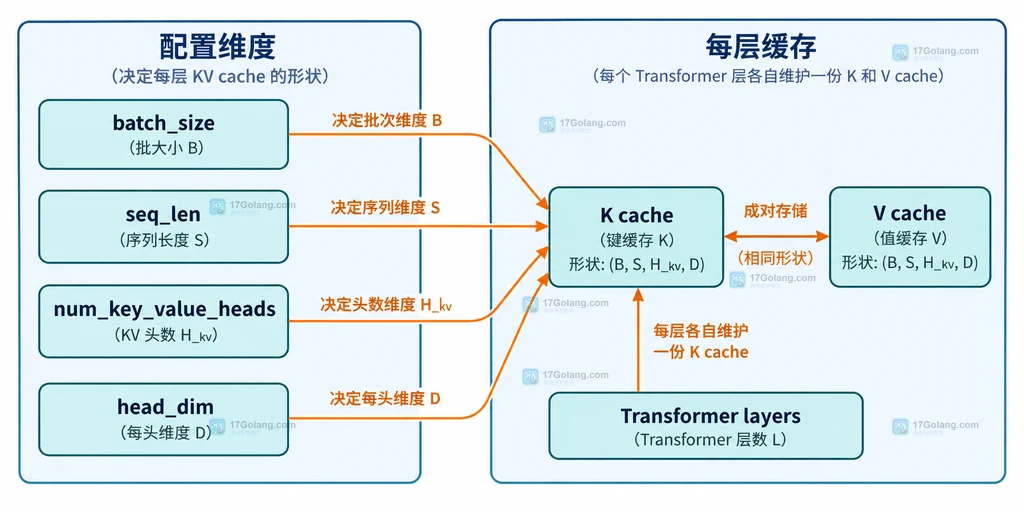
把 KV cache 显存公式写出来
对完整注意力、未做特殊压缩的缓存,可以先使用这个理论估算:
KV_bytes = 2 × B × L × T × Hkv × D × S

B    = batch_size
L    = Transformer layers
T    = 当前保留的 token 数
Hkv  = num_key_value_heads
D    = head_dim
S    = 每个缓存元素的字节数
2    = K cache 与 V cache 两份数据
换算成 GiB 时除以 1024^3,换算成 GB 时除以 1000^3。容量规划建议先用 GiB,因为 GPU 工具通常按二进制单位展示。这个公式只估算 KV 张量本身,不包含权重、临时张量、分页元数据和显存分配器的额外空间。
def estimate_kv_cache_gib(batch_size: int, layers: int, tokens: int,
                          kv_heads: int, head_dim: int,
                          bytes_per_element: int) -> float:
    # K 和 V 各保存一份,所以公式前面有 2
    kv_bytes = (2 * batch_size * layers * tokens * kv_heads
                * head_dim * bytes_per_element)
    # 使用 GiB 便于和 nvidia-smi 等工具的容量口径对照
    return kv_bytes / (1024 ** 3)


# 这里只做静态容量估算,不会加载模型或申请 GPU 显存
gib = estimate_kv_cache_gib(
    batch_size=1,
    layers=32,
    tokens=8192,
    kv_heads=8,
    head_dim=128,
    bytes_per_element=2,
)
print(f"理论 KV cache:{gib:.2f} GiB")
上面的参数得到约 1 GiB。它的意义是:一个 32 层、8 个 KV 头、每头 128 维的模型,在单条 8192 token、BF16/FP16 缓存下,K/V 张量本身就需要约 1 GiB。不要把这个数理解成服务进程的总显存。
用 GQA 示例看 batch 和精度的影响
假设模型有 32 层、32 个 query heads、8 个 KV heads、head_dim=128,每条请求保留 8192 token。因为是 GQA,公式里的 Hkv 取 8。
| batch | 缓存精度 | 理论 KV cache | 解释 |
|---|---|---|---|
| 1 | BF16/FP16 | 约 1 GiB | 单条长上下文的基础预算 |
| 2 | BF16/FP16 | 约 2 GiB | 并发翻倍,缓存近似翻倍 |
| 4 | BF16/FP16 | 约 4 GiB | 只增加 batch 就会吃掉同等比例缓存 |
| 1 | FP8 理论值 | 约 0.5 GiB | 元素字节数减半,但实现可能有额外 scale |
如果误把 32 个 query heads 当成 KV heads,单 batch、8192 token 的结果会从约 1 GiB 变成约 4 GiB。这正是 GQA 估算里最常见的数量级错误。反过来,不能看到配置里存在量化选项,就直接把理论值按 1、0.5 或 0.25 倍当成最终占用;量化缓存的布局、scale 和残差缓存由具体实现决定。
上下文长度为什么是最直接的容量开关
在其他配置不变时,KV cache 与 T 线性增长。8192 token 变成 16384 token,理论缓存约变成两倍;batch 从 1 变成 8,也约变成八倍。它与“生成 token 数”不是完全相同的概念:如果服务保留完整上下文,输入 token 和已经生成的 token 都会占据缓存;如果模型层采用滑动窗口,窗口之外的旧 token 不再按完整注意力层继续增长。
因此,收到显存不足时先看三项:请求实际 token 上限、服务允许的 batch/并发上限,以及模型配置中是否有 sliding window 或 hybrid cache。只调低 max_new_tokens 可能不够,因为输入上下文本身就可能已经占掉大部分预算。
把理论值映射到实际部署
理论公式是容量下限,不是部署配置的安全上限。Hugging Face 文档区分了 DynamicCache、StaticCache、滑动窗口缓存和 QuantizedCache:动态缓存会随序列增长,静态缓存会按最大长度预分配,滑动窗口层可以限制保存范围,量化缓存则用更低精度减少存储但可能带来延迟或实现开销。
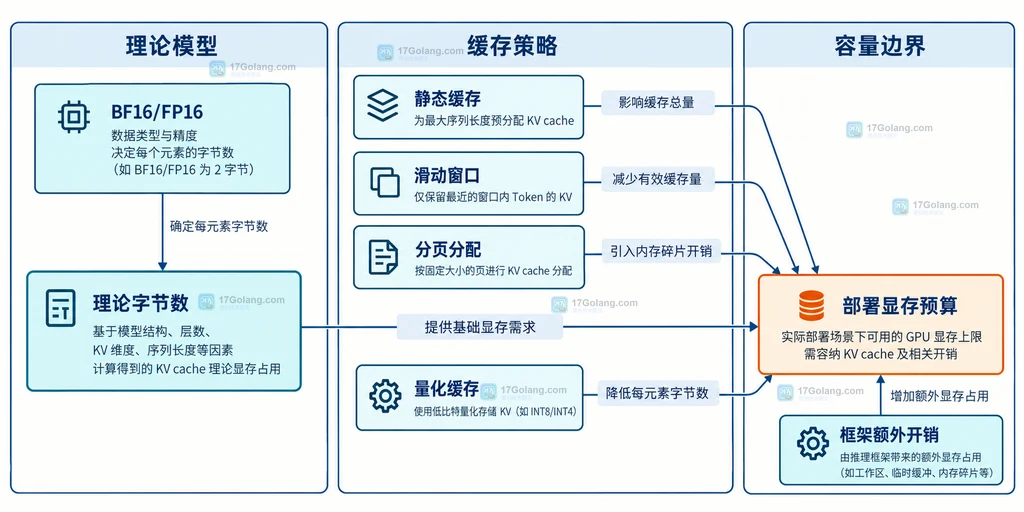
可以把部署预算拆成四层:
- 权重预算:模型参数及其加载格式先占一部分显存。
- 理论缓存预算:使用上面的公式计算 K/V 张量本身。
- 策略预算:静态缓存的最大长度、分页块的内部碎片、滑动窗口的实际窗口、量化缓存的辅助数据都会改变结果。
- 运行余量:临时激活、通信缓冲、框架元数据和分配器碎片需要保留,不能把 GPU 容量全部分给 KV cache。
如果框架支持 paged attention 或类似分页缓存,通常能改善多请求场景下的复用和碎片问题,但不会改变“每个 token 需要多少 K/V 元素”的基础数量级。它改变的是分配方式与可用率,不是把公式里的乘数凭空消掉。
显存不足时按运行手册处理
触发信号:长输入、较大 batch 或生成时间变长时出现 OOM,而短输入单请求正常。
快速判断:先记录模型层数、num_key_value_heads、head_dim、实际 token 数、batch 和 cache dtype,再按公式得到理论值;同时把权重和框架预留从缓存预算中分离出来。
处理动作:优先限制最大上下文或并发 batch;确认 GQA/MQA 的 KV 头数没有取错;如果业务允许,再评估滑动窗口、分页缓存或量化缓存。每次只改变一个容量变量,便于判断是哪一项起作用。
回退路径:量化缓存带来延迟或质量问题时,回到 BF16/FP16,并通过更小的上下文上限或 batch 保住稳定性。静态缓存造成短请求浪费时,考虑动态缓存或按业务分档的最大长度。
复盘字段:记录请求 token 分布、峰值 batch、KV dtype、缓存实现、理论 GiB、实际进程峰值、OOM 时间点和回退配置。不要只记录“显存不够”,否则下一次仍要从头猜。
几个容易混淆的问题
KV cache 会不会按生成 token 数平方增长?
缓存容量本身通常按保留 token 数线性增长;不使用缓存时,注意力计算会反复处理历史状态,计算成本和缓存容量是两个不同问题。
为什么模型权重能放下,长上下文还是 OOM?
权重是相对固定的,KV cache 会随输入和生成上下文增长,并且还要与临时激活、框架缓冲共享 GPU 显存。能加载权重不代表能承受目标上下文和并发。
FP16 和 BF16 的 KV cache 都按 2 字节算吗?
作为理论估算通常可以这样算,但最终还要以运行时缓存 dtype 和具体后端为准。量化、FP8 或混合缓存可能有额外 scale 和残差区域。
只看 hidden size 能不能估算?
不建议。hidden size 可以帮助推导 head_dim,但 GQA/MQA 的 KV 头数决定了实际 K/V 宽度;直接用 hidden size 往往会忽略头共享关系。
实际排查时,我会先把公式算成一张小表,再去看框架采用的缓存策略。这样可以很快分辨是上下文上限过大、batch 过高、KV 头数理解错误,还是把理论缓存误当成了整张 GPU 的可用空间。先用数量级做容量决策,再用运行时指标确认实现细节,通常比盲目换显卡或反复重试更有效。
 生成式回答怎样设计成对比较评测
- 上一篇
- 生成式回答怎样设计成对比较评测
- 下一篇
- 连续批处理怎样平衡首 token 延迟
-
- 科技周边 · 人工智能 | 1小时前 | 人工智能 · 可观测性 · LLM 流式响应 日志脱敏 token用量 prompt_tokens completion_tokens
- LLM 请求怎样记录 token 用量而不泄露正文
- 413浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- RAG 系统怎样隔离文档中的指令性文本
- 390浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 | 人工智能 · 语音转写 VAD 静音检测 Silero VAD
- 语音转写前怎样用 VAD 切除静音区
- 371浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- 连续批处理怎样平衡首 token 延迟
- 262浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- 生成式回答怎样设计成对比较评测
- 199浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 | rag · 向量检索 · RAG metadata filter 多租户检索
- RAG 检索怎样用元数据过滤租户内容
- 433浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- RAG 文档切片怎样设置重叠区避免语义断裂
- 297浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 510次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 570次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 594次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 547次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 364次使用
-
- CodeGeeX for Jetbrains IDEs正式上线!
- 2023-01-17 284浏览
-
- 技术阿里云实现ocr批量图片和pdf文件表格图片转换excel文档/支持票据图片提取/普通图片文字提取处理
- 2023-01-18 387浏览
-
- 直播预告|FeatureStore Meetup V2
- 2023-01-10 328浏览
-
- 深入浅出特征工程 – 基于 OpenMLDB 的实践指南(上)
- 2023-02-25 426浏览
-
- 开源机器学习数据库OpenMLDB v0.4.0产品介绍
- 2023-01-10 147浏览