
Go GJSON 大整数使用 Float 后为什么丢失精度
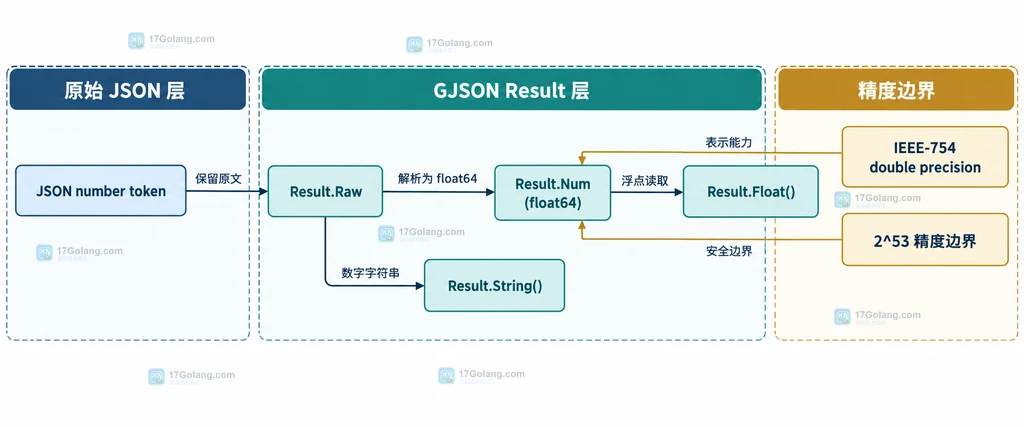
用 GJSON 读取订单号、用户 ID 或其他大整数时,直接调用 Float() 可能看到末尾数字变化。原因不是 GJSON 把 JSON 文本随机改写了,而是 Float() 返回的是 float64,大于 2^53 的整数无法全部用 IEEE-754 双精度浮点数精确表示。
官方地址:https://github.com/tidwall/gjson
如果字段是用于计算且能接受浮点语义,可以使用Float();如果它是必须保真的编号,优先保留Raw或使用String(),再按业务需要选择Int()或Uint()。不要用浮点结果反推大整数原文。
先区分原始数字和浮点结果
GJSON 的 Result 同时保留了原始片段和数值字段。官方实现中,Raw 是原始 JSON 值的文本,Num 的类型是 float64;Float() 返回的正是这个浮点字段。于是同一个 JSON 数字会同时拥有“原文”和“数值近似”两条读取路径。
| 成员 | 用途 | 对大整数的含义 |
|---|---|---|
Raw | 保留 JSON 中的原始值文本 | 适合继续做精确文本解析或记录 |
Num | Result 内部的浮点数值 | 受 float64 可表示精度限制 |
Float() | 返回浮点数 | 与 Num 使用同一套精度边界 |
String() | 返回字符串表示 | 整数原文保持数字字符时可保留原样 |
为什么 2^53 附近容易出现误差
float64 的有效整数精度边界通常用 2^53 表示。小于这个范围时,常见整数可以逐个表示;超过这个范围后,可表示的整数间隔会变大,两个相邻的十进制整数可能映射到同一个浮点值。
因此,下面这种现象并不矛盾:Result.Raw 仍然是原 JSON 中的数字文本,但 Result.Num 和 Float() 已经只能提供一个浮点近似值。精度损失发生在“把原文解析成浮点数”这一层,而不是发生在 JSON 字段定位上。
package main

import (
    "fmt"

    "github.com/tidwall/gjson"
)

func main() {
    jsonText := `{"order_id":9007199254740993}`
    result := gjson.Get(jsonText, "order_id")

    // Float 返回 float64;超过 2^53 的整数不能保证逐位精确。
    fmt.Printf("float=%v\n", result.Float())
    // Raw 保留 JSON 中的原始数字片段,适合继续做精确解析。
    fmt.Printf("raw=%s\n", result.Raw)
    // 整数形态的 String 可以作为不经过浮点格式化的文本读取入口。
    fmt.Printf("text=%s\n", result.String())
}
这里的重点不是某一台机器打印出什么具体末尾,而是读取 API 的语义不同:Float() 明确选择了浮点值,Raw 和整数形态的 String() 则能让后续逻辑继续接触数字文本。需要精确性时,应该把字段类型和读取方式一起设计。
用最小示例定位真正发生变化的路径
排查时可以把同一个 Result 的三种输出并列记录,不要只打印 Float():
func inspectNumber(jsonText string) {
    result := gjson.Get(jsonText, "order_id")

    // Type 用来确认 GJSON 识别到的是 Number,而不是字符串或 null。
    fmt.Println("type:", result.Type)
    // Raw 用来观察原始 JSON 数字,避免只看浮点格式化结果。
    fmt.Println("raw:", result.Raw)
    // Float 用来观察业务是否主动选择了 float64 语义。
    fmt.Println("float:", result.Float())
}
如果 Raw 中的十进制数字与 Float() 的输出不同,优先检查调用方是否把编号当成了测量值或比例值。订单号、雪花 ID、时间戳分位和外部系统主键通常不需要小数运算,使用浮点数只会增加转换风险。
按用途选择 Float、Int、Uint 与 Raw/String
GJSON 提供多个便捷方法,但它们不是同一个精度承诺。可以按字段用途做选择:
| 字段用途 | 优先选择 | 理由 |
|---|---|---|
| 展示或转发原始编号 | Raw 或 String() | 先保留数字字符,不主动经过浮点格式化 |
| 需要有符号整数运算 | Int() | 让 GJSON 按整数结果读取,并处理转换失败的边界 |
| 明确是非负计数 | Uint() | 表达无符号语义,避免把 ID 当作小数 |
| 金额比例、测量值或允许近似 | Float() | 字段本身需要浮点运算时再使用 |
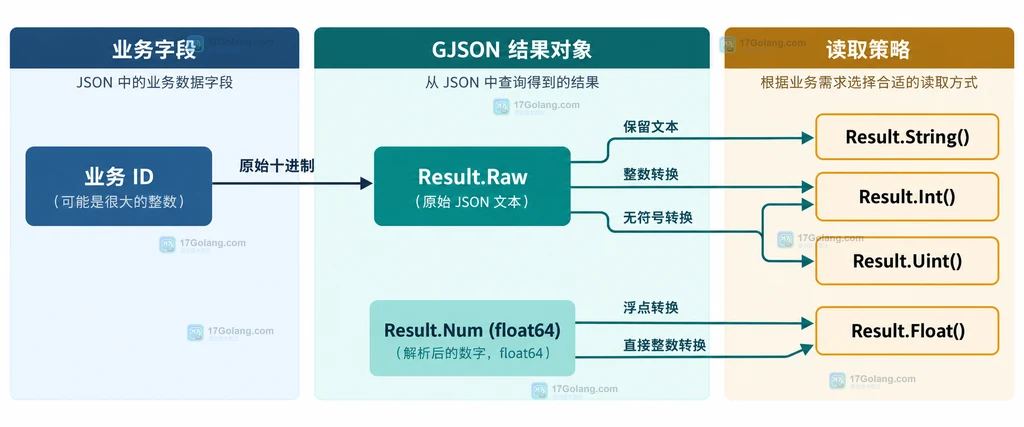
如果业务要求比 int64 或 uint64 更大的整数范围,Raw 或 String() 只是保留文本,后续仍需交给合适的高精度整数库解析。这样可以把“JSON 定位”和“数值精度策略”分成两层,避免依赖 Float() 的近似结果。
大整数字段的选择清单
- 先确认字段是编号、计数,还是确实需要小数运算的测量值。
- 编号和主键优先观察
Raw,不要只记录Float()。 - 需要整数运算时选择
Int()或Uint(),并处理转换边界。 - 需要保留原文时选择
String(),同时确认它确实是数字或字符串类型。 - 把大整数样例放进接口测试,比较原文与最终写回值,避免精度问题在下游才暴露。
常见问题
Float() 一定会把所有大整数改掉吗?
不一定。某些大整数恰好仍可表示,但不能把这种偶然结果当作通用保证。超过 2^53 后,应按字段需求选择精确文本或整数读取。
Raw 和 String() 有什么区别?
Raw 是 GJSON 结果里保存的原始 JSON 片段;String() 是便捷的字符串表示。对整数数字,GJSON 当前实现可以直接返回原始数字文本;如果字段类型复杂,仍要结合 Type 判断。
把大整数写成 JSON 字符串就不会丢精度吗?
字符串可以避开 JSON 数字到 float64 的转换,但它会改变接口字段类型。生产接口应先确认上下游约定,再决定使用字符串传输、整数解码还是保留原始数字文本。
 Go GJSON 数组条件中的单个匹配与全部匹配有什么区别
- 上一篇
- Go GJSON 数组条件中的单个匹配与全部匹配有什么区别
- 下一篇
- Go SJSON 怎么用 SetRaw 替换完整根 JSON
-
- Golang · Go问答 | 35分钟前 |
- Go Participle 增加前瞻和重写歧义语法有什么区别
- 426浏览 收藏
-
- Golang · Go问答 | 36分钟前 | Go问答 · Go 注释 ast 语法树 Participle Elide
- Go Participle 被 Elide 的注释为何不出现在语法树
- 198浏览 收藏
-
- Golang · Go问答 | 38分钟前 | go · Go 递归下降解析器 Participle 左递归
- Go Participle 左递归语法为什么无法直接解析
- 240浏览 收藏
-
- Golang · Go问答 | 46分钟前 |
- Go Goldmark 软换行与硬换行渲染结果有什么区别
- 161浏览 收藏
-
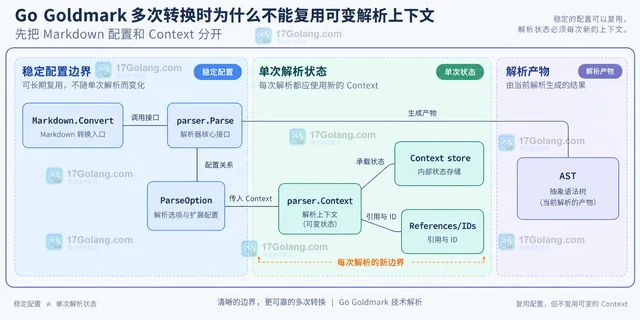
- Golang · Go问答 | 47分钟前 | Markdown · Go问答 · Go Goldmark parser.Context Markdown 转换 解析上下文 状态复用
- Go Goldmark 多次转换时为什么不能复用可变解析上下文
- 252浏览 收藏
-
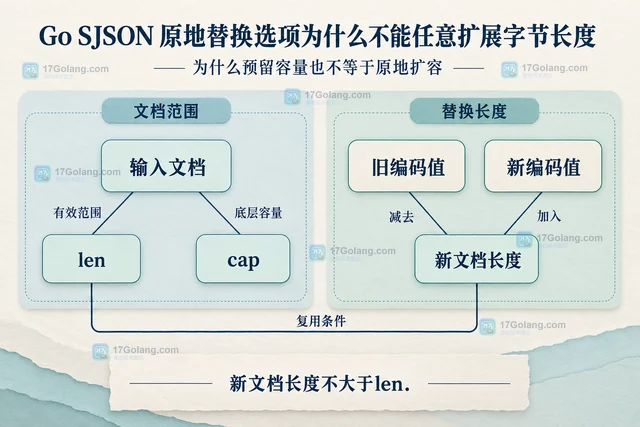
- Golang · Go问答 | 58分钟前 |
- Go SJSON 原地替换选项为什么不能任意扩展字节长度
- 473浏览 收藏
-
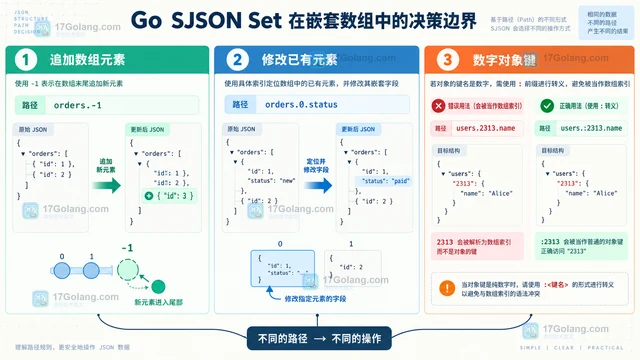
- Golang · Go问答 | 1小时前 |
- Go SJSON 数组末尾追加元素时路径应该怎么写
- 408浏览 收藏
-
- Golang · Go问答 | 1小时前 |
- Go GJSON 数组条件中的单个匹配与全部匹配有什么区别
- 242浏览 收藏
-
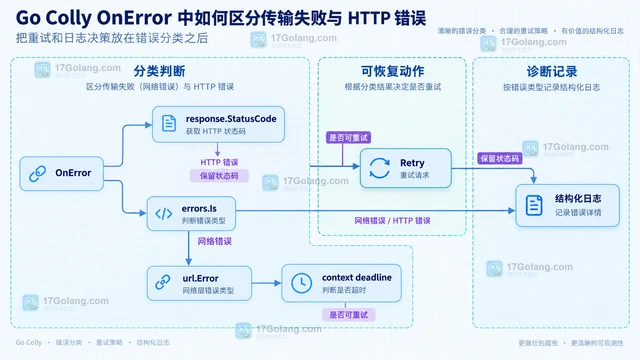
- Golang · Go问答 | 1小时前 |
- Go Colly OnError 中如何区分传输失败与 HTTP 错误
- 485浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 460次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 521次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 539次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 488次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 307次使用
-
- 接口返回 200 但前端仍报错怎么办:从响应格式到跨域一步步排查
- 2026-06-14 332浏览
-
- Go map 并发写 panic 怎么办:从共享 map 到可控写入路径
- 2026-06-30 123浏览
-
- golang生成JSON以及解析JSON
- 2023-01-17 329浏览
-
- Go如何实现json字符串与各类struct相互转换
- 2023-01-07 377浏览
-
- Go中使用gjson来操作JSON数据的实现
- 2023-01-07 141浏览


