Go 入门
  掌握 goquery 的文本提取
我第一次用 goquery 读取文章卡片标题时,选中的是外层容器,结果拿到的却不只是卡片自己的那一行,而是标题、摘要和嵌套标签里的文字拼在一起。这个结果并不是选择器失效,而是 Selection.Text() 的定义本来就包含后代节点:它会从选中的节点开始递归访问子树,只把遇到的文本节点追加到字符串中。
官方地址:https://github.com/PuerkitoBio/goquery
所以,标题《Go goquery Text 为什么包含子节点中的全部文字》的直接答案是:你选中的元素是一个父节点,Text() 取的是这棵子树的文本内容,不是元素标签直属的那一层文字。要改变结果,应该缩小选择器,或者改用带文本策略的 API。
把 Text() 理解成“读取选中节点及其后代的纯文本”就不会意外。它不会返回 HTML 标签,也不会只保留父元素的直接文本;多个选中节点还会继续按选择顺序合并。
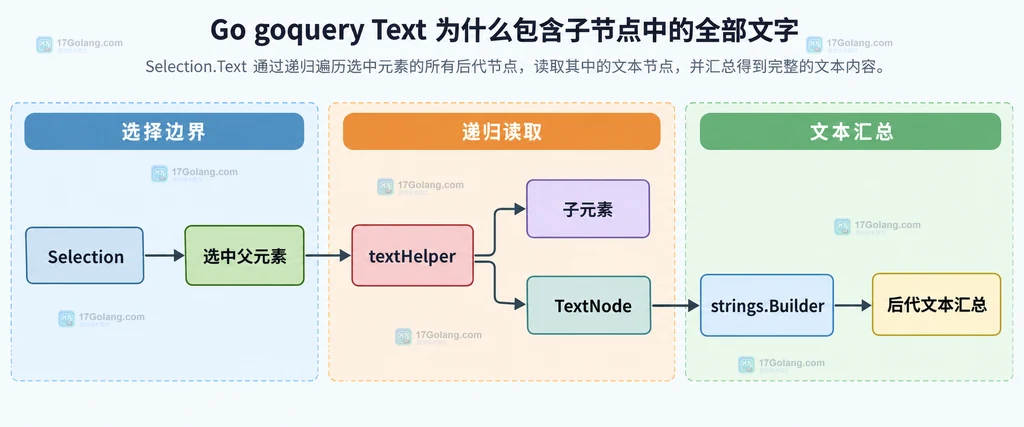
goquery 的选择结果是一个 *Selection,其中可以包含一个或多个 HTML 节点。调用 Selection.Text() 时,库会遍历选择中的每个节点;遇到文本节点就写入结果,遇到元素节点则继续访问它的子节点。因此,父元素、子元素和文字之间是“选择边界—递归读取—文本汇总”的关系。
例如,下面的 HTML 中,article 是父节点,h2、p 和 strong 都在它的后代树里:
Go 入门
掌握 goquery 的文本提取
此时选中 .card,目标是整个卡片的可见文本;选中 .card h2,目标才收窄为标题。真正决定范围的是选择器,Text() 只忠实处理这个范围内的文本节点。
HTML 元素通常把文字放在文本节点中,而不是放在元素对象的某个“单行字段”里。父元素的直接文字、子元素中的文字,最终都属于这棵 DOM 子树。goquery 的方法名虽然简短,但语义更接近“把选中节点及后代的文字内容合并起来”。
这个行为也解释了两个常见误会:
如果目标是标题,不要先选卡片再期待 Text() 自动猜出标题字段。把选择器直接写到标题节点,通常比拿到整块文本后再切字符串更稳:
package main
import (
"fmt"
"strings"
"github.com/PuerkitoBio/goquery"
)
func readHeading(htmlText string) (string, error) {
// 从字符串创建文档;真实抓取时应先自行处理 HTTP 响应和关闭 Body。
doc, err := goquery.NewDocumentFromReader(strings.NewReader(htmlText))
if err != nil {
return "", err
}
// 选择器直接落到 h2,避免把卡片中的摘要和强调文字一并取出。
return doc.Find("article.card h2").First().Text(), nil
}
func main() {
// 示例只展示调用边界,不把本地运行输出当作文章证据。
title, err := readHeading(`Go 入门
摘要
还有一种更容易被忽略的情况:选择器本身匹配了多个节点。doc.Find("li").Text() 并不是“每个 li 返回一个字符串”,而是把选择中的节点依次交给同一个文本汇总过程。默认的 Selection.Text() 不会自动插入换行或分隔符。
因此,列表提取时要先明确输出协议。保留每项边界,就逐项遍历;确实要合成一段话,再接受合并语义:
// 逐项读取,保留每个 li 的业务边界。
doc.Find("ul.tags li").Each(func(index int, item *goquery.Selection) {
  // 单个 li 仍然会包含其后代文字,但不会吞掉其他 li。
  text := strings.TrimSpace(item.Text())
  if text != "" {
    fmt.Printf("%d: %s\n", index+1, text)
  }
})
如果结果像“第一项第二项第三项”,优先检查是否把多个节点直接调用了一次 Text()。这不是 goquery 丢了内容,而是 API 没有替你决定项目之间应该用空格、换行还是 JSON 数组表达。
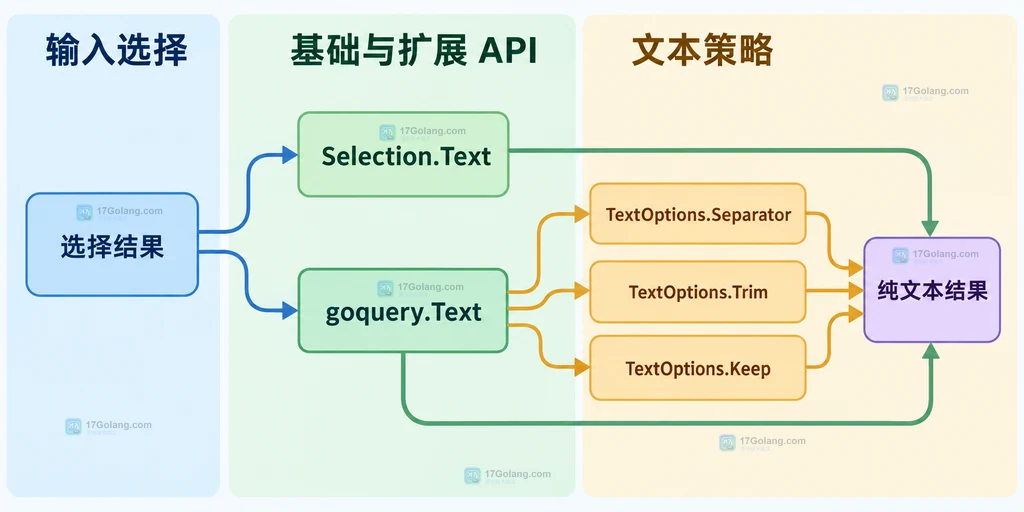
当前 goquery 还提供包级函数 goquery.Text,它的默认行为与选择的 Selection.Text() 相近,但可以通过 TextOptions 调整不同文本节点的连接方式。比如把卡片标题和段落合成更适合阅读的一行,可以设置空格分隔并修剪每个文本节点两侧的空白。
package main
import (
"fmt"
"strings"
"github.com/PuerkitoBio/goquery"
"golang.org/x/net/html"
)
func readableText(sel *goquery.Selection) string {
// Separator 负责文本节点之间的连接;Trim 避免缩进空白进入结果。
return goquery.Text(sel, &goquery.TextOptions{
Separator: " ",
Trim: true,
Keep: func(node *html.Node) bool {
// 过滤脚本和样式节点,避免把非正文内容当作文章文本。
parent := node.Parent
return parent == nil || parent.Type != html.ElementNode ||
(parent.Data != "script" && parent.Data != "style")
},
})
}
func main() {
// 文本来源仍由选择器决定,选中 card 就会覆盖它的后代文本。
doc, err := goquery.NewDocumentFromReader(strings.NewReader(`Go 入门
掌握 goquery
Separator、Trim 和 Keep 解决的是文本拼接策略,不会把父选择自动变成“只取直属文字”。如果选择器仍然是外层卡片,得到的仍是卡片后代中符合 Keep 条件的文本。
排查到这里,我通常会先问自己:下游需要的是阅读文本,还是还要知道标签结构?如果要继续判断链接、强调标签或嵌套字段,应该保留节点或使用 Html();如果只要搜索索引、摘要或日志字符串,才使用 Text(),并明确空白和分隔符规则。
| 目标 | 选择 | 关键边界 |
|---|---|---|
| 整块内容的纯文本 | Selection.Text() | 递归包含后代文本,默认不插入分隔符 |
| 可读的拼接文本 | goquery.Text | 用 TextOptions 控制分隔、修剪和过滤 |
| 单个字段 | 把选择器收窄到目标元素 | 不要先取父节点再切字符串 |
| 保留标签关系 | Html() 或继续处理节点 | 纯文本会丢失结构信息 |
最终可以记成一句话:Text() 的“全部文字”不是额外抓取,而是选中节点子树的自然结果。选择器负责边界,Text API 负责汇总,业务代码负责决定字段和分隔规则。
因为它只写入文本节点的数据,元素标签只是遍历结构,不会作为字符串内容追加。
用更窄的选择器,或使用带 Keep 函数的 goquery.Text,按父节点过滤脚本和样式文本节点。
多个节点被放进同一个 Selection 后,默认 Text 不负责推断项目分隔符;需要保留边界时逐项读取,需要连接时显式设置 Separator。
 Go goquery 怎么移除副本中的节点而保留原文档