
Stack Overflow 2026 调查中的 AI 信任与开发实践
Stack Overflow 发布的 2026 年开发者调查,给出了一个比“大家都在用 AI”更值得关注的结论:开发者并没有把信任一次性移交给模型,而是把信任拆成了几个可以检查的条件。调查收到来自 169 个国家和地区的超过 3 万份回答;编码助手或编码代理的使用比例为 66%,通用聊天工具为 63%。
官方调查入口:https://survey.stackoverflow.co/2026/
- 48.0% 的受访者表示,只有在能够轻松验证输出时才信任 AI。
- 项目目标、需求、代码库和技术文档,是最值得提供给 AI 的工作上下文。
- 本地运行、对照代码库、检查测试与安全,比“看起来写得对”更接近真实的复核闭环。
AI 已经常用,但信任变成了条件判断
调查里最容易被忽略的数字是 6.6%:只有这一比例的受访者愿意把 AI 用于“包括重要工作决策在内的许多任务”。相比之下,48.0% 的人选择“能轻松验证输出时才信任”,另有 16.3% 只把它用于不重要的工作或低风险任务。
这不是开发者拒绝 AI,而是使用边界变得更清楚。熟悉代码、调试、重构、测试和直接的技术问题,通常有明确的输入、输出和检查方式;部署、生产故障判断、合规承诺或面向客户的沟通,则需要更多背景和责任归属。调查页面也显示,熟悉领域代码生成、调试与重构是最常见的 AI 使用场景,而涉及沟通与创意表达的使用明显更谨慎。
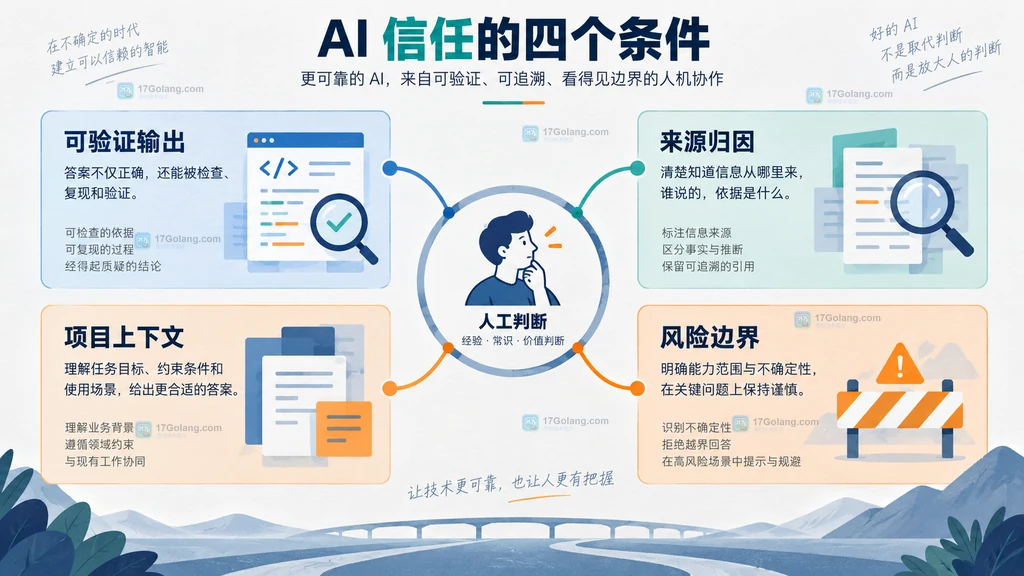
来源归因和项目上下文,决定答案能不能进入代码库
开发者对“答案从哪里来”非常敏感。Stack Overflow 的知识专题显示,93% 的受访者认为来源归因至少有些重要,79% 认为重要或非常重要。这个结果对应到日常开发,就是不要只保存一段模型生成的结论,还要保留它依据的官方文档、代码位置、需求约束和版本背景。
调查把工作上下文排出了清晰顺序:项目目标或需求占 85.2%,代码库、仓库或技术文档占 73.3%,历史决策和理由占 44.0%。这解释了为什么“把一段孤立报错贴给模型”经常只能得到泛化建议:模型缺少真正决定方案的边界。
一个实用的上下文包可以很小,但要有结构:先写任务目标和不能改变的约束,再给出相关目录、接口契约、失败日志和已有测试,最后附上官方资料入口。这样做的价值不在于让提示词变长,而在于让 AI 的答案有机会被团队复盘。
调查数据应该怎样落到开发流程
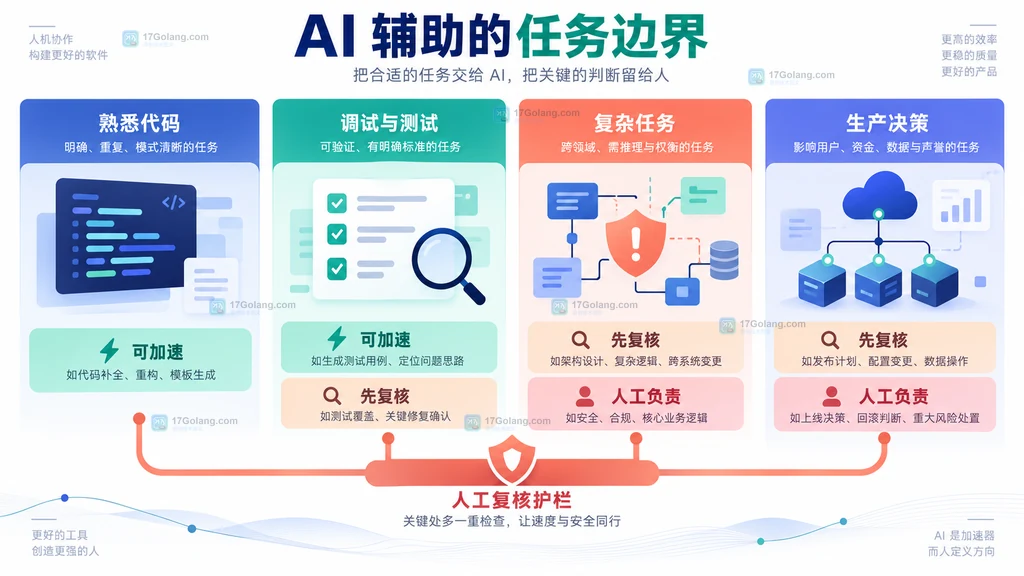
把 AI 当作“能快速提出候选方案的协作者”,比把它当作最终签字人更符合这份调查。可以按任务的可验证性和风险分成三档:
| 开发场景 | 适合的 AI 角色 | 进入主分支前的人工检查 |
|---|---|---|
| 熟悉模块中的样板代码 | 生成初稿、补全边界分支 | 对照项目约定并运行单元测试 |
| 调试、重构和测试 | 提出假设、改写局部实现 | 复现问题,检查回归、异常路径和资源释放 |
| 陌生代码库或复杂跨模块改动 | 整理依赖、列出待确认问题 | 由熟悉业务的人确认上下文和设计后再落地 |
| 生产发布、合规和客户沟通 | 辅助汇总材料,不替代判断 | 明确负责人,保留审批、监控和回滚依据 |
别只看工具热度,先看输出质量和工作流适配
工具选择也反映了这种“有条件的信任”。调查中,过去一年更换 AI 工具的人,最主要的原因是输出质量更好,占 25.1%;组织要求或推荐另一款工具占 10.6%,更好地融入工作流或开发环境占 7.4%,因为价格更低而更换占 6.4%。
因此,团队评估工具时可以先问四个问题:它能否稳定处理本团队最常见的任务?输出是否容易在本地和测试体系中复核?它能否读取合适的项目上下文而不越过权限边界?最后才是成本是否可接受。只用排行榜或演示效果做决定,无法覆盖真正的维护成本。
调查还显示,收到 AI 开发答案后,76.5% 的受访者会先在本地运行,63.9% 会与代码库上下文对照,53.0% 会检查测试或安全影响,38.0% 会阅读官方文档,直接照用的只有 9.6%。这套顺序值得直接写进团队约定:先复现,再比较,再查依据,最后才合并。
把“信任 AI”改写成可复查的团队规则
这份调查对开发团队最有用的地方,不是告诉大家应该选择哪一家模型,而是给出了一个可执行的判断框架。低风险、可测试的工作可以让 AI 加速;高风险、跨边界和面向人的决定必须保留负责人。每次采纳 AI 输出时,至少留下任务上下文、来源依据、测试结果和人工决定。
当答案无法验证时,不要用更肯定的语气掩盖不确定性;当代码能运行但解释不清时,也不要把“通过一次测试”当成完整证明。AI 的效率来自缩短探索时间,工程质量仍来自可复现的检查和清晰的责任边界。
相关问题
为什么 AI 写熟悉代码时更容易获得信任?
因为团队已有命名约定、测试、依赖关系和预期结果,生成内容可以快速被对照和运行。上下文越清楚,人工复核的成本越低。
来源归因为什么会影响 AI 工具的采用?
来源能帮助开发者判断答案是否适用于当前版本和场景,也方便在出现差异时回到官方文档、代码或历史决策继续排查。
AI 生成的代码能不能直接合并?
只有在变更范围低风险、测试覆盖充分、依赖和安全影响已经检查,并且有明确负责人复核时才适合合并。调查数据表明,直接照用不是主流做法。
 RWMutex 写锁升级导致阻塞时的改造方案
- 上一篇
- RWMutex 写锁升级导致阻塞时的改造方案
- 下一篇
- OnceValue 初始化错误缓存后的恢复策略
-
- 科技周边 · 业界新闻 | 2小时前 |
- DeepSeek 与华为 Ascend 工具开源后的算力协作模式
- 145浏览 收藏
-
- 科技周边 · 业界新闻 | 3小时前 |
- Google 开源周报中的 MCP Dev Summit 议题变化
- 273浏览 收藏
-
- 科技周边 · 业界新闻 | 4小时前 | 云原生 · MySQL · postgresql · 业界新闻 · mysql PostgreSQL AI应用 混合云 开源数据库 All Things Open 2026 DocumentDB
- 微软 All Things Open 2026 展示的开源数据库方向
- 366浏览 收藏
-
- 科技周边 · 业界新闻 | 5小时前 | python · typescript · 开发工具 · AI编程 · 工程实践 · 业界新闻 · TypeScript Python 开源生态 开发者工具 GitHub Octoverse AI开发工具
- GitHub Octoverse 2026 透露的 AI 开发工具变化
- 169浏览 收藏
-
- 科技周边 · 业界新闻 | 6小时前 |
- Python 3.15 lazy imports 对启动时间的工程意义
- 181浏览 收藏
-
- 科技周边 · 业界新闻 | 7小时前 |
- Python 3.15 UTF-8 默认编码迁移时的兼容重点
- 243浏览 收藏
-
- 科技周边 · 业界新闻 | 7小时前 | Redis · 开源软件 · Redis OSS AWS Marketplace Amazon EC2 Redis Cloud AMI 自主管理
- Redis OSS 上架 AWS Marketplace 后的部署选择
- 228浏览 收藏
-
- 科技周边 · 业界新闻 | 8小时前 |
- Redis 8.10 Compact Hash 对内存型数据结构的影响
- 180浏览 收藏
-
- 科技周边 · 业界新闻 | 9小时前 |
- Google EnvHarness 开源后 AI 评测沙箱的设计方向
- 246浏览 收藏
-
- 科技周边 · 业界新闻 | 13小时前 | go ·
- Go 1.27 平台无关 SIMD API 的适用架构范围
- 101浏览 收藏
-
- 科技周边 · 业界新闻 | 16小时前 |
- Redis 官方 FastAPI SDK 发布后的 Python 应用接入路径
- 385浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 409次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 487次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 495次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 443次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 271次使用
-
- CodeGeeX for Jetbrains IDEs正式上线!
- 2023-01-17 284浏览
-
- 技术阿里云实现ocr批量图片和pdf文件表格图片转换excel文档/支持票据图片提取/普通图片文字提取处理
- 2023-01-18 387浏览
-
- 直播预告|FeatureStore Meetup V2
- 2023-01-10 328浏览
-
- 深入浅出特征工程 – 基于 OpenMLDB 的实践指南(上)
- 2023-02-25 426浏览
-
- 开源机器学习数据库OpenMLDB v0.4.0产品介绍
- 2023-01-10 147浏览


