
Goroutine 数量持续上涨却没有报错,如何定位泄漏入口
Goroutine 数量持续上涨却没有报错,通常不是“运行时没有发现问题”,而是泄漏恰好没有触发 Go 能主动报告的故障。被卡住的 Goroutine 仍然是合法的运行时对象:它可以安静地等在 channel、网络读写、锁、ticker 或永远不会结束的重试循环上。真正有效的定位方法不是盯一眼总数,而是把增长趋势、等待堆栈、创建入口和退出条件连起来。
官方文档中,runtime.NumGoroutine 返回当前存在的 Goroutine 数量;runtime/metrics 的 /sched/goroutines:goroutines 表示存活 Goroutine 数量。诊断端点和参数可参考 https://pkg.go.dev/net/http/pprof,运行时指标目录可参考 https://pkg.go.dev/runtime/metrics。结论先说:先证明某一类堆栈在增长,再回到创建它的代码寻找缺失的退出协议。
先确认增长不是短时波峰
Goroutine 总数上升并不自动等于泄漏。请求突增、批处理启动、连接池重建、下游抖动都会让并发数短时抬高。诊断时至少要把 Goroutine 数量与请求速率、当前连接数、待处理任务数放在同一时间窗口中。最值得警惕的信号是:流量已经回落,队列已经清空,但 Goroutine 数量仍停在新的高位,并且每次业务波峰都会把基线再推高一截。
package observe

import "runtime/metrics"

func goroutineCount() uint64 {
    samples := []metrics.Sample{{
        // 读取 Go 运行时维护的存活 Goroutine 数量。
        Name: "/sched/goroutines:goroutines",
    }}
    metrics.Read(samples)
    return samples[0].Value.Uint64()
}
如果现有监控体系不方便接入 runtime/metrics,使用 runtime.NumGoroutine() 也能获得当前值。关键不在 API 选择,而在采样方式:用固定周期记录趋势,同时保留 QPS、队列长度和下游耗时作为上下文。不要把某个绝对阈值硬编码成所有服务共用的泄漏标准,网关、消费者和定时任务的正常基线并不相同。
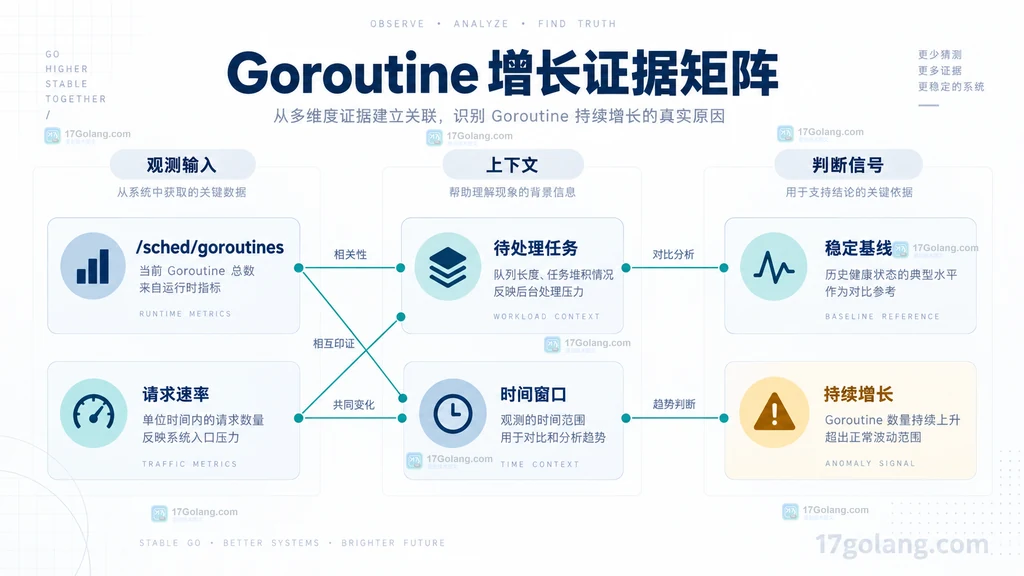
图1:Goroutine 增长证据矩阵。总数只有和流量、积压、时间窗口及回落基线一起观察,才有诊断意义。
把 pprof 放在受控边界内
net/http/pprof 会通过 HTTP 提供运行时分析数据,相关路径以 /debug/pprof/ 开头。它是诊断入口,不应直接暴露给公网。最简单的做法是仅绑定回环地址,再通过主机权限、堡垒机或临时端口转发访问。使用自定义 ServeMux 时,需要显式注册处理器。
package diagnostic

import (
    "net/http"
    httppprof "net/http/pprof"
    "time"
)

func NewServer() *http.Server {
    mux := http.NewServeMux()
    // 自定义 ServeMux 不会自动获得 pprof 路由,按需注册。
    mux.HandleFunc("/debug/pprof/", httppprof.Index)
    mux.Handle("/debug/pprof/goroutine", httppprof.Handler("goroutine"))

    return &http.Server{
        // 只监听本机,避免把运行时信息直接暴露到公网。
        Addr:              "127.0.0.1:6060",
        Handler:           mux,
        ReadHeaderTimeout: 5 * time.Second,
    }
}
生产环境还应把诊断服务和业务服务分开管理,限制访问者、记录开启时段,并在排查结束后关闭临时通道。Goroutine 堆栈可能包含函数名、路径和业务结构信息,安全边界不能因为“只是调试接口”而降低。
用两个时点找出增长的堆栈簇
一次快照只能告诉你“现在有哪些 Goroutine”,很难告诉你“哪一类正在泄漏”。应在负载相近的两个时点各采集一份 Goroutine profile。官方文档说明,debug=2 会以未恢复 panic 时类似的格式输出 Goroutine 堆栈,适合直接阅读等待状态与调用链。
# 第一次采集:记录当前等待状态和业务栈。
curl -o goroutine-a.txt \
  'http://127.0.0.1:6060/debug/pprof/goroutine?debug=2'

# 保持相近业务负载,让泄漏簇有时间继续增长。
sleep 30

# 第二次采集:与第一份按等待原因和业务栈顶比较。
curl -o goroutine-b.txt \
  'http://127.0.0.1:6060/debug/pprof/goroutine?debug=2'
比较时不要逐行看 Goroutine 编号,而要按“等待原因 + 前几层业务函数”聚类。例如,同样停在 chan send、栈顶都落到 worker.publishResult 的 300 个 Goroutine,应视为一个堆栈簇。两个时点之间,如果这个簇从 300 增长到 520,而请求速率没有同比增长,它就比一个始终稳定的数据库连接维护 Goroutine 更值得优先调查。
常见等待原因可以帮助缩小方向,但不能代替代码归因:
chan send:发送方找不到接收方,或下游已经提前返回。chan receive:等待一个永远不会关闭或再写入的 channel。IO wait:网络操作缺少超时,或取消信号没有传递到请求。select:循环只有业务分支,没有ctx.Done()等退出分支。sync.Cond、锁等待:唤醒条件、解锁路径或持锁范围出现异常。
从堆栈簇反推创建入口
堆栈显示的是“它现在卡在哪里”,泄漏原因却经常位于更上游:谁创建了这个 Goroutine,谁拥有它依赖的 channel、连接或 ticker,调用方退出时谁负责通知它停止?把这四个问题写在一起,定位会明显加快。
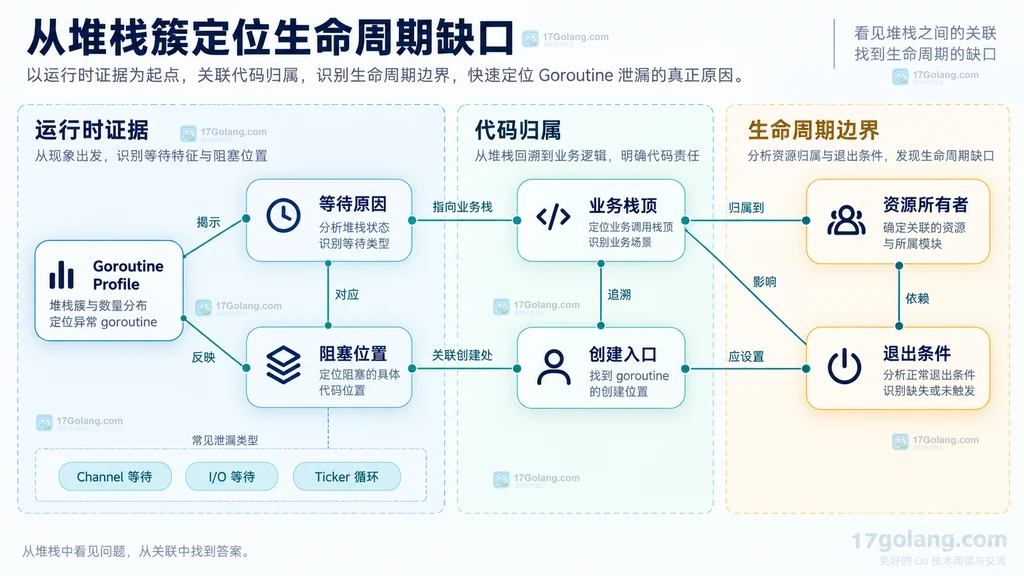
图2:堆栈与生命周期归因图。真正的修复点通常不是等待语句本身,而是上游缺失的取消、关闭或回收责任。
一个典型问题是:函数启动 Goroutine 计算结果,却返回一个无缓冲 channel。调用方超时后不再接收,后台 Goroutine 最终永久阻塞在发送处。看堆栈只能看到 ch ,但责任边界在 API 设计:后台任务没有继承调用方的取消信号,发送也没有退出分支。
type Result struct {
    Value string
    Err   error
}

func startLookup(ctx context.Context, key string)
这里的缓冲不是万能修复。如果生产速度可以无限超过消费速度,扩大 channel 只会延迟泄漏表现。更稳妥的设计是同时明确容量、背压、取消和关闭责任。对长期 worker,还应让创建者持有 cancel,并在关闭阶段通过 WaitGroup 或等价机制等待退出。
四类高频入口与对应边界
1. Channel 两端生命周期不对称
发送方和接收方由不同组件管理时,最容易出现一端退出、另一端仍等待。检查 channel 由谁创建、由谁关闭、关闭后谁停止发送。通常由发送方关闭 channel;接收方不应为了“解卡”随意关闭自己不拥有的 channel。
2. Ticker 启动后没有停止协议
time.Ticker 往往包在永久循环里。如果只调用 ticker.Stop(),但循环没有取消分支,Goroutine 仍可能一直等在 ticker channel 上。循环本身必须监听上下文或显式 done channel。
func runRefresh(ctx context.Context, interval time.Duration) {
    ticker := time.NewTicker(interval)
    defer ticker.Stop()

    for {
        select {
        case
3. I/O 只有发起,没有截止时间
HTTP、数据库、消息系统和自定义 TCP 客户端都要检查超时是否真正下沉到阻塞操作。仅在外层记录“请求超时”不够;如果底层仍使用脱离父级的背景上下文,调用方返回后 I/O Goroutine 仍会存活。优先传递父级 context.Context,同时设置客户端级超时和连接级截止时间。
4. 重试每次都创建新 Goroutine
某些重试实现会在失败后启动新的 Goroutine,而旧 Goroutine 仍等着结果或定时器。数量增长看似缓慢,却会在下游长期故障时持续累积。重试应由一个受控循环承担,设置最大次数、总截止时间和退避上限,不要用递归式“再启动一个后台任务”转移所有权。
修复时采用统一的生命周期协议
定位入口后,不要只在阻塞语句旁加一个默认分支。默认分支可能把永久阻塞变成忙循环,反而增加 CPU。更可靠的修复可以归纳为四个问题:
- 谁创建:创建者必须知道后台任务何时不再需要。
- 谁取消:请求级工作继承请求上下文,组件级工作由组件持有取消函数。
- 谁关闭:资源所有者负责关闭 channel、连接、ticker 或任务队列。
- 谁等待:关闭流程等待后台任务真正退出,不能只发信号就立即丢弃对象。
对于 worker 池,容量必须有上限;对于 fan-out,子任务数量必须可控;对于结果回传,每个发送路径都要能感知取消;对于外部 I/O,必须有超时。这样做的收益不仅是消除泄漏,也让停机、扩缩容和故障恢复更可预测。
观察指标决定修复是否成立
修复完成后仍要用同样的业务场景复测。理想结果不是 Goroutine 数量永远不变,而是它随负载上升、在任务完成后回到可解释的稳定区间。至少观察下面四项:
- 流量回落后,
/sched/goroutines:goroutines是否回到历史基线附近。 - 原先增长的堆栈簇是否停止累积,等待原因是否消失或保持稳定。
- 关闭组件时,等待组能否在预期时间内归零。
- 下游超时、取消和队列满时,任务是否按设计失败,而不是转入后台悬挂。
最后,把 Goroutine 趋势、关键队列长度和取消/超时计数加入长期监控,并为组件关闭写回归测试。Goroutine 泄漏通常不会在错误日志里主动自报家门,但它会留下稳定的证据链:基线被抬高、某个等待堆栈簇持续增长、创建者没有兑现退出责任。沿着这条链路排查,比反复猜测某个函数是否“看起来会泄漏”更快,也更容易验证。
 StructuredTaskScope 如何表达并发任务的共同生命周期
- 上一篇
- StructuredTaskScope 如何表达并发任务的共同生命周期
- 下一篇
- asyncio TaskGroup 让并发任务在首错时一起收敛
-
- Golang · Go问答 | 23分钟前 |
- 无缓冲和有缓冲 Channel 的选择应看吞吐还是同步语义
- 421浏览 收藏
-
- Golang · Go问答 | 48分钟前 | channel · panic · 并发编程 · Go问答 · 并发安全 go channel关闭 send on closed channel Golang panic Channel关闭权 多生产者
- 向已关闭 Channel 发送为什么会 panic,关闭权应归谁
- 156浏览 收藏
-
- Golang · Go问答 | 1小时前 | 并发 · channel · goroutine · go · Context · context 并发限制 工作池 Go channel worker pool Goroutine生命周期
- 任务数很多时应该每任务一个协程还是固定工作池
- 458浏览 收藏
-
- Golang · Go问答 | 2小时前 | JSON · go · json.Unmarshal UseNumber json.Number Go JSON处理
- json.Unmarshal 为什么会把大整数变成浮点数,怎样保留精度
- 273浏览 收藏
-
- Golang · Go问答 | 3小时前 | go · 文件上传 · 流式处理 · 内存优化 · net/http · 流式读取 ParseMultipartForm Go HTTP服务 MaxBytesReader Go大文件上传 MultipartReader
- 大文件上传占满内存通常错在哪里,何时应流式读取
- 141浏览 收藏
-
- Golang · Go问答 | 3小时前 |
- 优雅停机时新请求为何还会进入,怎样关闭监听并等待在途请求
- 232浏览 收藏
-
- Golang · Go问答 | 3小时前 |
- HTTP Server 的读超时、写超时和空闲超时分别保护什么
- 128浏览 收藏
-
- Golang · Go问答 | 4小时前 | net/http · Go问答 · 性能边界 · 高并发 连接池 http.Transport Go HTTP客户端 http.DefaultClient
- 默认 Client 能否直接用于高并发服务,连接池边界怎么判断
- 151浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 360次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 417次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 430次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 383次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 208次使用
-
- Go map 并发写 panic 怎么办:从共享 map 到可控写入路径
- 2026-06-30 123浏览
-
- Go保证并发安全底层实现详解
- 2023-02-24 417浏览
-
- Go语言开发保证并发安全实例详解
- 2023-01-07 328浏览
-
- Golang 手写一个简单的并发任务 manager
- 2022-12-23 367浏览
-
- Go语言使用goroutine及通道实现并发详解
- 2023-01-02 221浏览


