
人类基准反应测试文字记忆怎么测?Seen/New规则、三次失误与成绩边界
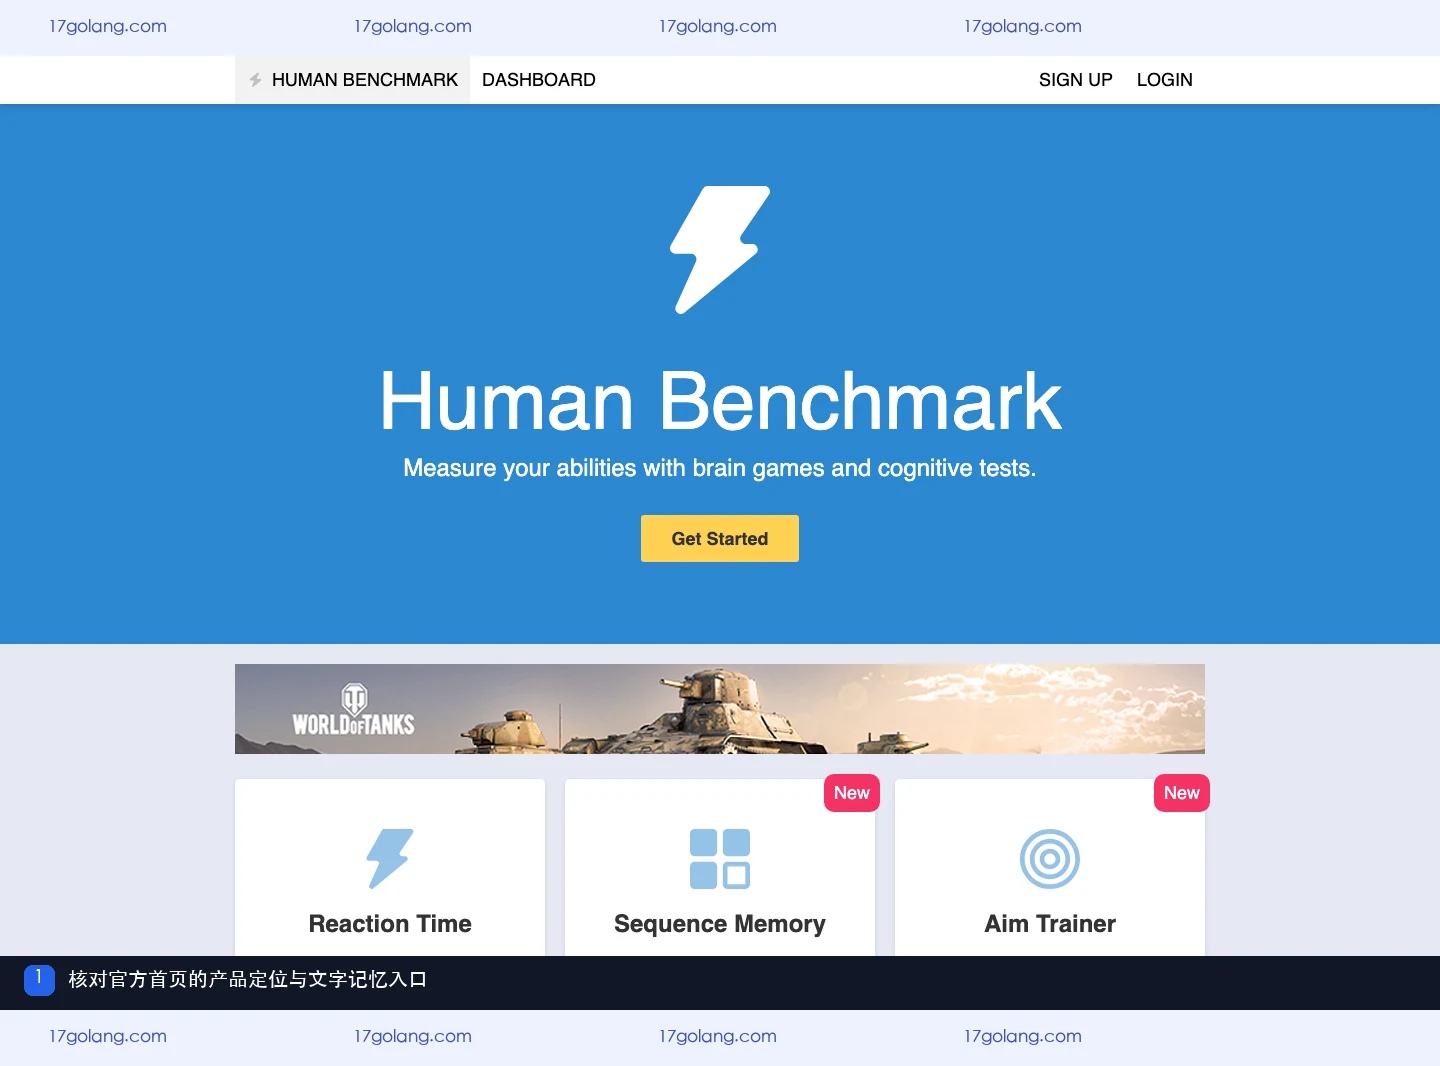
人类基准反应测试可以从官方站点 https://humanbenchmark.com/ 进入,首页把 Human Benchmark 定位为脑力游戏与认知测试集合;如果这次想了解文字记忆,而不是反应时间项目,可以打开其中的 Verbal Memory 测试页。
文字记忆项目的核心不是比较谁“更聪明”,而是按页面规则判断一个单词是否见过,并观察自己在逐步增加的记忆负担下能坚持多少回合。
- 官方首页把 Verbal Memory 列为“尽可能记住更多短期记忆单词”的项目。
- 测试中单词逐个出现,需要在 Seen 和 New 之间作出判断。
- 官方说明记忆负担会持续增加,累计三次失误后结束。
- 成绩表示坚持的回合数,适合做同一设备和相近状态下的个人记录。
人类基准反应测试的官方入口与项目定位
人类基准反应测试常被用来泛指 Human Benchmark 的网页测试集合,但官方首页实际包含多个项目。首页列出了 Reaction、Sequence、Aim Trainer、Number Memory、Verbal Memory、Chimp Test、Visual Memory 和 Typing 等入口,因此“反应测试”不等于只有鼠标反应速度一项。进入时建议确认地址栏是 https://humanbenchmark.com/,再从页面中的项目名称进入,避免把搜索结果中的仿站页面当成原始入口。
文字记忆测试的 Seen/New 规则
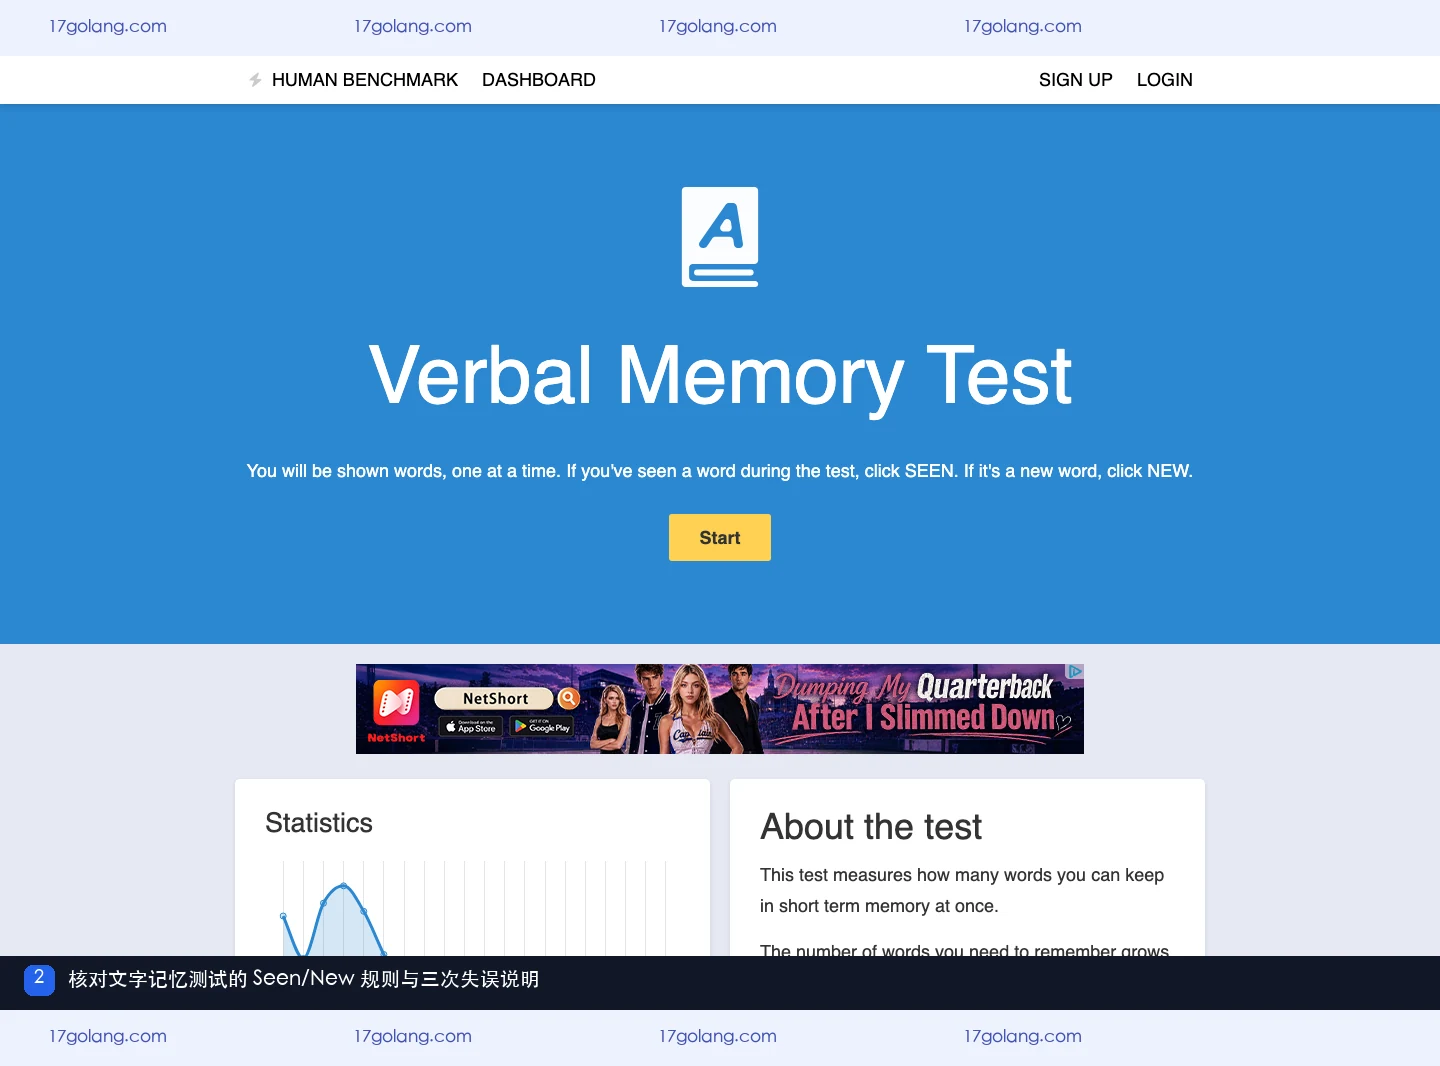
打开官方 Verbal Memory 页面后,单词会逐个显示。页面给出的操作规则很直接:如果单词在本轮此前出现过,选择 Seen;如果是第一次出现,选择 New。它考察的是对已经出现词条的短时保持和识别,不能把某个词“看起来熟悉”当成已经在本轮出现过。
页面还说明,随着测试继续,需要记住的单词数量会不断增加。实际记录时,最好先理解按钮含义,再按页面节奏作答;不要因为追求更高分而连续快速点击,也不要把浏览器刷新、脚本代答或伪造记录当成测试成绩。
三次失误和成绩应该怎样理解
官方说明累计三次失误会结束游戏,分数记录的是坚持了多少回合。这个口径和反应时间项目的毫秒数不同,也不能直接与别人的分数做脱离设备、疲劳和注意力状态的绝对比较。更稳妥的做法是固定浏览器和输入方式,在相近状态下多次记录,再观察个人变化。
文字记忆成绩也不等于医学、心理或智力诊断。一次结果会受到熟悉度、注意力、输入延迟和当时状态影响。如果页面显示异常、按钮没有响应或记录没有保存,应先检查网络和浏览器加载状态,必要时重新打开官方测试页。
常见问题:人类基准反应测试文字记忆 FAQ
文字记忆测试是反应速度测试吗?
不是同一个项目。Human Benchmark 首页把 Reaction Time 和 Verbal Memory 分开列出;文字记忆项目的主要判断是单词是否出现过,成绩按坚持回合数记录。
Seen 和 New 应该怎么选?
本轮此前出现过的单词选 Seen,第一次出现的单词选 New。判断依据是当前测试中的出现记录,而不是单词本身是否常见。
三次失误后还能继续累加吗?
官方说明三次失误后游戏结束。结束后的分数只能作为本轮结果,想比较个人变化时应重新开始一轮并保持条件尽量一致。
这个分数能证明记忆力好坏吗?
不能。它是一个网页项目的回合数结果,适合做轻量的自我观察,不应替代专业测评或健康判断。
 artworkout遇到问题怎么联系支持?帮助入口与退款渠道说明
- 上一篇
- artworkout遇到问题怎么联系支持?帮助入口与退款渠道说明
- 下一篇
- Go go fix 怎么只检查指定模块里的现代化改写
-
- 文章 · 常见问题 | 34分钟前 |
- 78动漫厂商页怎么看?品牌简介、条目数量与资料库筛选说明
- 163浏览 收藏
-
- 文章 · 常见问题 | 42分钟前 |
- bangumi条目搜索怎么用?精准匹配、排除词与分类筛选说明
- 122浏览 收藏
-
- 文章 · 常见问题 | 55分钟前 |
- 蛙蛙漫画隐私政策在哪里?公开资料页的权限与隐私入口怎么区分
- 447浏览 收藏
-
- 文章 · 常见问题 | 1小时前 |
- Lanerc动漫分类怎么看?软件教程、热门动漫与文章入口说明
- 257浏览 收藏
-
- 文章 · 常见问题 | 1小时前 |
- artworkout遇到问题怎么联系支持?帮助入口与退款渠道说明
- 219浏览 收藏
-
- 文章 · 常见问题 | 1小时前 |
- shizuku和接入应用怎么区分?官方包名、开发者与授权关系说明
- 370浏览 收藏
-
- 文章 · 常见问题 | 1小时前 |
- 米坛社区兑换码和已购资源怎么查?官方教程与安全边界
- 262浏览 收藏
-
- 文章 · 常见问题 | 1小时前 |
- 爱玩机工具箱账号怎么找回?邮箱、验证码与所有权核验边界说明
- 276浏览 收藏
-
- 文章 · 常见问题 | 2小时前 |
- 甲壳虫ADB助手投屏和远程控制怎么用?分辨率、码率与使用边界说明
- 256浏览 收藏
-
- 文章 · 常见问题 | 3小时前 |
- 表盘自定义工具是什么?小米手环表盘壁纸与功能指南
- 414浏览 收藏
-
- 文章 · 常见问题 | 3小时前 |
- 照妖镜个人中心有哪些功能?场景勋章与轻量工具使用说明
- 253浏览 收藏
-
- 文章 · 常见问题 | 3小时前 |
- 食品小作坊登记需要准备哪些材料
- 197浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 343次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 401次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 397次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 359次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 183次使用
-
- 诗歌本更新日志怎么看?Google Play“修复已知问题”与版本信息解读
- 2026-10-04 501浏览
-
- 新能源汽车充电站日常巡检如何记录枪口、计费和告警状态
- 2026-09-16 501浏览
-
- age动漫APP怎么下载?安卓与iOS入口、下载页和安全核对说明
- 2026-09-05 501浏览
-
- 攀岩馆举办公开攀岩赛,哪些情形需要申请高危险性体育赛事活动许可
- 2026-08-30 501浏览
-
- 2026年秋季开学时间怎么查:全国统一吗、家长看哪份通知
- 2026-08-26 501浏览


